

Jeff là gì?
Jeff là một dòng các mô hình tinh chỉnh nhỏ gọn dựa trên Qwen3.5 và Gemma 4, được thiết kế để phân loại zero-shot nhanh chóng. Bạn cung cấp một tình huống bằng ngôn ngữ tự nhiên, xác định các lựa chọn khả dụng và nhận được xác suất đã hiệu chỉnh cho từng lựa chọn chỉ qua một lượt suy luận.
Khác với mô hình sinh thông thường, Jeff không tạo ra văn bản mà ứng dụng của bạn phải phân tích. Jeff được thiết kế để đưa ra quyết định trực tiếp cho các tác vụ như định tuyến yêu cầu hỗ trợ, phát hiện ý định, kiểm duyệt, lệnh thoại và nước đi trong trò chơi. Các danh mục không nhất thiết phải xuất hiện trong dữ liệu huấn luyện, miễn là bạn mô tả chúng rõ ràng.
Jeff sử dụng cùng định dạng yêu cầu với Jev, nhưng đây là một dự án độc lập và không liên kết hoặc được TypeSafe chứng thực. Mã huấn luyện của dự án dựa trên công thức mã nguồn mở AutoJev.
Tính năng chính
- Suy luận cục bộ nhanh: Jeff-Qwen3.5-0.8B mất khoảng 22 ms cho mỗi quyết định trên RTX PRO 6000 và 28 ms trên Apple M4 Max khi sử dụng MLX trong bài benchmark được báo cáo.
- Đầu ra đã hiệu chỉnh: Mỗi quyết định bao gồm các xác suất, lựa chọn được chọn và độ tin cậy.
- Danh mục zero-shot: Các lựa chọn được mô tả tại thời điểm yêu cầu thay vì bị giới hạn trong một tập nhãn cố định.
- Ba loại câu hỏi: Sử dụng câu hỏi
choice,noulhoặcscore. - Gộp yêu cầu: Có thể trả lời cùng lúc nhiều câu hỏi độc lập về cùng một trạng thái.
- Backend cục bộ: Chạy bằng PyTorch trên GPU NVIDIA hoặc CPU, hoặc sử dụng MLX với mô hình Qwen trên Apple silicon.
- Thích ứng theo miền: Tinh chỉnh một checkpoint Jeff khi hiệu suất zero-shot chưa đáp ứng yêu cầu.
Chọn mô hình
Jeff cung cấp ba checkpoint mô hình trên Hugging Face:
- Jeff-Qwen3.5-0.8B: mô hình có 0,8 tỷ tham số với 1,7 GB trọng số 16-bit. Đây là lựa chọn cân bằng được khuyến nghị để chọn phương án nhanh.
- Jeff-Qwen3.5-2B: mô hình có 2 tỷ tham số với 4,2 GB trọng số 16-bit. Mô hình đạt điểm tổng thể cao hơn trên bảng benchmark được báo cáo nhưng chậm hơn và thận trọng hơn.
- Jeff-Gemma4-E2B: mô hình có 2 tỷ tham số hiệu dụng, 4,6 tỷ tham số được lưu trữ và 9,3 GB trọng số 16-bit. Backend MLX của dự án chỉ hỗ trợ các mô hình Qwen.
Đối với lần triển khai đầu tiên, hãy bắt đầu với Jeff-Qwen3.5-0.8B. Chỉ chuyển sang checkpoint khác sau khi đánh giá mô hình đó trên các ví dụ đại diện cho ứng dụng của bạn.
Cài đặt và tải Jeff
Kho mã sử dụng uv để đồng bộ các phần phụ thuộc và chạy lệnh. Từ thư mục dự án, hãy cài đặt các phần phụ thuộc mặc định và tải checkpoint 0.8B:
uv sync
uv run hf download mstrasser/Jeff-Qwen3.5-0.8B --local-dir checkpoints/jeff-0.8b
Checkpoint sẽ được đặt tại checkpoints/jeff-0.8b. Bạn có thể thay thế kho Hugging Face và thư mục cục bộ nếu muốn sử dụng một mô hình đã phát hành khác.
Phục vụ bằng PyTorch
Đối với GPU NVIDIA hoặc CPU, hãy khởi động máy chủ bằng backend PyTorch mặc định:
JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-servePhục vụ trên Apple silicon bằng MLX
Trên máy Mac tương thích, hãy cài đặt các phần phụ thuộc bổ sung cho Mac và chọn backend MLX. Tính năng phục vụ bằng MLX hiện có cho các checkpoint Qwen:
uv sync --extra mac
JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve
Cả hai lệnh đều cung cấp dịch vụ cục bộ trên cổng 8765.
Gửi yêu cầu phân loại đầu tiên
Một yêu cầu gồm có state mô tả tình huống và một đối tượng questions xác định một hoặc nhiều quyết định. Ví dụ sau yêu cầu Jeff định tuyến tin nhắn của khách hàng và đồng thời ước tính độc lập xem khách hàng có tức giận hay không:
curl -s localhost:8765/v1/systemone \
  -H 'content-type: application/json' \
  -d '{
    "model": "jeff-latest",
    "state": "Yêu cầu hoàn tiền: khách hàng cho biết bưu kiện đã đến trong tình trạng bị dập nát và muốn được hoàn lại tiền.",
    "questions": {
      "route": {
        "type": "choice",
        "instructions": "Đội nào nên xử lý việc này?",
        "criteria": {
          "1": "Hoàn tiền và thanh toán",
          "2": "Bưu kiện hư hỏng hoặc thất lạc",
          "3": "Sự cố tài khoản và đăng nhập"
        }
      },
      "angry": {
        "type": "noul",
        "instructions": "Khách hàng có tức giận không?"
      }
    }
  }'
Jeff đánh giá cả hai câu hỏi trong một yêu cầu. Mỗi câu trả lời cung cấp các xác suất, lựa chọn được chọn và giá trị độ tin cậy. Ứng dụng của bạn có thể sử dụng trực tiếp câu trả lời đã chọn hoặc áp dụng ngưỡng độ tin cậy riêng.
Tìm hiểu các loại câu hỏi
Choice
Câu hỏi choice chọn một trong tối đa 255 lựa chọn. Đặt các mã định danh ngắn trong criteria và sử dụng các giá trị tương ứng để giải thích ý nghĩa của các lựa chọn.
"route": {
  "type": "choice",
  "instructions": "Đội nào nên xử lý việc này?",
  "criteria": {
    "1": "Hoàn tiền và thanh toán",
    "2": "Bưu kiện hư hỏng hoặc thất lạc",
    "3": "Sự cố tài khoản và đăng nhập"
  }
}
Noul
Một câu hỏi noul biểu diễn một quyết định có hoặc không, được trả về dưới dạng xác suất. Nó hữu ích cho các kiểm tra như tin nhắn có tức giận, khẩn cấp, không an toàn hoặc liên quan hay không.
"angry": {
  "type": "noul",
  "instructions": "Khách hàng có đang tức giận không?"
}
Điểm số
Một câu hỏi score đặt câu trả lời trên một thang điểm do bạn mô tả. Hãy dùng nó khi ứng dụng cần một đánh giá theo mức độ thay vì một nhãn phân loại.
Viết prompt quyết định hiệu quả
Cách diễn đạt prompt ảnh hưởng đáng kể đến các bộ phân loại nhỏ. Những thực hành sau đặc biệt quan trọng khi sử dụng Jeff.
- Suy luận bằng mã và đưa ra quyết định bằng Jeff. Hãy tính toán các quy tắc tất định, trạng thái tương lai và hệ quả nhiều bước trong ứng dụng của bạn. Cung cấp tình huống sau cùng cho Jeff để đưa ra phán đoán.
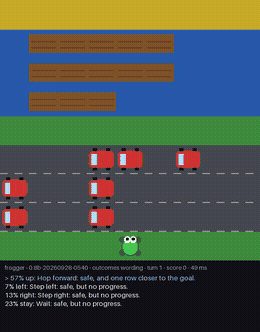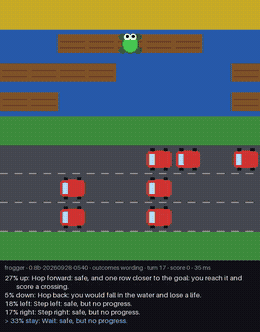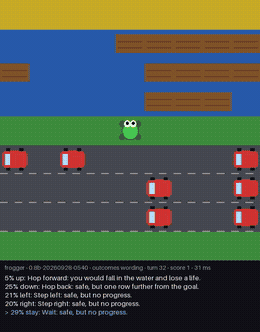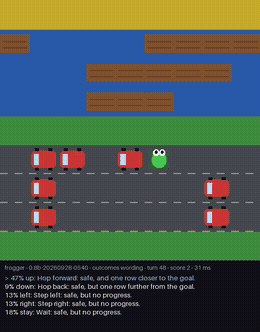
- Mô tả trực tiếp các hệ quả. Thay vì yêu cầu mô hình dự đoán rằng một chiếc xe sẽ đến sau hai lượt, hãy nêu rõ một nước đi cụ thể sẽ khiến nhân vật bị xe đâm.
- Giữ mô tả các tùy chọn nhất quán. Các tùy chọn nên có cấu trúc tương tự và mức độ chi tiết tương đương. Cách diễn đạt không nhất quán có thể làm sai lệch quyết định.
- Dùng khóa tùy chọn ngắn. Ưu tiên
{"1": "Engagement letter"}thay cho một mã định danh nội bộ dài. Khóa dài làm tăng chi phí xử lý mà không cải thiện phần mô tả tùy chọn. - Kết hợp các câu hỏi độc lập. Nếu nhiều quyết định dùng chung một trạng thái, hãy gửi chúng trong một yêu cầu thay vì lặp lại dữ liệu đầu vào.
- Kiểm thử dữ liệu đại diện. Kết quả benchmark là thông tin tham khảo hữu ích, nhưng không bảo đảm hiệu năng trong một quy trình cụ thể.
Jeff là một bộ phân loại, không phải một trình lập kế hoạch. Nó hoạt động tốt nhất khi mã của bạn chuẩn bị các dữ kiện liên quan và mô hình lựa chọn giữa những phương án được mô tả rõ ràng.
Hiệu năng và giới hạn
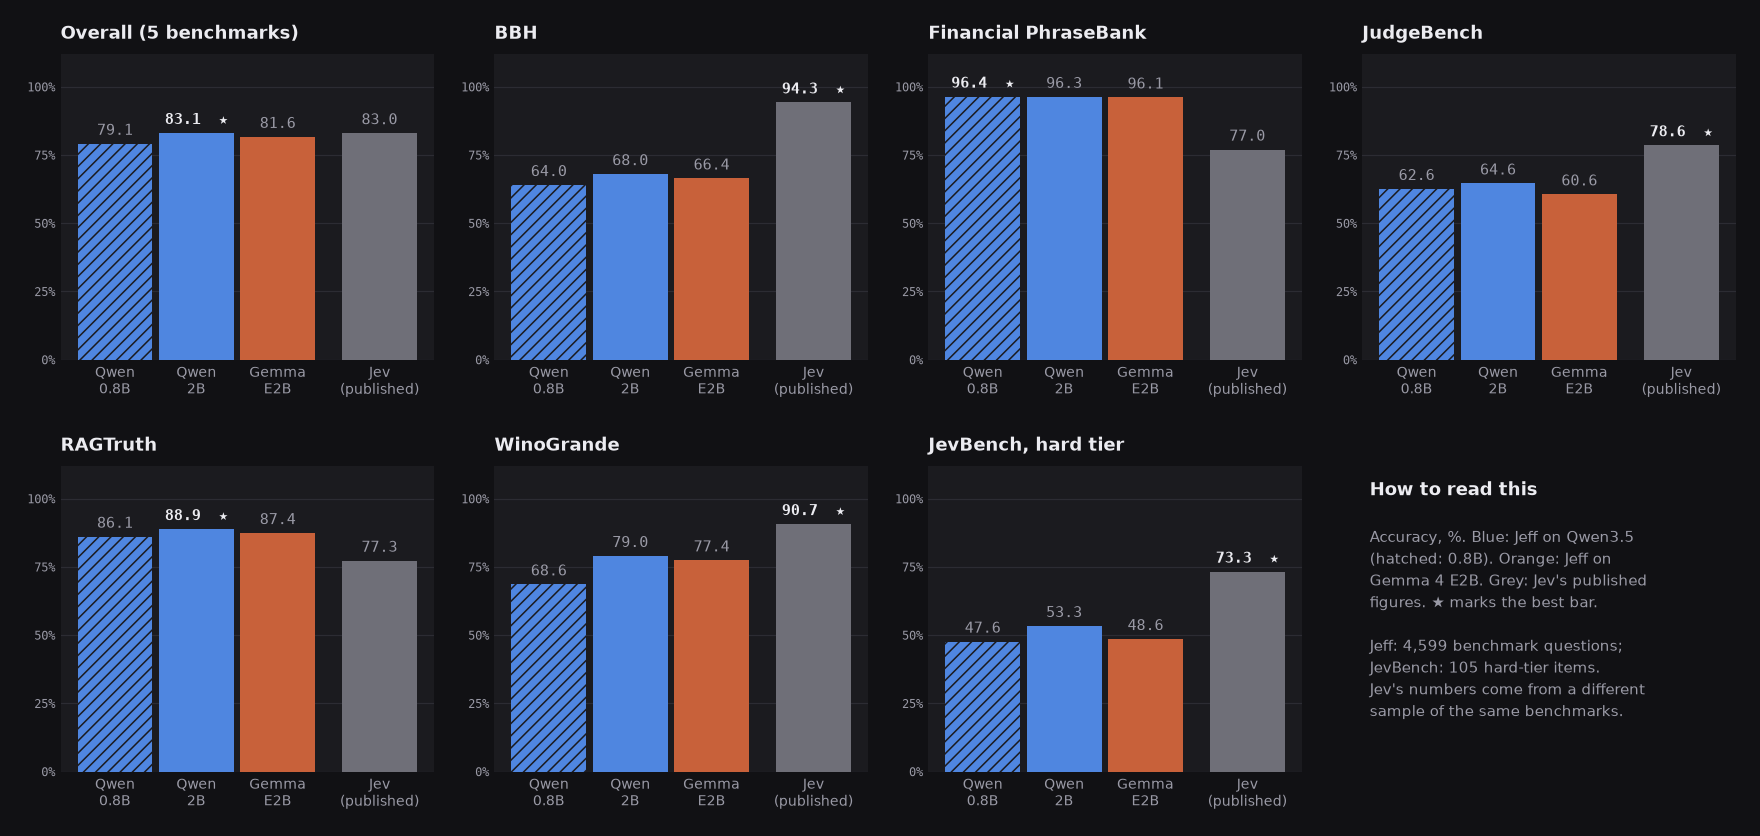
Trên năm benchmark công khai, Jeff-Qwen3.5-0.8B đạt 79.1, Jeff-Qwen3.5-2B đạt 83.1 và Jeff-Gemma4-E2B đạt 81.6 trong phần đánh giá của dự án. Kết quả của Qwen 2B gần với con số tổng thể được Jev công bố là 83.0, dù các số liệu của Jev và AutoJev được đo trên những mẫu khác nhau từ cùng các benchmark.
Kết quả thay đổi đáng kể tùy theo tác vụ. Jeff hoạt động tốt trong một số đánh giá về phân loại và đối chiếu thông tin, bao gồm Financial PhraseBank và RAGTruth, nhưng vẫn kém hơn các hệ thống lớn hơn ở những benchmark thiên về suy luận như BBH, JudgeBench và cấp độ khó của JevBench.
Thời gian suy luận trung vị được báo cáo cho đầu vào khoảng 200 token là 22 ms trên RTX PRO 6000, 28 ms trên M4 Max với MLX và 463 ms trên CPU 32 luồng đối với mô hình 0.8B. Các con số này phụ thuộc vào phần cứng và nên được đo lại trong môi trường triển khai của bạn.
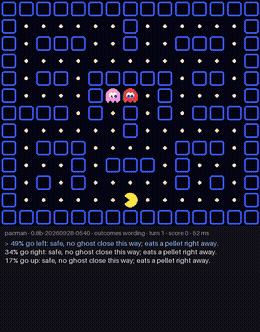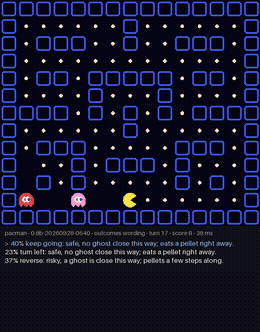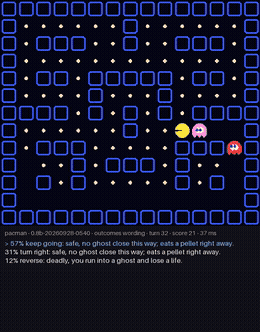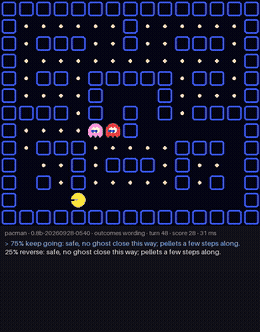
Thử bộ công cụ game
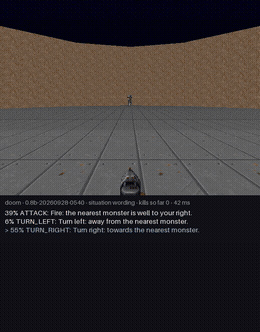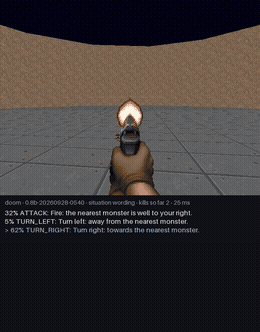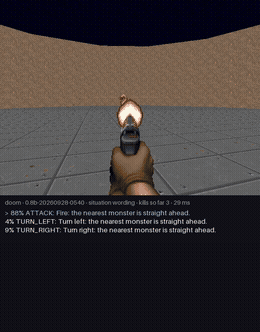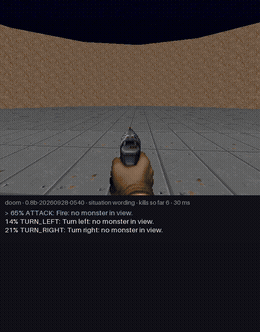
Kho mã bao gồm các thử nghiệm Doom, Frogger và Pac-Man, minh họa cách đưa ra quyết định dựa trên các nước đi hợp lệ được mô tả động. Hãy cài đặt các dependency tùy chọn cho game trước khi chạy:
uv sync --extra gamesKhi máy chủ Jeff đã chạy, bạn có thể khởi chạy các bài đánh giá Doom và Frogger được cung cấp:
uv run python -m jeff.games --game doom --player jeff --criteria situation --url http://127.0.0.1:8765 --video --out runs/games/doom.json
uv run python -m jeff.games --game frogger --player jeff --criteria outcomes --url http://127.0.0.1:8765 --out runs/games/frogger.json
Bạn cũng có thể chạy trình chơi Pac-Man dựa trên luật để so sánh:
uv run python -m jeff.games --game pacman --player rule --out runs/games/pacman-rule.jsonCác thử nghiệm này cũng cho thấy một giới hạn quan trọng: thứ hạng benchmark không nhất thiết dự đoán hiệu năng trong game tương tác. Trong các kết quả được công bố, mô hình Jeff 0.8B chơi game tốt hơn mô hình Jeff 2B trong một số trường hợp, dù mô hình 2B có điểm benchmark tổng hợp cao hơn.
Tinh chỉnh Jeff cho miền của bạn
Nếu độ chính xác zero-shot chưa đủ, hãy bắt đầu từ một checkpoint Jeff và huấn luyện trên các ví dụ từ ứng dụng của bạn. README cho biết một lần tinh chỉnh cho điều hướng bằng giọng nói, sử dụng khoảng 11.000 ví dụ dành riêng cho ứng dụng, đã cải thiện độ chính xác trên tập giữ lại từ 31.7% lên 95.8% trong khoảng nửa giờ trên một GPU.
autojev-train --initial-checkpoint <jeff> --epochs 1 ...Kho mã cũng cung cấp quy trình huấn luyện đầy đủ hơn. Một chuỗi điển hình sẽ xây dựng tập dữ liệu trộn, chạy huấn luyện và đánh giá checkpoint được chọn:
uv run autojev-mix ...
scripts/train.sh RUN data/mix/public.jsonl data/mix 5e-6 40 Qwen/Qwen3.5-0.8B <revision> --epochs 1
uv run autojev-evaluate --data data/panel.jsonl --local --checkpoint checkpoints/RUN/selected --output runs/eval/RUN.json
Công thức được công bố sử dụng tinh chỉnh toàn bộ trọng số trong một epoch, batch 256, hàm mất mát cross-entropy trên các chữ cái tùy chọn và nhiệt độ được khớp để hiệu chỉnh xác suất. Checkpoint được chọn bằng tập phát triển thay vì panel benchmark.
Để xem quy trình dữ liệu tổng hợp cục bộ hoàn chỉnh, lọc rò rỉ, quét learning rate và quy trình dashboard, hãy tham khảo scripts/train_all.sh. Dự án ghi lại các nguồn dữ liệu huấn luyện và giấy phép của chúng trong docs/data-sources.md.
Mẹo triển khai nâng cao
- Hiệu chỉnh phép đo trên dữ liệu của riêng bạn. Một mô hình tổng quát đã được hiệu chỉnh vẫn có thể cần các ngưỡng dành riêng cho ứng dụng để xử lý việc chuyển cấp hoặc dự phòng.
- Thêm phương án dự phòng an toàn. Khi độ tin cậy quá thấp, hãy chuyển yêu cầu cho con người, một quy tắc xác định hoặc mô hình có năng lực cao hơn.
- Giữ trạng thái ngắn gọn. Chỉ cung cấp các thông tin cần thiết cho quyết định và tránh văn bản không liên quan có thể khiến mô hình nhỏ bị phân tâm.
- Đánh giá các biến thể câu chữ. So sánh một số cách diễn đạt nhất quán về hướng dẫn và tiêu chí trước khi cố định lược đồ dùng trong môi trường production.
- Lựa chọn mô hình dựa trên thực nghiệm. Sử dụng mô hình 0.8B để chọn tùy chọn khi độ trễ là yếu tố quan trọng, nhưng hãy kiểm thử tất cả các checkpoint phù hợp trên tập xác thực của riêng bạn.
- Tôn trọng giới hạn về phương thức. Theo README, Jeff chỉ hỗ trợ văn bản tiếng Anh.
Kết luận
Jeff cung cấp một cách thiết thực để bổ sung các quyết định nhanh, cục bộ và dựa trên xác suất vào ứng dụng mà không cần tạo hoặc phân tích văn bản dạng tự do. Hãy bắt đầu với Jeff-Qwen3.5-0.8B, mô tả rõ ràng từng tùy chọn, nhóm các câu hỏi độc lập vào cùng một yêu cầu và đánh giá trên các ví dụ thực tế của ứng dụng. Khi hành vi zero-shot chưa đủ đáp ứng, hãy tinh chỉnh một checkpoint Jeff hiện có trên dữ liệu dành riêng cho miền.