

WeMM-Embedding là gì?
WeMM-Embedding là một họ mô hình nhúng đa phương thức phổ quát do nhóm WeChat Vision phát triển. Mô hình chuyển đổi văn bản, hình ảnh, video, tài liệu trực quan và các đầu vào đa phương thức xen kẽ thành các biểu diễn vectơ thống nhất. Những vectơ này có thể hỗ trợ các quy trình cần biểu diễn và so sánh nội dung giữa các phương thức khác nhau.
Mỗi mô hình lấy embedding từ trạng thái ẩn ở lớp cuối tại vị trí của token <embedding> chuyên dụng, sau đó áp dụng chuẩn hóa L2. Hiện chưa hỗ trợ đầu vào âm thanh.
Tính năng chính
- Biểu diễn đa phương thức thống nhất: Cùng một họ mô hình xử lý văn bản, hình ảnh, video, tài liệu trực quan và các đầu vào xen kẽ.
- Nhiều kích thước mô hình: Lựa chọn giữa các biến thể có 2B, 4B và 9B tham số.
- Học biểu diễn Matryoshka: Sử dụng các kích thước vectơ ngắn hơn được hỗ trợ khi cần tối ưu hiệu quả lưu trữ hoặc truy xuất.
- Hai giao diện suy luận: Cung cấp ví dụ cho cả Transformers và Sentence Transformers.
- Phục vụ trong môi trường production: Kho mã bao gồm cấu hình và tập lệnh wrapper cho vLLM và SGLang.
- Công cụ đánh giá: Pipeline MMEB-v3 đi kèm hỗ trợ suy luận trên một nút và nhiều nút.
Chọn mô hình và kích thước
Model zoo có ba biến thể trên Hugging Face. Hãy chọn mô hình dựa trên tài nguyên tính toán hiện có và kích thước embedding đầy đủ cần thiết.
- WeMM-Embedding-2B: Hỗ trợ các kích thước 64, 128, 256, 512, 1024 và 2048.
- WeMM-Embedding-4B: Hỗ trợ các kích thước 64, 128, 256, 512, 1024 và 2560.
- WeMM-Embedding-9B: Hỗ trợ các kích thước 64, 128, 256, 512, 1024, 2048 và 4096.
Kích thước được hỗ trợ nhỏ hơn sẽ giảm dung lượng lưu trữ vectơ và chi phí tính toán ở các bước sau. Ví dụ, README cho biết mô hình 2B với kích thước 256 vẫn giữ được 98.7% hiệu năng hình ảnh và video ở kích thước đầy đủ trên MMEB-v2.
Cài đặt và thiết lập
1. Lấy kho mã và mô hình
Làm việc từ một bản sao cục bộ của kho mã, sau đó tải mô hình từ trang Hugging Face tương ứng hoặc cấu hình ví dụ liên quan để sử dụng mã định danh mô hình Hugging Face khi được hỗ trợ.
2. Cài đặt các dependency
Cài đặt các phiên bản được dự án khai báo:
pip install -r requirements.txt3. Cố định phiên bản Transformers để đảm bảo khả năng tái lập
Dự án khuyến nghị sử dụng transformers==5.2.0 cho việc suy luận và tái lập kết quả, vì các bản phát hành mới hơn có thể có hành vi tiền xử lý khác.
pip install transformers==5.2.0Chuẩn bị đường dẫn đến mô hình, hình ảnh kiểm thử và video kiểm thử trước khi chạy các ví dụ.
Sử dụng cơ bản với Transformers
Ví dụ Transformers tạo các embedding độc lập cho đầu vào văn bản, hình ảnh và video. Chạy ví dụ với đường dẫn mô hình cục bộ và kích thước đầu ra được hỗ trợ:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Thay thế các đường dẫn giữ chỗ bằng tệp trên hệ thống của bạn. Với mô hình 2B, 2048 là kích thước vectơ đầy đủ. Để yêu cầu kích thước embedding đầy đủ của mô hình mà không chỉ định rõ, hãy bỏ qua --dimension:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Sử dụng cơ bản với Sentence Transformers
Ví dụ Sentence Transformers đưa đầu vào văn bản, hình ảnh và video qua SentenceTransformer.encode(). Ví dụ cũng hỗ trợ chọn kích thước Matryoshka thông qua --dimension.
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Vì SentenceTransformer có thể tải trực tiếp mô hình, bạn có thể thay đường dẫn cục bộ bằng mã định danh mô hình Hugging Face:
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Sử dụng embedding Matryoshka đúng cách
Embedding Matryoshka cho phép rút ngắn vectơ đầy đủ xuống một trong các kích thước được mô hình đã chọn hỗ trợ. Hãy cắt trục cuối, sau đó chuẩn hóa lại vectơ đã rút ngắn:
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)
Chỉ đặt d thành một kích thước có trong danh sách của mô hình. Bước chuẩn hóa thứ hai rất quan trọng vì việc cắt vectơ làm thay đổi chuẩn của vectơ. Khi sử dụng các ví dụ dòng lệnh đi kèm, hãy chọn kích thước Matryoshka mong muốn bằng --dimension.
Phục vụ mô hình với vLLM
Kho mã cho biết đã kiểm thử với vLLM 0.27.0. Khởi động máy chủ pooling và cung cấp chat template embedding của mô hình:
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
Wrapper tương đương có tại scripts/serve_vllm.sh.
Phục vụ mô hình với SGLang
SGLang 0.5.9 là phiên bản đã được kiểm thử và tài liệu dự án ghi nhận. Hãy áp dụng bản vá video đi kèm trước khi khởi chạy máy chủ embedding:
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
Kho lưu trữ cũng cung cấp scripts/serve_sglang.sh dưới dạng trình bao bọc để chạy bằng một lệnh.
Chạy đánh giá MMEB-v3
Thư mục mmeb_v3_eval/ chứa mã đánh giá được sử dụng cho các kết quả MMEB-v3 đã báo cáo. Mã này dựa trên quy trình VLM2Vec chính thức và bổ sung backbone WeMM-Embedding, các chỉ dẫn tập dữ liệu được căn chỉnh, suy luận theo lô, thực thi đa nút đa GPU và lấy mẫu video 64 khung hình.
Trước tiên, hãy vào thư mục đánh giá và tải dữ liệu xuống:
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
Sau đó chạy đánh giá với các đường dẫn đến mô hình, tập dữ liệu và đầu ra:
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
Tham khảo mmeb_v3_eval/README.md để xem hướng dẫn thiết lập dữ liệu và các lệnh chạy trên một nút hoặc nhiều nút.
Mẹo nâng cao
- Khớp số chiều với mô hình: Không yêu cầu 2560 chiều từ mô hình 2B hoặc 4096 chiều từ mô hình 4B. Chỉ sử dụng các số chiều được liệt kê cho checkpoint đã chọn.
- Chuẩn hóa lại các vector bị cắt: Nếu bạn tự rút ngắn một embedding đầy đủ, luôn áp dụng chuẩn hóa L2 sau đó.
- Đảm bảo tiền xử lý có thể tái lập: Hãy sử dụng phiên bản Transformers được khuyến nghị khi tái lập kết quả, vì tiền xử lý có thể thay đổi giữa các bản phát hành.
- Sử dụng phương thức tải phù hợp: Lệnh Transformers được ghi chép sử dụng đường dẫn mô hình, trong khi ví dụ Sentence Transformers cũng có thể tải trực tiếp
tencent/WeMM-Embedding-2B. - Lưu ý âm thanh không được hỗ trợ: Các mô hình hiện chưa tiếp nhận âm thanh, vì vậy điểm MMEB-v3 audio được báo cáo là zero.
- Sử dụng trình bao bọc phục vụ để thuận tiện: Các shell script trong
scripts/đóng gói các cấu hình khởi chạy vLLM và SGLang được ghi chép.
Bối cảnh hiệu năng
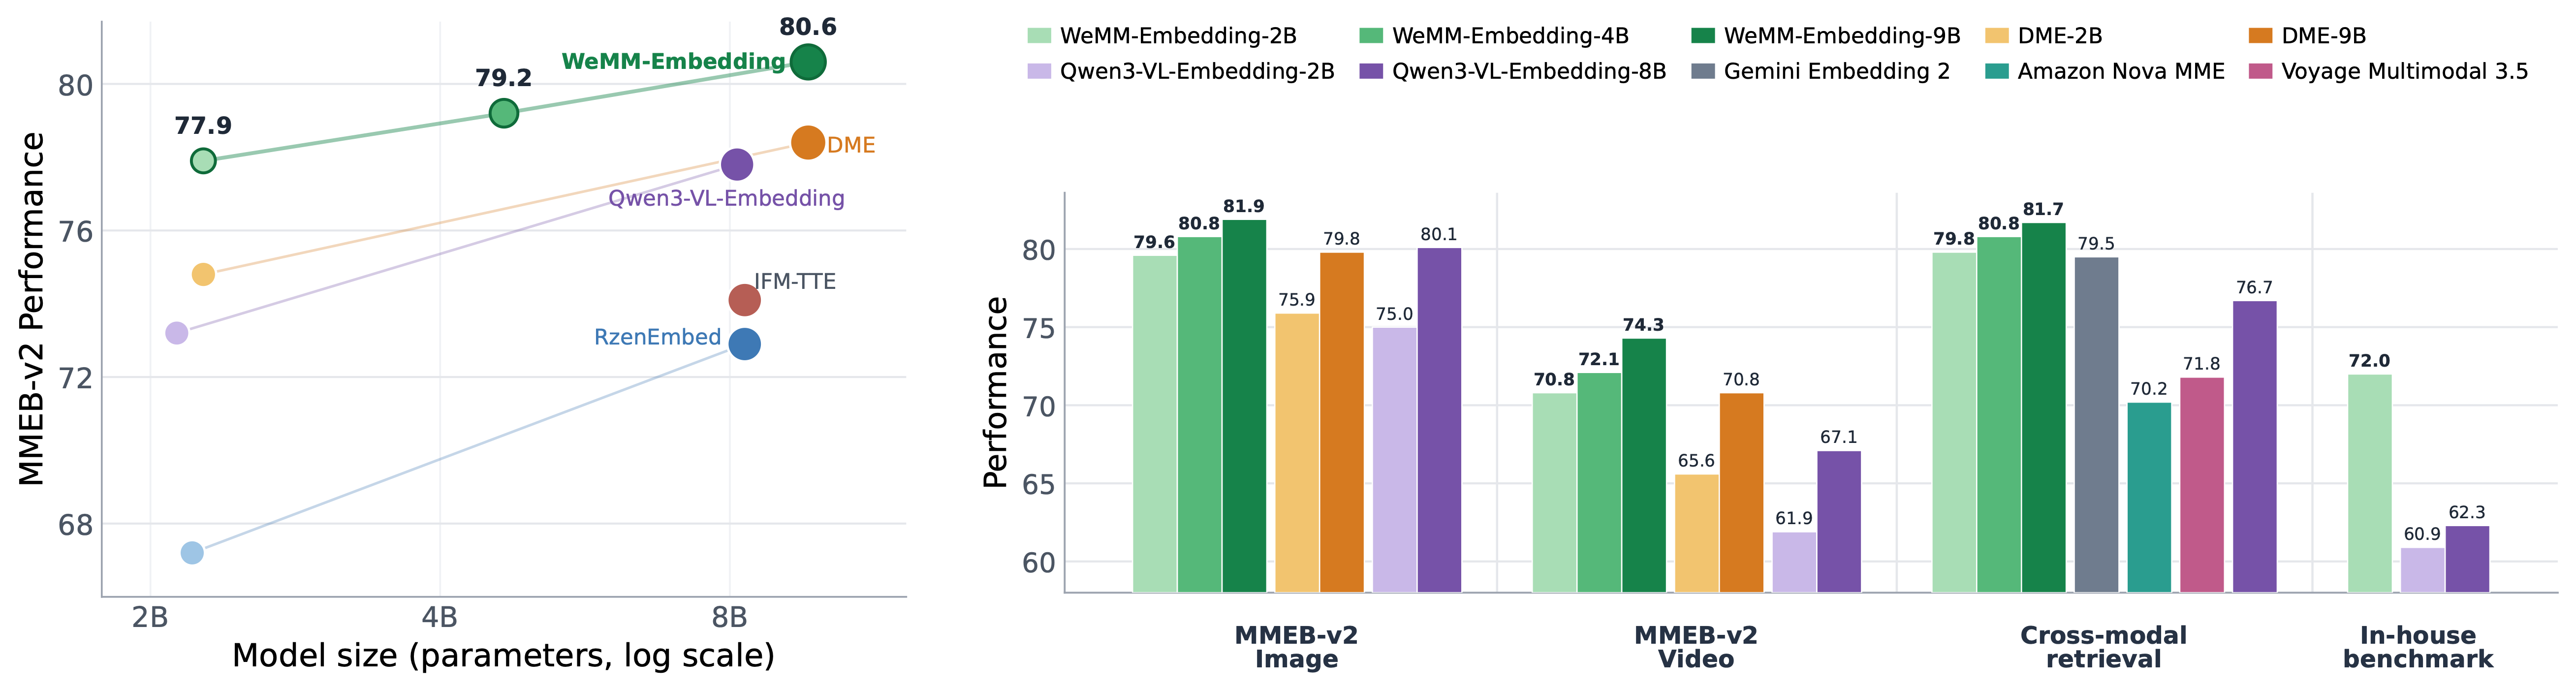
README báo cáo kết quả trên 78 tập dữ liệu MMEB-v2 và toàn bộ 190 tác vụ MMEB-v3. Trên MMEB-v2, các biến thể 2B, 4B và 9B lần lượt đạt điểm trung bình 77.9, 79.2 và 80.6. Trên MMEB-v3, điểm tổng thể được báo cáo của chúng lần lượt là 56.0, 58.2 và 59.5. Chỉ số thay đổi theo nhóm tác vụ: tác vụ hình ảnh và video sử dụng Hit@1, tác vụ tài liệu trực quan và văn bản sử dụng NDCG@5, còn tác vụ agent, MCMR và âm thanh sử dụng Hit@1.
Cần diễn giải điểm benchmark trong bối cảnh phạm vi tác vụ được ghi chép. MMEB-v3 gán điểm zero cho các tác vụ không được hỗ trợ, bao gồm âm thanh đối với WeMM-Embedding.
Kết luận
WeMM-Embedding cung cấp một họ mô hình để tạo các biểu diễn đã chuẩn hóa từ nhiều loại đầu vào trực quan và văn bản. Hãy bắt đầu với checkpoint 2B và một ví dụ suy luận được cung cấp, chọn số chiều Matryoshka được hỗ trợ khi cần các vector nhỏ gọn, rồi chuyển sang vLLM, SGLang hoặc quy trình MMEB-v3 khi cần phục vụ hoặc đánh giá. Mã nguồn trong kho lưu trữ do Tencent xây dựng được phát hành theo Apache License 2.0, trừ khi có ghi chú khác.