

DeepInfer-SM80 là gì?
DeepInfer-SM80 là tập hợp các mô-đun Python, Triton và TileLang được tối ưu để chạy DeepSeek-V4.1 trên GPU NVIDIA Ampere thông qua engine vLLM V1. Dự án chuyển các ý tưởng cốt lõi từ DeepInfer của DeepSeek, vốn hướng đến NVIDIA Blackwell, đồng thời thiết kế lại đường dẫn thực thi quan trọng dựa trên năng lực của phần cứng Ampere.
Thay vì phụ thuộc vào các tính năng chỉ có trên Blackwell như lệnh warp-group tcgen05, Tensor Memory, lệnh scale UE8M0 phần cứng và 228 KB bộ nhớ chia sẻ trên mỗi streaming multiprocessor, dự án sử dụng Tensor Core mma.sync.aligned.m16n8k16 của Ampere, lập lịch nhận biết SM, giải mã UE8M0 bằng dịch bit số nguyên và tái sử dụng shared-KV YOCO.
Dự án hỗ trợ các GPU SM80 cho trung tâm dữ liệu như A100 và A800, cùng các thiết bị SM86 gồm RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 và A30. Các kernel sử dụng không quá 48 KB bộ nhớ chia sẻ cho mỗi CTA, nhờ đó có thể chạy trong giới hạn bộ nhớ chia sẻ thấp hơn của thiết bị SM86.
Tại sao nên sử dụng?
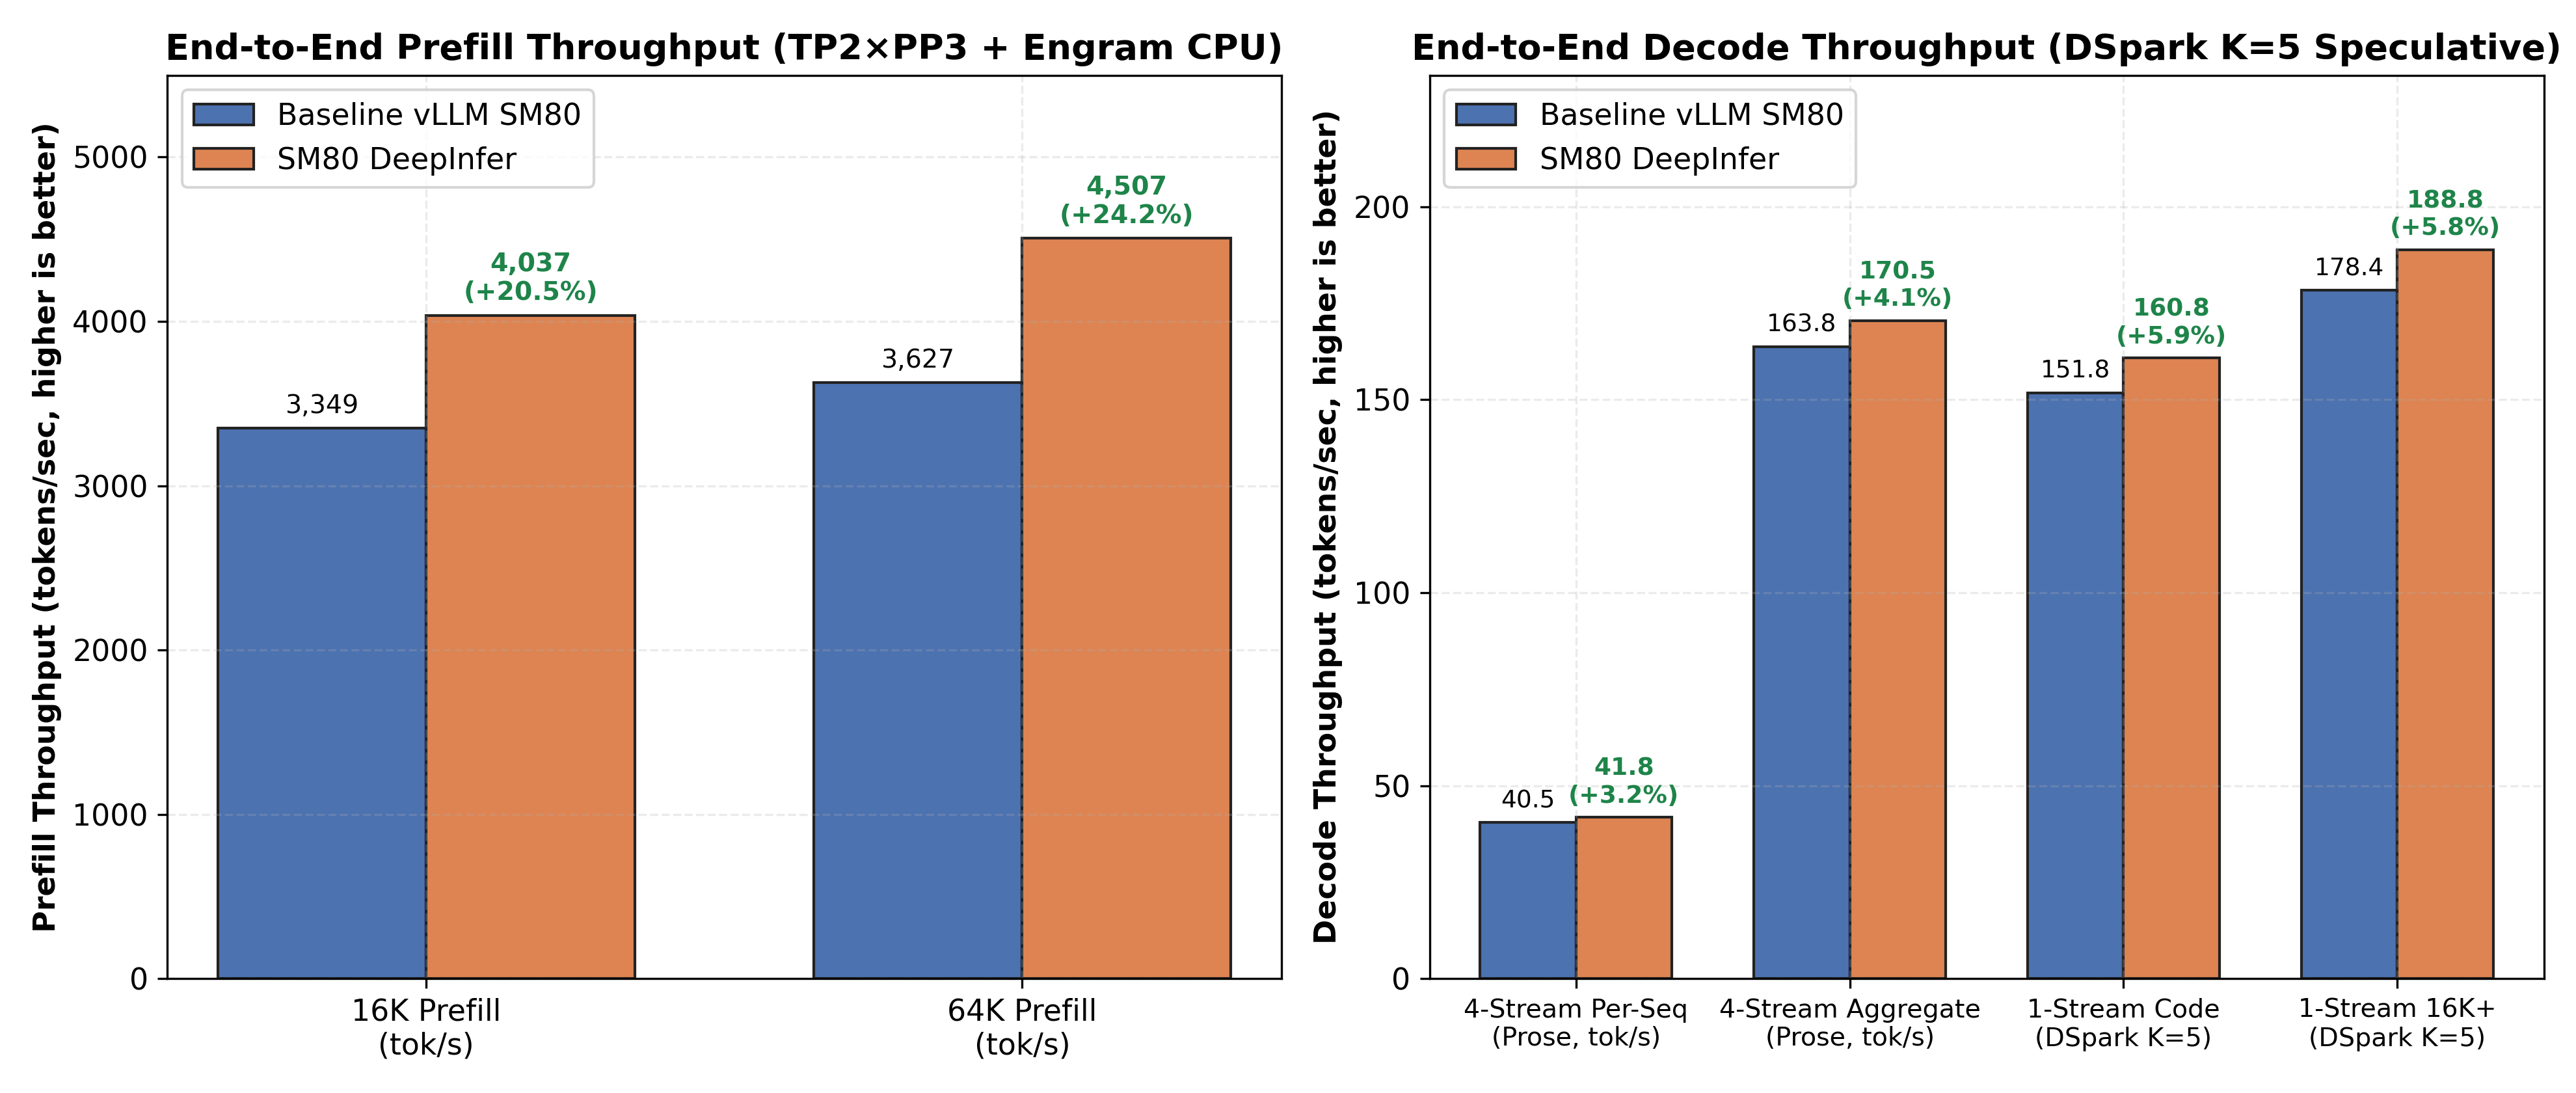
DeepInfer-SM80 tập trung vào các tác vụ tốn nhiều chi phí trong prefill DeepSeek-V4.1, attention thưa, truy cập KV-cache, định tuyến residual và suy luận ngữ cảnh dài. Kho mã báo cáo các kết quả sau từ cấu hình production sử dụng sáu GPU GA100 64 GB, TP2 × PP3, giải mã suy đoán DSpark với K=5 và độ dài ngữ cảnh tối đa 1.048.576 token:
- Prefill lạnh 16K: 4.037,0 token/giây, tăng từ 3.349,4 token/giây.
- Prefill lạnh 64K: 4.506,8 token/giây, tăng từ 3.627,3 token/giây.
- Thời gian nhận token đầu tiên ở 64K: 10,7 giây, giảm từ 13,2 giây.
- Giải mã suy đoán bốn luồng: tổng cộng 170,5 token/giây, so với 163,8 token/giây.
- Giải mã mã Python một luồng: 160,8 token/giây, so với 151,8 token/giây.
- Dung lượng KV trên GPU: 4.648.480 token, không tăng VRAM so với cấu hình cơ sở.
Các phép đo này mô tả phần cứng và cấu hình serving đã được kiểm thử của kho mã. Kết quả trên các GPU Ampere, cấu hình mô hình, workload hoặc môi trường vLLM khác có thể khác.
Các tối ưu hóa chính
Unified Sparse MLA 512 chiều
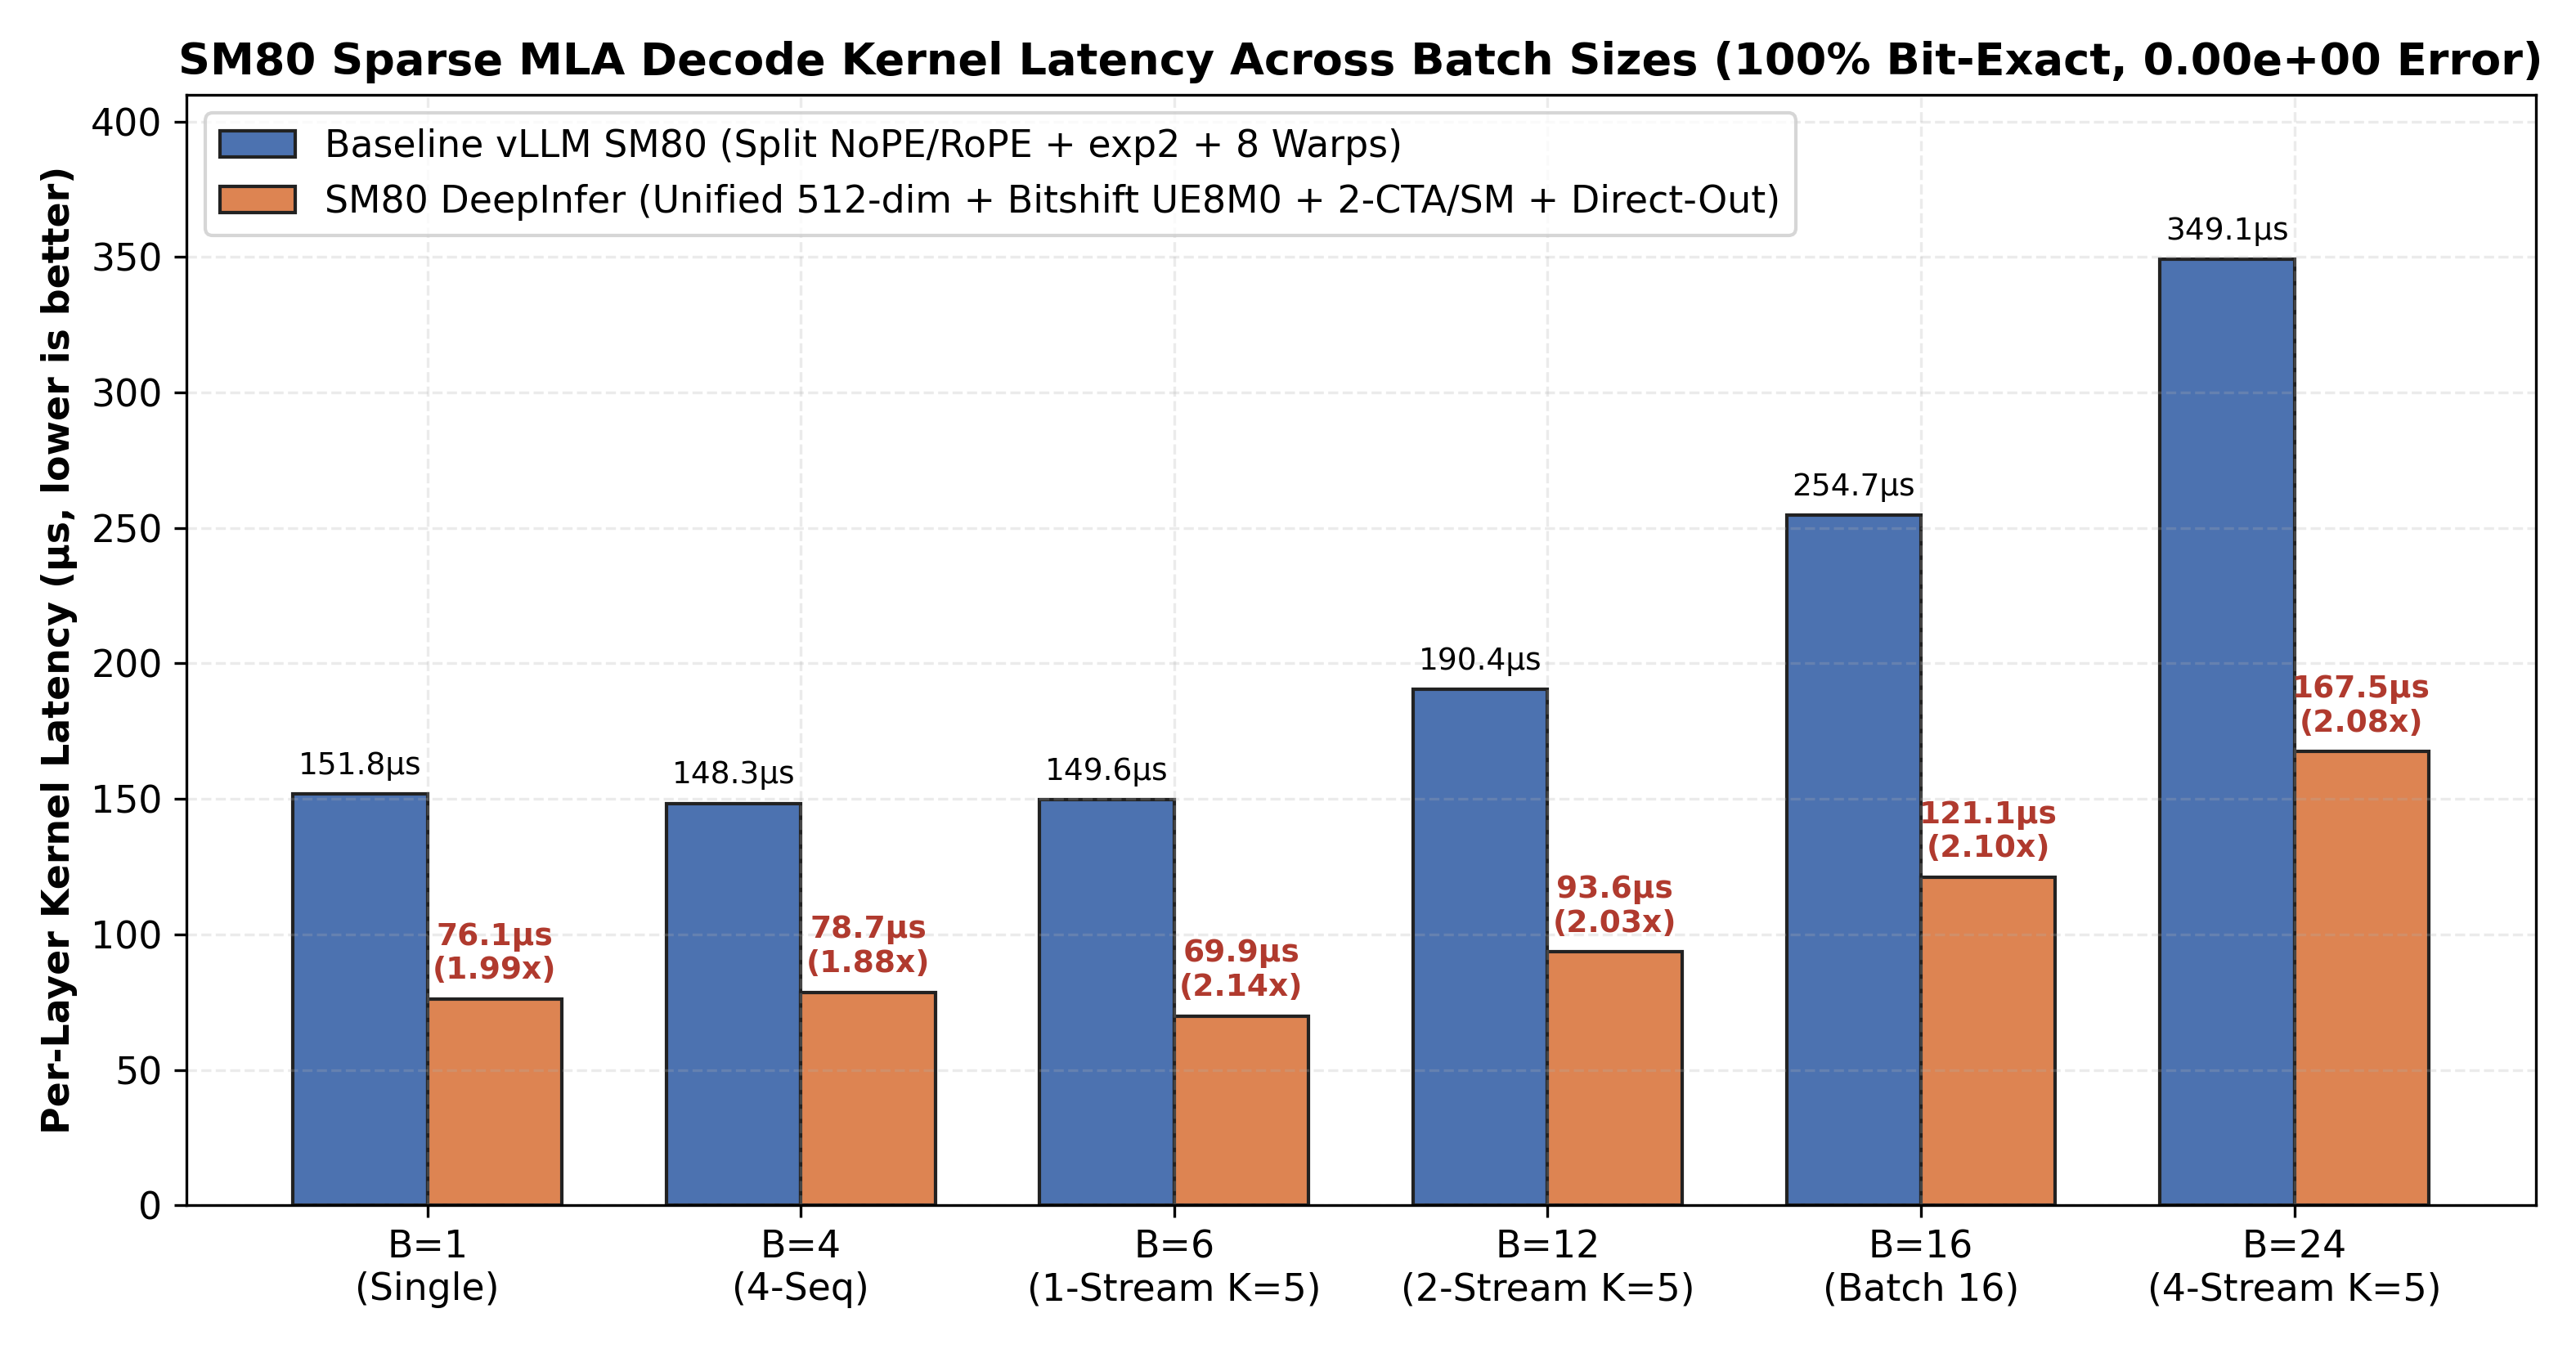
Attention thưa DeepSelect của DeepSeek-V4.1 lưu latent NoPE 448 chiều ở dạng float8_e4m3fn, sử dụng scale khối lũy thừa của hai UE8M0, cùng với hậu tố RoPE BF16 64 chiều. DeepInfer-SM80 nạp toàn bộ tile 512 chiều và xử lý qua một đường dẫn tích vô hướng Tensor Core duy nhất, thay vì xử lý riêng phần NoPE và RoPE.
Kernel thay thế phép chuyển đổi UE8M0 dựa trên exp2 bằng phép dịch bit số nguyên IEEE-754:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)Với các số mũ UE8M0 hợp lệ, phép này tạo ra các giá trị scale FP32 giống hệt từng bit, đồng thời chuyển phần xử lý từ các phép toán siêu việt sang pipeline số nguyên.
Cấu hình được tinh chỉnh sử dụng BLOCK_N=64, num_warps=4 và num_stages=2. Việc giảm áp lực thanh ghi cho phép hai CTA cư trú trên mỗi streaming multiprocessor SM80. Khi num_kv_splits == 1, kernel ghi trực tiếp vào đầu ra cuối cùng và tránh khởi chạy một giai đoạn reduction riêng.
Kết hợp chỉ mục Top-K và SWA trong một CTA
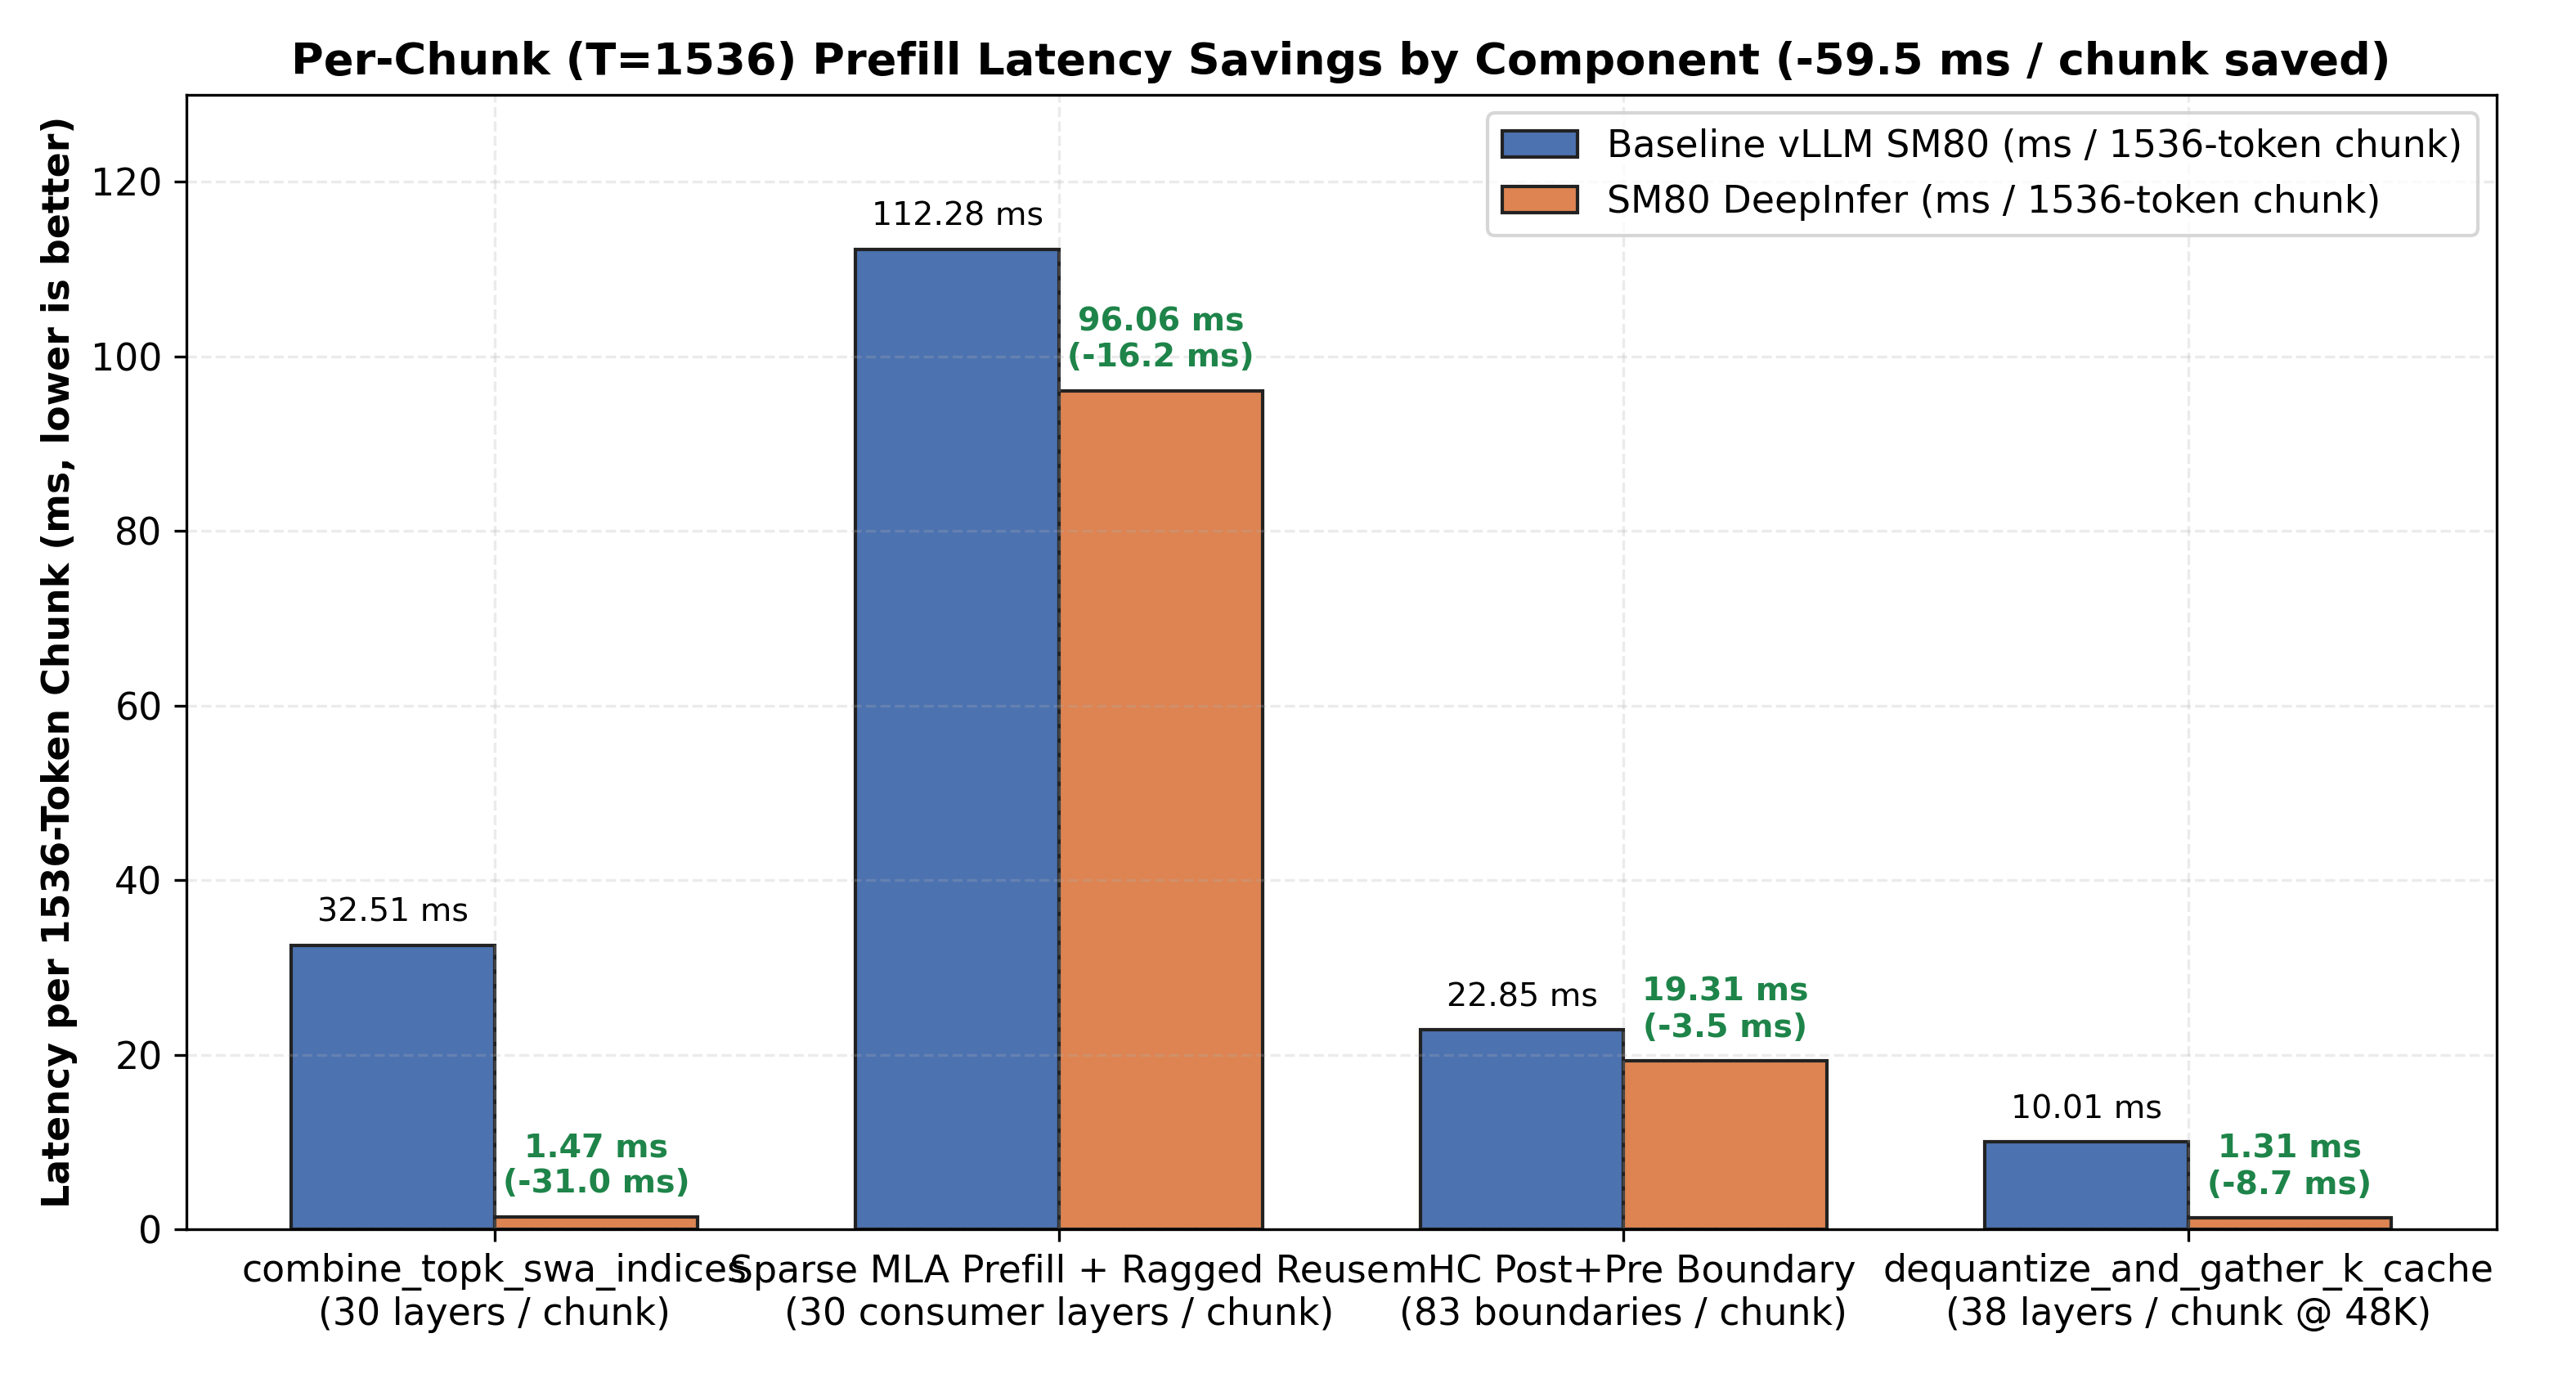
_combine_topk_swa_indices_kernel được tối ưu thay thế chuỗi cấp phát và thao tác PyTorch bằng một kernel Triton, sử dụng một CTA cho mỗi token truy vấn. Ở T=1536, độ trễ đo được giảm từ 1.083,72 micro giây xuống 48,88 micro giây, nhanh hơn 22,17 lần.
Để tránh xung đột ghi giữa các warp, mỗi hàng đầu ra được chia thành ba vùng không giao nhau:
- Các chỉ mục Top-K đã nén chiếm
[0, topk_len). - Các chỉ mục sliding-window attention chiếm
[topk_len, topk_len + swa_len). - Các cột còn lại được đệm bằng
-1.
README báo cáo đầu ra chính xác từng bit trên mọi độ dài chuỗi và các tỷ lệ nén 0, 1 và 2 đã được kiểm thử.
Khử lượng tử và gom KV-Cache nhanh hơn
Đường dẫn dequantize_and_gather_k_cache sử dụng cùng phép chuyển đổi UE8M0 dựa trên dịch bit. Đường dẫn này cũng ghi theo các stride đích được cung cấp cho kernel Triton, loại bỏ các cấp phát torch.empty trung gian và các thao tác .copy_() tiếp theo.
Mức tăng tốc đo được là 4,02 lần ở ngữ cảnh 16K và 7,64 lần ở ngữ cảnh 48K, với kết quả khớp chính xác từng bit với tham chiếu trong các phép thử được báo cáo.
Định tuyến residual mHC được tinh chỉnh cho SM80
DeepSeek-V4.1 thực hiện định tuyến hyper-connection ràng buộc manifold bốn luồng tại 83 ranh giới trong mỗi lượt truyền xuôi. DeepInfer-SM80 bổ sung hình học phân tách căn chỉnh (6, 8, 128) cho kích thước ẩn 5.120 của mô hình. Mỗi trong tám lát chứa 640 phần tử, chia hết cho 128.
Dự án cũng hạ ngưỡng ma trận nhỏ từ 32 xuống 16, để số token từ 16 trở lên có thể sử dụng đường dẫn Tensor Core T.gemm. Mức tăng tốc mhc_fused_post_pre_delayed được báo cáo là 2,89 lần ở T=12 và 1,30 lần ở T=6.
Tái sử dụng siêu dữ liệu YOCO
Trong kiến trúc You-Only-Cache-Once của DeepSeek-V4.1, các layer từ 21 đến 39 đọc từ KV cache đầy đủ độ phân giải của layer 20. Các consumer này dùng chung độ dài chuỗi đã mở rộng, block table và tỷ lệ nén.
DeepInfer-SM80 lưu metadata K dạng ragged trong ngữ cảnh forward của vLLM khi xử lý layer 20. Việc tái sử dụng dữ liệu này cho các layer từ 21 đến 39 loại bỏ 19 chuỗi kernel GPU xây dựng metadata dư thừa cho mỗi prefill chunk.
Trước khi cài đặt
Bạn cần một môi trường vLLM V1 có thể chạy DeepSeek-V4.1 trên GPU NVIDIA Ampere được hỗ trợ. Repository cung cấp một bản vá hợp nhất và sáu module thay thế, nhưng README không quy định chính xác số phiên bản CUDA, Python, Triton, TileLang hoặc vLLM. Hãy sử dụng bản checkout vLLM tương thích với bản vá và hệ thống triển khai DeepSeek-V4.1 hiện có.
Các nhóm phần cứng được hỗ trợ gồm:
- GPU trung tâm dữ liệu SM80: A100 40 GB, A100 80 GB, GA100 64 GB và A800 40 GB hoặc 80 GB.
- GPU workstation và GPU phổ thông SM86: RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10 và A30.
Phần mềm được phân phối theo Apache License 2.0.
Tùy chọn cài đặt A: Áp dụng bản vá hợp nhất
Phương pháp này áp dụng cả sáu tệp đã sửa đổi vào một bản checkout mã nguồn vLLM. Mở terminal trong thư mục gốc của bản checkout đó và chạy:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patchThay /path/to/Deepinfer-SM80 bằng vị trí của project đã clone hoặc tải xuống. Bản vá bao gồm các thay đổi về sparse MLA, cache-gather, Top-K cộng SWA, mHC, warmup và tái sử dụng metadata YOCO.
Tùy chọn cài đặt B: Cài đặt các module drop-in
Nếu việc thay thế trực tiếp các tệp phù hợp hơn với môi trường của bạn, hãy sao chép cây module vLLM của project lên package vLLM đã cài đặt:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm/Thay /path/to/site-packages/vllm/ bằng thư mục package vLLM thực tế. Các tệp tương tự cũng có thể được bind-mount dưới dạng overlay chỉ đọc trong quá trình triển khai Docker.
Cây drop-in sửa đổi các khu vực chức năng sau:
model_executor/kernels/mhc/cho việc thực thi mHC bằng TileLang và warmup.models/deepseek_v4_1/amd/rocm.pycho bộ kết hợp Triton Top-K và SWA.models/deepseek_v4_1/common/ops/cache_utils.pycho việc tập hợp KV cache.models/deepseek_v4_1/nvidia/model.pycho việc tái sử dụng metadata YOCO.v1/attention/ops/rocm_aiter_mla_sparse.pycho các kernel sparse MLA hợp nhất.
Mặc dù hai tệp được tối ưu vẫn có
rocmhoặcamdtrong đường dẫn, repository sử dụng chúng một cách rõ ràng như một phần của tích hợp vLLM hướng đến Ampere. Hãy giữ nguyên cấu trúc thư mục được cung cấp khi áp dụng các tệp drop-in.
Cách sử dụng cơ bản: Xác thực các kernel
Sau khi cài đặt bản vá hoặc các module drop-in, hãy chạy các microbenchmark độc lập được cung cấp trên GPU A100, A800, RTX 3090, RTX A6000 hoặc GPU Ampere được hỗ trợ khác:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
Các tệp benchmark bao phủ kernel sparse MLA và KV-gather, kernel mHC TileLang và bộ kết hợp Top-K cộng SWA. Mục đích của chúng là đo độ trễ kernel trên hệ thống cục bộ và xác minh đầu ra đã tối ưu so với các tham chiếu baseline.
Tạo biểu đồ benchmark của repository bằng:
python3 benchmarks/generate_charts.pyBộ dữ liệu benchmark đầy đủ cũng có sẵn tại benchmarks/results/sm80_benchmark_summary.json.
Tìm hiểu về xác thực số
Một số đường dẫn được tối ưu được báo cáo là chính xác đến từng bit:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
Các đường dẫn Tensor Core khác có thể chênh lệch nhẹ do phép tích lũy BF16 hoặc thứ tự thực thi MMA thay đổi. Độ lệch tối đa được báo cáo thấp hơn 1.9e-3 đối với các cấu hình mHC fused đã đo và thấp hơn 4.8e-3 đối với cấu hình sparse-attention prefill đã đo.
Kết quả negative log-likelihood của prompt-logprob vẫn nằm trong mức nhiễu giữa các lần chạy được báo cáo. Khi đánh giá một hệ thống triển khai, hãy kiểm tra cả hiệu năng và đầu ra số thay vì giả định rằng mọi toán tử được tối ưu đều phải giống hệt từng bit.
Mẹo triển khai nâng cao
Sử dụng TP2 × PP3 cho bố cục production sáu GPU đã được kiểm thử
Đối với sáu GPU Ampere 64 GB hoặc 80 GB, repository khuyến nghị TP2 × PP3 với phân vùng layer 14,14,12. Trong cấu hình đã kiểm thử, bố cục này đạt 160.8 đến 188.8 token mỗi giây đối với mã single-stream được chọn và workload sinh dài, 4,506.8 token mỗi giây cho cold prefill 64K, đồng thời cung cấp dung lượng khoảng 4.65 triệu token KV lưu trên GPU.
Dung lượng này tương đương khoảng 4.43 context, mỗi context dài một triệu token, trong cấu hình benchmark.
Tìm hiểu các phương án thay thế
- PP6: cung cấp dung lượng khoảng 4.5 đến 4.7 triệu token, nhưng README báo cáo tốc độ decode single-stream chậm hơn đáng kể vì tensor parallelism bằng một và các request phải đi qua sáu pipeline stage.
- TP2 cộng TP4 bất đối xứng: tăng dung lượng ước tính lên khoảng sáu triệu token, nhưng việc chia kích thước intermediate MoE là 2,304 thành các partition TP4 rộng 576 làm giảm hiệu quả tile của Marlin.
Tham khảo docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md trong repository trước khi lựa chọn topology cho một triển khai với một triệu token.
Benchmark workload thực tế
Phần cải thiện lớn nhất đến từ các toán tử được gọi thường xuyên, nhưng mức cải thiện đầu-cuối còn phụ thuộc vào độ dài prompt, mức độ đồng thời, giải mã suy đoán, topology và mẫu GPU. Trước tiên, hãy chạy các benchmark độc lập, sau đó so sánh các workload phục vụ hoàn chỉnh bằng cùng prompt, kích thước ngữ cảnh và mức độ đồng thời như ứng dụng production của bạn.
Duy trì fast path đầu ra trực tiếp
Tối ưu hóa giải mã MLA thưa bỏ qua lần khởi chạy reduction thứ hai khi num_kv_splits == 1. Nếu bạn thay đổi việc lập lịch attention hoặc hành vi phân tách, hãy đo lại kernel vì đường dẫn đầu ra trực tiếp là một phần quan trọng của mức cải thiện giải mã được báo cáo.
Giữ metadata YOCO trong forward context
Bộ nhớ đệm metadata ở layer 20 có giá trị vì tất cả consumer ở layer 21–39 đều dùng chung nguồn KV của nó. Các thay đổi đối với việc thực thi model hoặc xử lý forward context nên duy trì khả năng tái sử dụng này; nếu không, engine có thể xây dựng lại metadata ragged giống hệt cho từng consumer layer.
Kết luận
DeepInfer-SM80 cung cấp một hướng tập trung để tăng tốc DeepSeek-V4.1 trên NVIDIA Ampere mà không làm tăng overhead VRAM của KV-cache. Các cải tiến của nó kết hợp attention thưa tối ưu cho Ampere, giải mã UE8M0 bằng bitshift, đầu ra KV-cache trực tiếp, bộ kết hợp Top-K và SWA không lỗi tranh chấp, định tuyến mHC đã căn chỉnh và tái sử dụng metadata YOCO.
Hãy bắt đầu bằng cách áp dụng patch hợp nhất hoặc cài đặt sáu module drop-in. Chạy cả ba bộ microbenchmark để xác nhận độ trễ và hành vi số học trên phần cứng của bạn, sau đó đánh giá môi trường vLLM đã tối ưu bằng workload phục vụ thực tế. Đối với một triển khai sáu GPU với ngữ cảnh một triệu token, hãy sử dụng cấu hình TP2 × PP3 đã được kiểm thử của repository làm điểm tham chiếu chính.