

Agent AIBuildAI LLM-Post-Train là gì?
Agent AIBuildAI LLM-Post-Train là một tác tử tự cải thiện đệ quy, dùng để tự động hóa quá trình hậu huấn luyện tùy chỉnh cho các mô hình ngôn ngữ lớn. Thay vì áp dụng một quy trình huấn luyện cố định, tác tử phân tích nhiệm vụ, thiết kế các thuật toán hậu huấn luyện, thu thập và tuyển chọn dữ liệu huấn luyện, viết mã, chạy thử nghiệm, đánh giá kết quả và liên tục cải thiện mô hình.
Kho mã chứa mã nguồn để chạy, đọc và chỉnh sửa tác tử. Tác tử được thiết kế cho các tổ chức và nhà nghiên cứu cần những chiến lược hậu huấn luyện phù hợp với dữ liệu độc quyền, dòng mô hình, quy trình đánh giá và mục tiêu triển khai của họ.
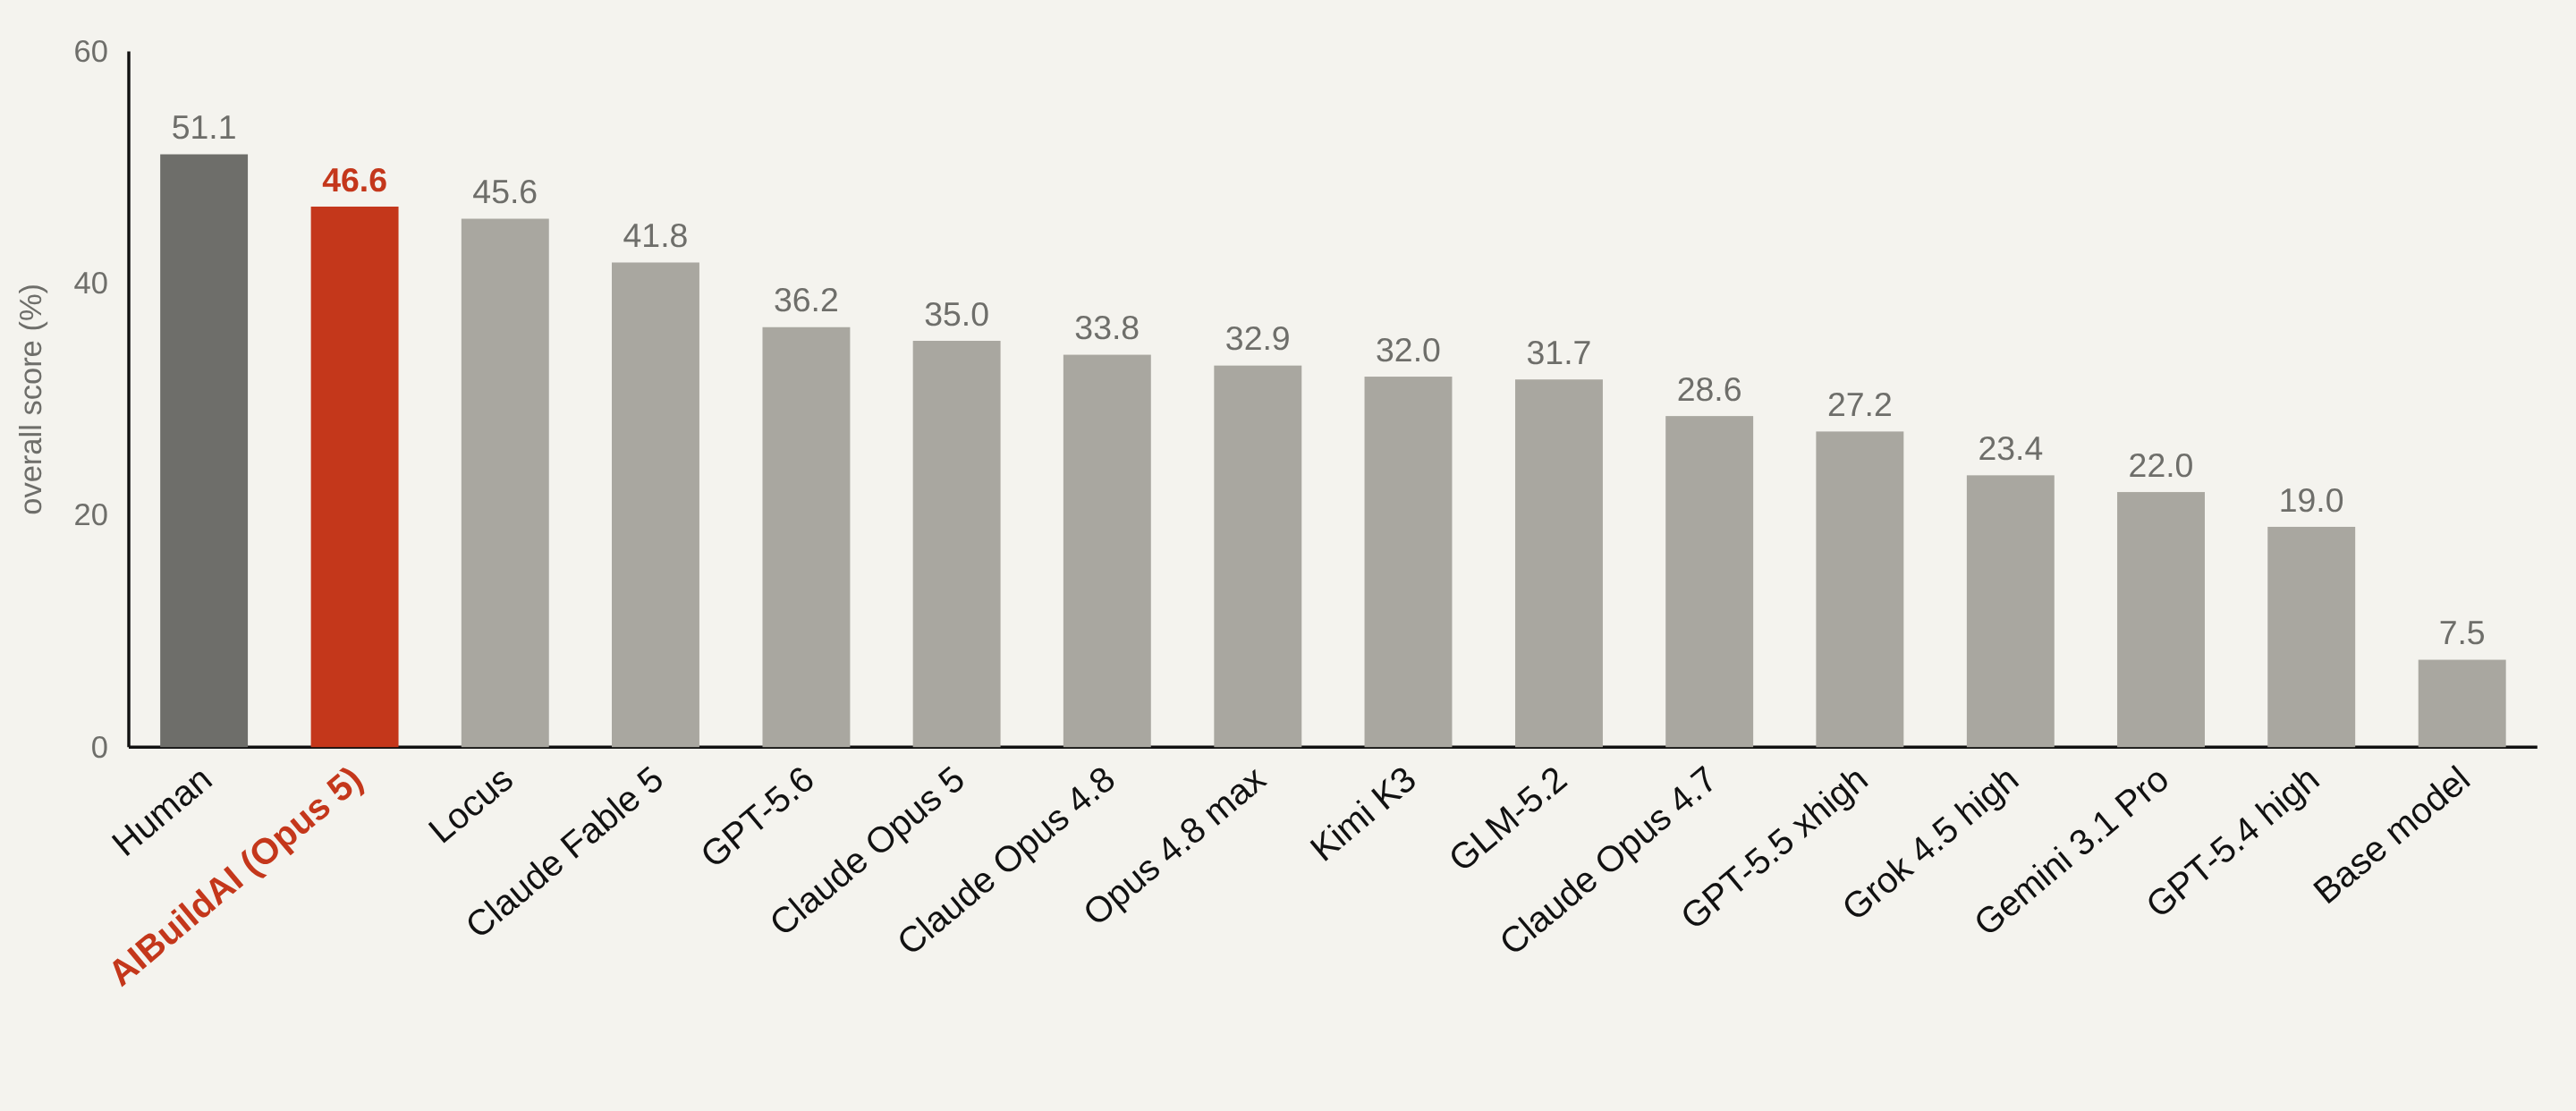
Trên PostTrainBench, dự án đạt điểm tổng thể 46.6%, đứng đầu trong số các mô hình và tác tử được đánh giá, chỉ đứng sau mức chuẩn của chuyên gia con người là 51.1%.
Cách tác tử hoạt động
Một lần chạy bắt đầu với một nhiệm vụ và quy trình chấm điểm. Hệ thống chuẩn bị mô tả nhiệm vụ cố định, thiết lập đường cơ sở, khởi chạy các thử nghiệm, chấm điểm từng ứng viên hoàn tất bằng cùng một chương trình chấm điểm, rồi chuyển kết quả tốt nhất thành sản phẩm bàn giao.
Hai khả năng giúp hệ thống khác biệt với một tác tử lập trình đa năng:
- Hệ thống tri thức: Các tác tử có thể truy vấn Cơ sở tri thức AIBuildAI qua MCP. Các tài liệu kỹ năng được tuyển chọn bao quát quy trình hậu huấn luyện, phương pháp, bộ dữ liệu và framework.
- Tìm kiếm meta: Một tác tử meta có thể điều tra nhiệm vụ và viết chương trình tìm kiếm dành riêng cho nhiệm vụ, thay vì thực thi một cấu trúc thử nghiệm được định trước.
Mỗi lần chạy cũng được cung cấp một workspace web trực tiếp, đồ thị thực thi bền vững, các đơn vị công việc có nhật ký, các tiến trình con được cô lập trong sandbox và cơ chế kiểm soát tài nguyên. Sự kiện chạy được lưu trong một cụm PostgreSQL riêng tư tại ~/.aibuildai/postgresql, hỗ trợ thực thi có thể tiếp tục và phát lại.
Tính năng chính
- Tự động thiết kế và thực thi các thử nghiệm hậu huấn luyện LLM.
- Chiến lược tìm kiếm theo nhiệm vụ, bao gồm tìm kiếm meta và một số phương pháp tìm kiếm cố định.
- Truy xuất tri thức về phương pháp, bộ dữ liệu, framework và các quyết định trong quy trình.
- Các tác tử có kiểu, chương trình xác định và tìm kiếm lồng nhau.
- Chấm điểm do nhiệm vụ xác định và xếp hạng ứng viên nhất quán.
- Giám sát trực tiếp trên trình duyệt thông qua dịch vụ workspace cục bộ.
- Sandbox Bubblewrap và các giới hạn cgroup-v2 cho bộ nhớ và tiến trình.
- Bộ nhớ được tạo cục bộ từ các lần chạy trước.
- Tùy chọn soạn thảo bài báo và biên dịch PDF sau khi tổng hợp.
- Hỗ trợ Claude và các mô hình khác được cung cấp qua các endpoint tương thích với Anthropic.
Yêu cầu hệ thống
Trước khi cài đặt dự án, hãy xác nhận máy chủ đáp ứng các yêu cầu sau:
- Linux trên x86_64 với phiên người dùng systemd.
- Python 3.11 đến 3.13.
- Bộ công cụ C bao gồm
gccvàmake. - Header phát triển của zlib và readline.
bwrap, được cung cấp bởi góibubblewrap, với namespace người dùng không đặc quyền được bật.- Quyền truy cập mạng tới các bản phát hành GitHub và
ftp.postgresql.org. - Tài khoản đăng nhập Claude Code, khóa API Anthropic hoặc một mô hình khác khả dụng qua endpoint tương thích với Anthropic.
- Khuyến nghị dùng GPU CUDA, dù các tác tử sẽ phát hiện và sử dụng phần cứng hiện có.
Lần chạy đầu tiên sẽ xây dựng một bản cài đặt PostgreSQL riêng tư từ tarball mã nguồn chính thức. Hệ thống cũng tải các bản sao được ghim phiên bản của những công cụ như ruff, tectonic, micromamba, caddy và PostgreSQL vào ~/.cache/aibuildai. Hệ thống sử dụng các bản sao do mình quản lý này thay cho những bản cài đặt tương đương trên máy chủ.
Bạn không cần conda. Tác tử tạo các môi trường Program bằng bản cài đặt micromamba do mình quản lý.
Kiểm tra việc ủy quyền cgroup-v2
Một lần chạy được giới hạn trong một cây cgroup-v2. Trình quản lý người dùng systemd phải ủy quyền ít nhất các bộ điều khiển memory và pids. Kiểm tra cấu hình hiện tại bằng:
U=$(id -u)
cat /sys/fs/cgroup/user.slice/user-$U.slice/user@$U.service/cgroup.subtree_control
Kết quả phải bao gồm memory và pids. Nếu thiếu một trong hai, quản trị viên phải thêm Delegate=pids memory cpu vào tệp drop-in trong /etc/systemd/system/user@$U.service.d/, tải lại systemd và yêu cầu bạn đăng nhập lại.
Cài đặt tác tử
1. Cài đặt các gói của hệ điều hành
Trên Debian hoặc Ubuntu, hãy cài đặt trình biên dịch, các header cần thiết và bubblewrap:
sudo apt-get install build-essential zlib1g-dev libreadline-dev bubblewrap2. Sao chép kho mã
git clone https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent.git
cd aibuildai-llm-posttrain-agent
3. Tạo môi trường ảo Python
python -m venv .venv
source .venv/bin/activate
4. Cài đặt các dependency được ghim phiên bản
pip install -r requirements.lock
pip install -e . --no-deps
Bản cài đặt editable cung cấp lệnh aibuildai. Hãy sử dụng tệp lock vì phiên bản claude-agent-sdk được ghim là phiên bản đã được xác minh cho codebase này.
Nếu dự định chỉnh sửa kho mã và chạy cổng kiểm tra chất lượng, hãy cài đặt thêm các dependency phát triển:
pip install -r requirements-dev.lock5. Tùy chọn chuẩn bị các công cụ do hệ thống quản lý
Các công cụ có thể được tải xuống và xây dựng trong lần chạy đầu tiên. Để chuẩn bị trước, hãy thực thi:
aibuildai setupCấu hình quyền truy cập mô hình
Tùy chọn 1: Sử dụng thông tin đăng nhập Claude Code
claude auth loginTùy chọn 2: Cung cấp khóa API
export AIBUILDAI_API_KEY=sk-ant-...Nếu AIBUILDAI_API_KEY chưa được thiết lập, ứng dụng sẽ kiểm tra ANTHROPIC_AUTH_TOKEN, sau đó là ANTHROPIC_API_KEY.
Sử dụng endpoint tương thích với Anthropic khác
Đặt AIBUILDAI_BASE_URL thành endpoint và đặt khóa của endpoint đó vào AIBUILDAI_API_KEY:
export AIBUILDAI_BASE_URL=https://openrouter.ai/api
export AIBUILDAI_API_KEY=your-key
export AIBUILDAI_SMALL_FAST_MODEL=provider/model-id
Các mã định danh mô hình đơn giản bắt đầu bằng deepseek- sẽ tự động nhắm đến endpoint tương thích với Anthropic của DeepSeek. Mã định danh mô hình OpenRouter bao gồm tiền tố nhà cung cấp và yêu cầu cả AIBUILDAI_BASE_URL lẫn AIBUILDAI_SMALL_FAST_MODEL.
Nếu endpoint sử dụng tên khác cho các cấp mô hình Claude, hãy ánh xạ chúng bằng AIBUILDAI_HAIKU_MODEL, AIBUILDAI_SONNET_MODEL và AIBUILDAI_OPUS_MODEL. Sử dụng AIBUILDAI_SUBAGENT_MODEL khi các tác nhân phụ cần chạy một mô hình khác với mô hình đã cấu hình cho vai trò của chúng.
Cài đặt dịch vụ tùy chọn
AIBUILDAI_KB_BASE_URLchọn dịch vụ MCP cơ sở kiến thức. Theo mặc định, máy khách sử dụng bản chụp cố định công khai của dự án.AIBUILDAI_KB_TOKENcung cấp bearer token nếu dịch vụ kiến thức yêu cầu xác thực.AIBUILDAI_WEB_PORTchọn cổng dịch vụ workspace cục bộ.AIBUILDAI_WEB_NAMEđặt tên cho dịch vụ workspace thứ hai trên cùng máy chủ và yêu cầu chỉ định rõ cổng web.
Tạo và khởi chạy một lần chạy cơ bản
Mỗi lần chạy được mô tả bằng một tệp YAML. Tạo cấu hình khởi đầu có tài liệu bằng:
aibuildai config > task.yamlTệp được tạo bao gồm mọi trường cấu hình, giá trị mặc định và tài liệu tương ứng. Các phần cấp cao nhất bắt buộc là run, llm, work_units, search và resources; cấu hình khởi đầu sẽ điền sẵn các phần này.
Khởi chạy lần chạy bằng:
aibuildai run task.yamlLệnh này in ra một URL workspace tương tự http://127.0.0.1:<port>/run/<run-id>. Mở URL đó để theo dõi trực tiếp. Trình duyệt là tùy chọn và quá trình thực thi vẫn tiếp tục bình thường nếu không mở trình duyệt.
Chạy ví dụ GSM8K
Ví dụ đi kèm thực hiện post-training cho Qwen/Qwen3-1.7B-Base để giải các bài toán có lời văn ở cấp tiểu học từ GSM8K. Theo repository, ví dụ này mất khoảng hai giờ trên một GPU.
1. Xây dựng thư mục tác vụ
bash examples/gsm8k-qwen3-1.7b-base/setup.sh ~/gsm8k-exampleQuá trình thiết lập tải xuống khoảng 4 GB, bao gồm trọng số mô hình cơ sở và cả hai phần dữ liệu GSM8K. Nó ghi câu lệnh tác vụ và bộ chấm điểm cố định vào ~/gsm8k-example/task/, đồng thời làm nóng bộ nhớ đệm pip cho các gói được cài vào môi trường Program riêng của lần chạy.
Thư mục tác vụ kết quả chứa trọng số cơ sở mà tác nhân có thể tinh chỉnh, 7.473 bài toán huấn luyện, bộ chấm điểm và phần kiểm thử gồm 1.319 bài toán được bộ chấm điểm sử dụng.
2. Bắt đầu post-training
aibuildai run ~/gsm8k-example/task.yamlVí dụ này sử dụng tìm kiếm meta, thời gian khám phá tối đa 90 phút và ngân sách tương ứng cho mỗi tác nhân. README khuyến nghị tăng các ngân sách đó cho một lần chạy nghiêm túc.
3. Hiểu hợp đồng chấm điểm
Bộ chấm điểm là định nghĩa đầy đủ về thành công. Nó đưa cho mô hình một câu hỏi kèm tiền tố câu trả lời, giải mã theo chiến lược tham lam và trích xuất số sau #### cuối cùng. README cho biết mô hình cơ sở đạt 0.105 trên 200 bài toán kiểm thử đầu tiên vì mô hình cơ sở chưa tinh chỉnh ban đầu không tuân theo định dạng câu trả lời bắt buộc.
4. Đánh giá mô hình cuối cùng
Sản phẩm bàn giao là một thư mục mô hình đã hợp nhất. Thay <run-home> bằng tên thư mục lần chạy được tạo và đánh giá tất cả ví dụ kiểm thử bằng môi trường Program của lần chạy:
H=~/gsm8k-example/playground/gsm8k-qwen3-1.7b-base/<run-home>
$H/program-environment/env/bin/python ~/gsm8k-example/task/grade/evaluate.py --model-path $H/deliverable/final_model --limit -1
Sử dụng tác nhân với tác vụ riêng
- Sao chép
examples/gsm8k-qwen3-1.7b-base.yamlhoặc tạo cấu hình khởi đầu đầy đủ bằngaibuildai config. - Tạo một thư mục tác vụ chứa mọi thứ mà lần chạy có thể sử dụng.
- Đưa vào một mô tả tác vụ dễ đọc, chẳng hạn README, câu lệnh tác vụ hoặc bài báo, cùng mọi tệp dữ liệu bắt buộc.
- Đặt
run.data_rootthành thư mục đó. - Kiểm tra các cài đặt mô hình, tìm kiếm, ngân sách, đơn vị công việc và tài nguyên.
- Khởi chạy tệp YAML bằng
aibuildai run.
Trong quá trình thiết lập, hệ thống đọc toàn bộ thư mục tác vụ, đóng băng câu lệnh thành README của lần chạy và xây dựng chương trình chấm điểm của lần chạy từ đó. Vì vậy, thư mục tác vụ phải đầy đủ và xác định rõ sản phẩm bàn giao cũng như phương pháp đánh giá dự kiến.
Cấu hình cũng hỗ trợ run.setup_from_scratch và run.task_prompt. Các cài đặt này cho phép Setup lấy dữ liệu và kết quả đánh giá từ câu lệnh tác vụ thay vì bắt đầu với một thư mục tác vụ đã chuẩn bị.
Các lựa chọn cấu hình quan trọng
Lựa chọn mô hình
llm.default.model chọn mô hình cơ sở được các tác nhân sử dụng. Có thể điều chỉnh khả năng suy luận bằng các cài đặt như effort và max_thinking_tokens. Sử dụng llm.by_role để cố định mô hình cho từng vai trò, hoặc llm.auto để bộ định tuyến tự chọn theo vai trò.
Phương thức tìm kiếm
search.kind kiểm soát chiến lược thử nghiệm. Các giá trị được README mô tả và hỗ trợ gồm:
meta, trong đó một tác nhân meta viết chương trình tìm kiếm dành riêng cho tác vụ.nb_tree, tìm kiếm trên toàn bộ cây thử nghiệm.nb.tree, mặc định trong starter tổng quát.linear.parallel.
Nội dung của search.input phụ thuộc vào chiến lược được chọn. Tìm kiếm meta chấp nhận tùy chọn report, trong khi các chiến lược cố định sử dụng tham số riêng và có thể bao gồm parallel cùng early_stopping.
Giới hạn thời gian và chi phí
run.budget.wall_clock_minutes mặc định là 1.440 phút. Khi đạt đến giới hạn, hệ thống không bắt đầu quá trình khám phá mới, nhưng các công việc đang thực hiện và quá trình bàn giao vẫn được phép hoàn tất. run.budget.cost_usd cung cấp giới hạn chi phí mềm tùy chọn ở cấp độ lượt chạy.
Mỗi mục trong work_units có ngân sách riêng. Một đơn vị công việc có thể sử dụng số phút cố định, thời gian được điều chỉnh theo độ sâu, hoặc thời lượng dự kiến kèm khoảng đệm.
Giới hạn tài nguyên
Sử dụng resources.work_unit.cpu_max_cores và resources.work_unit.memory_max_gb để áp đặt giới hạn cứng về CPU và bộ nhớ cho từng đơn vị công việc. Mỗi đơn vị chạy trong một sandbox bubblewrap với giới hạn cgroup về bộ nhớ và tiến trình, trong khi thư mục tác vụ được gắn ở chế độ chỉ đọc.
Mẹo nâng cao
Bật truy xuất tri thức
Thêm cấu hình MCP kb khi muốn các tác nhân tham khảo AIBuildAI Knowledge Base. Client cung cấp các công cụ để tìm kiếm kỹ năng, tải một kỹ năng và đọc tài liệu tham khảo. Kho ngữ liệu bao gồm hướng dẫn quy trình, thẻ phương pháp, thẻ tập dữ liệu và thẻ framework.
Dịch vụ công khai mặc định sử dụng một ảnh chụp cố định của kho ngữ liệu. Để lưu trữ phiên bản riêng, hãy triển khai kho lưu trữ knowledge-base mã nguồn mở và trỏ AIBUILDAI_KB_BASE_URL đến đó.
Chọn tìm kiếm meta cho cấu trúc liên kết dành riêng cho tác vụ
Tìm kiếm cây cố định không thể biểu đạt tự nhiên mọi quy trình, chẳng hạn như chạy một lượt quét trước khi huấn luyện, tổ chức giải đấu sau đó hoặc kết hợp nhiều mô hình. Với search.kind: meta, một tác nhân meta sẽ điều tra tác vụ, có thể chạy các thử nghiệm thí điểm, tham khảo các kỹ năng thiết kế đi kèm và knowledge base, rồi viết một gói tìm kiếm Python.
Gói được tạo thành từ ba nguyên tố cơ bản:
- Agent: Một phiên LLM với các công cụ, chính sách và đầu ra có kiểu.
- Program: Một phép tính xác định trong worker được quản lý với các giới hạn tài nguyên riêng.
- Search: Một bộ điều phối có thể khởi chạy và phối hợp các Agent, Program và Search lồng nhau bằng đầu vào và đầu ra có kiểu.
Gói được xác minh và có thể được xem xét tùy chọn bằng báo cáo thiết kế LaTeX. Sau đó, gói chạy như một lượt tìm kiếm con trong cùng lượt chạy có ghi nhật ký. Bất kể cấu trúc liên kết là gì, giá trị của lượt chạy vẫn là điểm số tốt nhất mà bất kỳ nút nào đạt được.
Xây dựng bộ nhớ cục bộ có thể tái sử dụng
Sau khi tích lũy các lượt chạy cho một tác vụ, hãy hợp nhất bài học từ chúng vào một tài liệu bộ nhớ cục bộ có thể chỉnh sửa:
aibuildai memorize task.yamlĐặt memory.enable để đưa bộ nhớ cục bộ đó vào mọi tác nhân. Kiến thức học được từ các lượt chạy của bạn vẫn nằm trên máy và không được thêm vào knowledge base từ xa.
Kiểm soát công cụ bên ngoài
Sử dụng disallowed_tools để ngăn mọi vai trò sử dụng các công cụ tích hợp được chọn. Ví dụ, một tác vụ có thể cấm WebSearch và WebFetch khi các quy tắc đánh giá yêu cầu quy trình ngoại tuyến.
Thêm tích hợp MCP
Cấu hình mcps có thể bật knowledge base, tính năng nộp bài thi Kaggle hoặc các máy chủ MCP tùy chỉnh. Tích hợp Kaggle hỗ trợ cài đặt số lần nộp tối đa trong submission.max_submissions.
Tạo bài báo
Bật writer.enable để soạn bản nháp bài báo sau khi tổng hợp, hoặc chạy lệnh tạo bài báo trên thư mục của một lượt chạy đã hoàn tất:
aibuildai write-paper <run-dir>Lệnh này soạn bài báo từ lượt chạy đã hoàn tất và biên dịch thành PDF.
Xác thực các thay đổi mã nguồn
Nhánh dự án này không bao gồm bộ kiểm thử. Cổng kiểm tra của kho lưu trữ là:
./check.shCổng kiểm tra chạy pyright, ruff, semgrep và kiểm tra sai lệch tệp khóa. Hãy cài đặt requirements-dev.lock trước khi sử dụng.
Tìm hiểu đầu ra của lượt chạy
Mỗi lượt chạy tạo một thư mục chính bên dưới thư mục playground gốc đã cấu hình:
{playground_root}/<task-name>/<timestamp>_<run-id>/
  run_config.json
  public/
  private/
  deliverable/
  workspace/
  program-environment/
resource_samples.jsonlrun_config.jsonchứa cấu hình cuối cùng và ID lượt chạy được sử dụng để tiếp tục.public/chứa README đóng băng và dữ liệu do Setup chuẩn bị cho các ứng viên.private/chứa chương trình chấm điểm, tệp kê khai chỉ số, lần thử cơ sở và bản ghi kết quả tốt nhất.deliverable/chứa gói mô hình có thể chạy hoặc một kết quả khác do tác vụ xác định.workspace/chứa các lần thử, tạo tác, dữ liệu tạm và các thư mục làm việc theo từng lượt tìm kiếm.program-environment/chứa môi trường Program biệt lập của lượt chạy.resource_samples.jsonlghi lại các phép đo tài nguyên máy chủ được thu thập trong quá trình thực thi.
Kết luận
AIBuildAI LLM-Post-Train Agent cung cấp một hệ thống đầu cuối để thiết kế, chạy, đánh giá và tinh chỉnh các quy trình hậu huấn luyện mô hình. Hãy bắt đầu với ví dụ GSM8K được cung cấp để xác minh quá trình cài đặt và tìm hiểu cấu trúc chạy. Sau đó, xác định thư mục tác vụ và bộ chấm điểm rõ ràng, chọn chiến lược tìm kiếm phù hợp, thiết lập ngân sách và giới hạn tài nguyên thực tế, rồi sử dụng không gian làm việc trực tiếp để theo dõi các thử nghiệm được tạo ra.
Để biết thêm chi tiết về kiến trúc, hãy tham khảo tài liệu kiến trúc của kho lưu trữ. Dự án được phân phối theo Giấy phép Apache 2.0.