

NamiGPT là gì
NamiGPT là một khóa hướng dẫn nền tảng về mô hình ngôn ngữ lớn dành cho người mới bắt đầu học tiếng Trung. Dự án sử dụng PyTorch để tự triển khai GPT-2 từ đầu, không gọi các mô-đun Transformer có sẵn, đồng thời có thể tải trọng số tiền huấn luyện chính thức của OpenAI để suy luận và tạo văn bản.
Dự án không đặt hiệu suất huấn luyện làm mục tiêu hàng đầu mà nhấn mạnh khả năng thấu hiểu: mô hình cốt lõi nằm trong gpt2/model.py, với chưa đến 200 dòng mã; khóa học sử dụng ví dụ ba từ “mèo ăn cá” làm mạch dẫn, từng bước tách nhỏ quá trình token hóa, vector, ma trận attention và tạo văn bản cuối cùng.
Tên NamiGPT lấy cảm hứng từ nanoGPT của Karpathy. Dự án tập trung hơn vào việc giảng dạy cho người mới bắt đầu từ con số 0, giải thích từng bước của GPT-2 thông qua các ví dụ tối giản.
Bạn sẽ học được gì
- Tokenizer chuyển văn bản thành token ID như thế nào.
- Embedding và mã hóa vị trí xây dựng đầu vào cho mô hình ra sao.
- Self-Attention và Multi-Head Attention được tính toán như thế nào.
- Kết nối residual, LayerNorm, FFN và các hàm kích hoạt đảm nhiệm những vai trò gì.
- Nhiều Transformer Block được xếp chồng để tạo thành GPT-2 như thế nào.
- Cách nạp trọng số chính thức của OpenAI vào mô hình tự triển khai.
- Cách sử dụng các chiến lược greedy, temperature và top-k để tạo văn bản.
- Cách dùng kiểm thử để xác minh triển khai tự viết cho kết quả nhất quán với triển khai của HuggingFace.
Đặc điểm chính của dự án
Tự triển khai các thành phần cốt lõi từ đầu
NamiGPT không trực tiếp gọi các mô-đun Transformer có sẵn. Mô hình bao gồm các thành phần LayerNorm, Attention, FFN, Block và GPT, phù hợp để đọc từng dòng và theo dõi cách dữ liệu cùng tensor truyền qua mô hình.
Các tập lệnh theo chương có thể chạy độc lập
Phần suy luận gồm 15 chủ đề được trình bày từng bước, bao gồm tokenizer, Embedding, mã hóa vị trí, self-attention, multi-head attention, kết nối residual, chuẩn hóa lớp, mạng truyền thẳng, hàm kích hoạt, Transformer Block, xếp chồng, nạp trọng số, tạo văn bản và khả năng giải thích. Mỗi chủ đề đều đi kèm một tập lệnh có thể chạy tương ứng.
Cung cấp trực quan hóa tương tác
Dự án cung cấp ảnh động về kiến trúc Transformer và công cụ trực quan hóa đầy đủ các ma trận suy luận. Khi gặp đoạn mã hoặc công thức khó hiểu, bạn có thể quan sát cách các phần tử ma trận trong ví dụ “mèo ăn cá” được tính toán lần lượt theo từng ô.
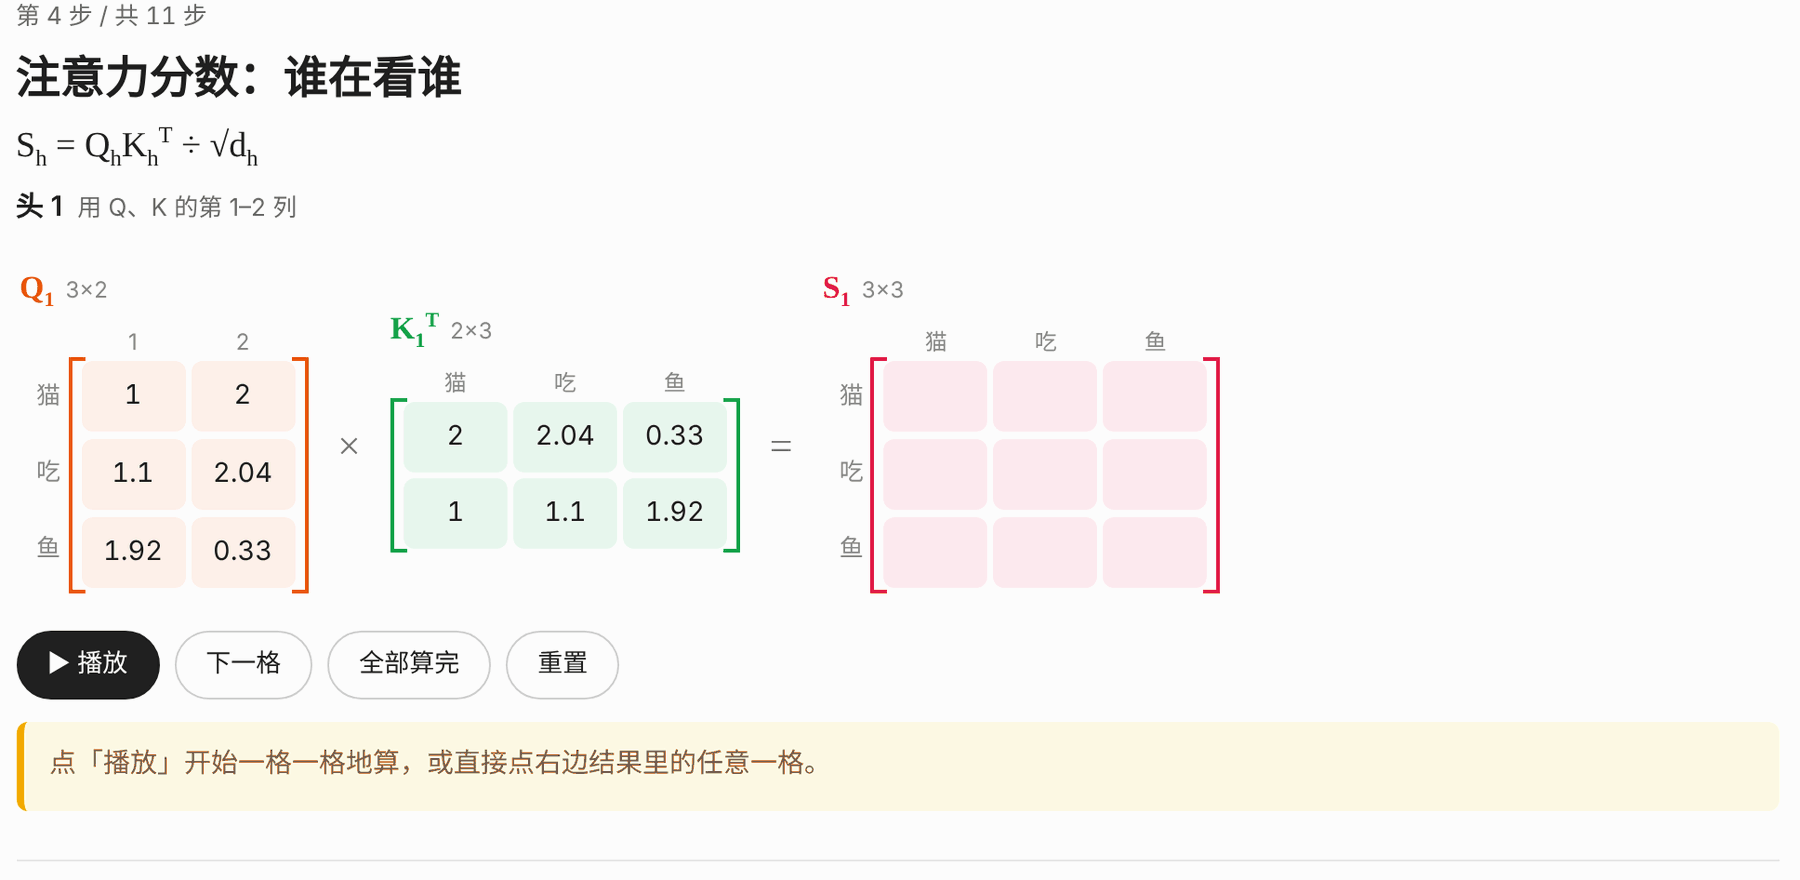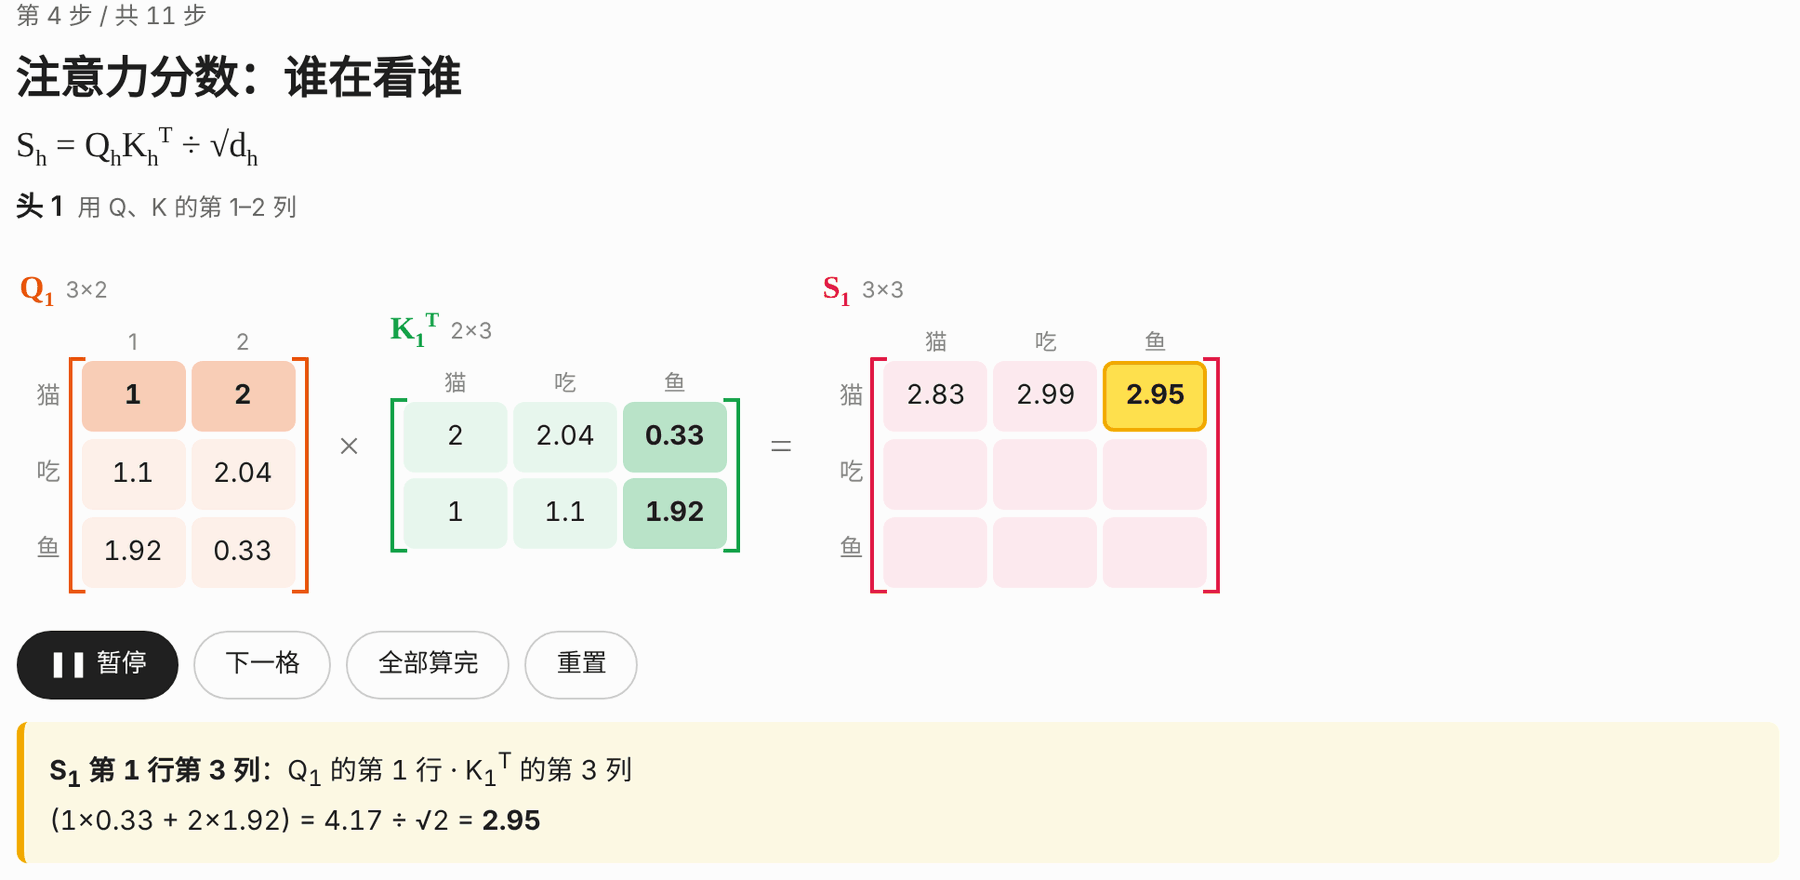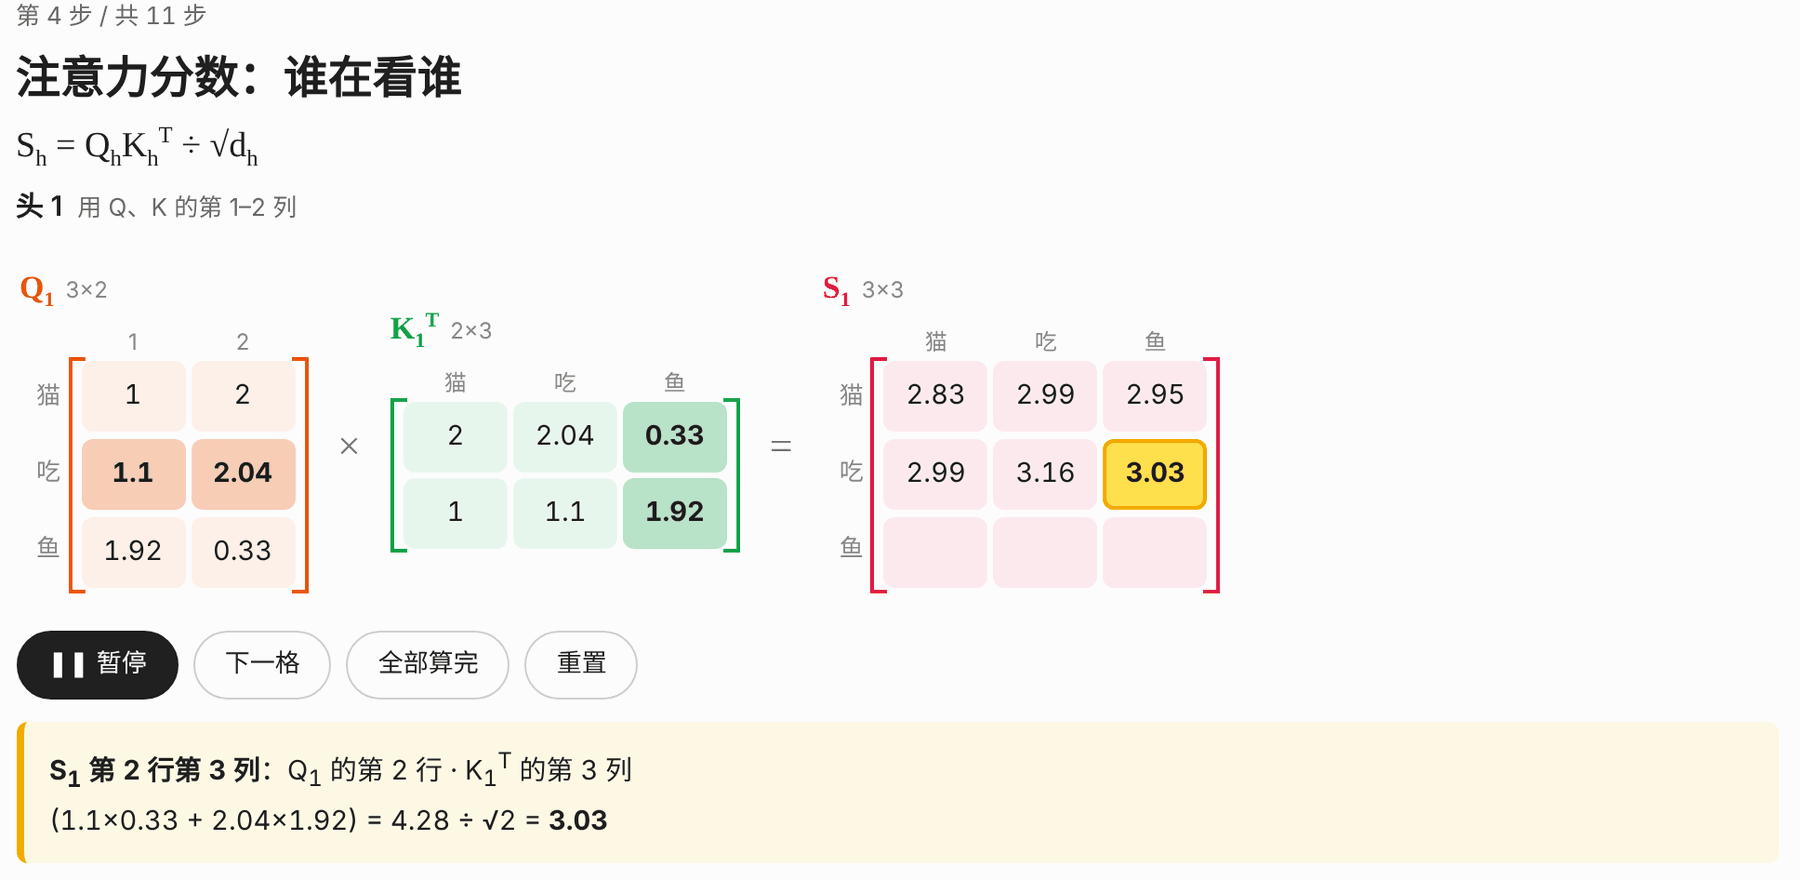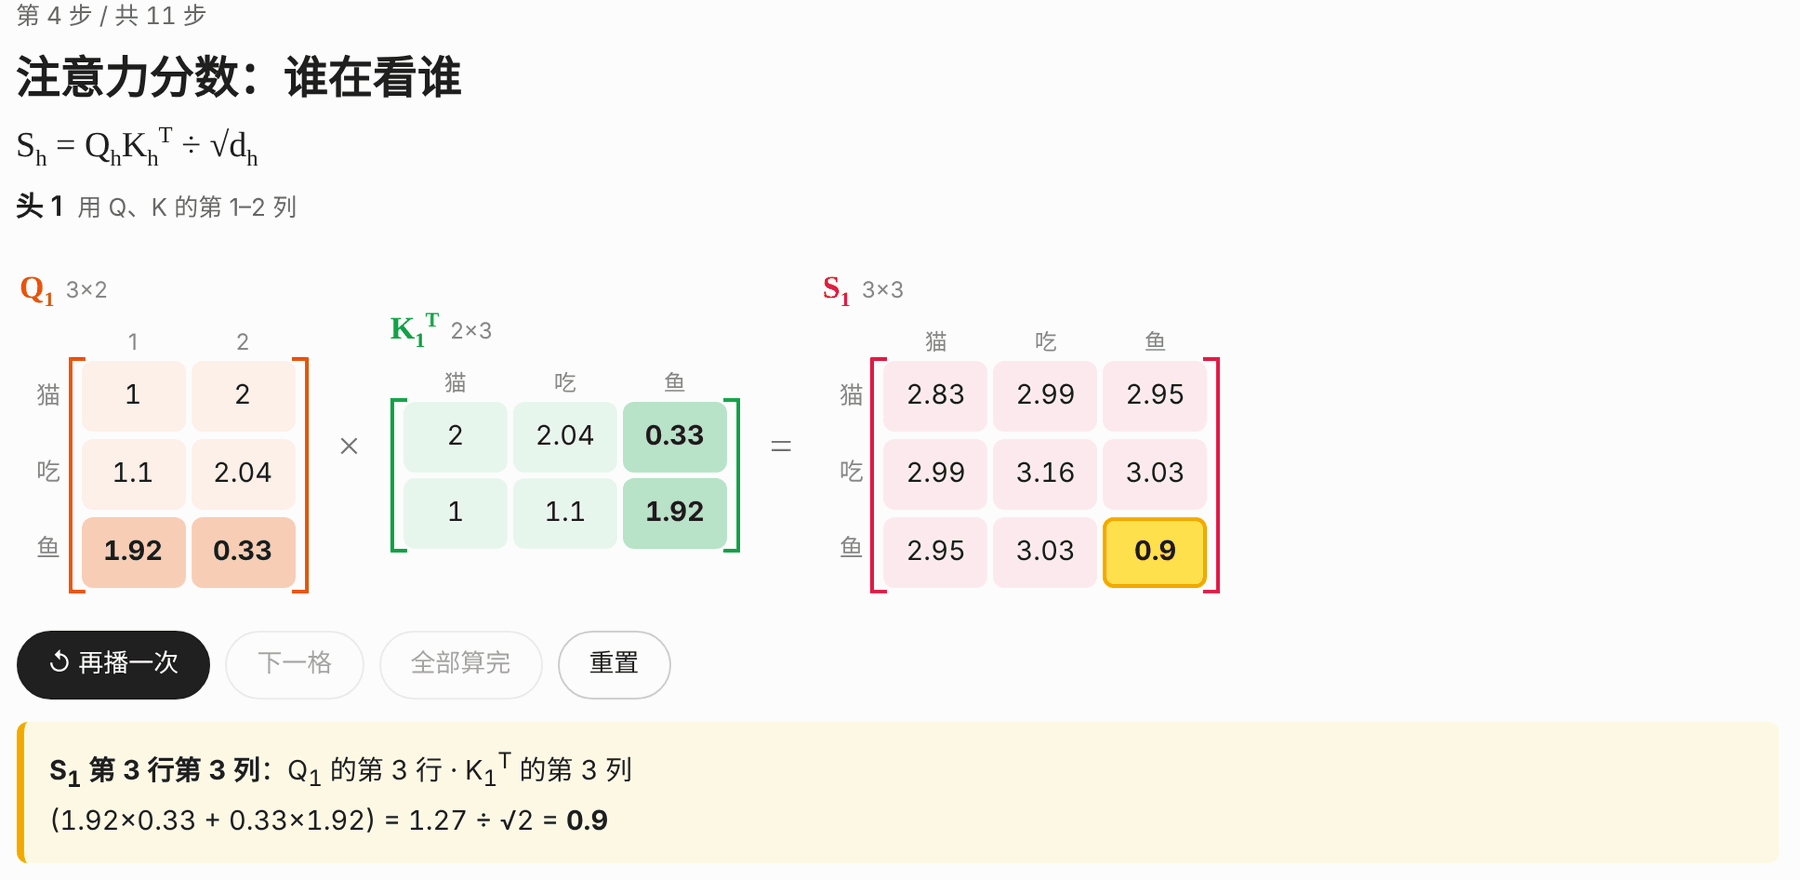
Bạn nên xem trước Hiểu Transformer qua một hình ảnh, sau đó sử dụng Trực quan hóa suy luận mô hình ngôn ngữ lớn để đối chiếu với mã nguồn trong các chương.
Đồng nhất kết quả với HuggingFace
Kho mã bao gồm kiểm tra hình dạng và các bài kiểm thử đối chiếu với triển khai chính thức của HuggingFace. Ngoài việc nhanh chóng so sánh bằng trọng số ngẫu nhiên, bạn cũng có thể tải trọng số GPT-2 thực tế để kiểm chứng thêm.
Chuẩn bị trước khi cài đặt
Trước khi bắt đầu, bạn cần có khả năng đọc hiểu Python cơ bản và nắm được các khái niệm đại số tuyến tính cơ bản như phép nhân ma trận. Môi trường chạy được dự án ghi rõ là Python 3.9 trở lên và PyTorch 2.x.
Trước tiên, hãy sao chép kho mã, đi vào thư mục dự án và cài đặt các phụ thuộc:
git clone https://github.com/aa1143/NamiGPT.git
cd NamiGPT
pip install -r requirements.txt
Nếu mạng bị hạn chế khi tải trọng số chính thức từ HuggingFace, bạn có thể đặt địa chỉ mirror trong terminal hiện tại:
export HF_ENDPOINT=https://hf-mirror.comMirror này chỉ được dùng để tải trọng số chính thức. Khi gọi from_pretrained sau đó, cấu trúc mô hình vẫn đến từ triển khai tự viết của NamiGPT.
Bước 1: Tìm hiểu GPT-2 theo từng chương
Cách phù hợp nhất cho người mới bắt đầu không phải là đọc ngay toàn bộ mô hình, mà là học từng chương theo luồng dữ liệu suy luận:
- Giai đoạn đầu vào: Nắm vững Tokenizer, Embedding và mã hóa vị trí.
- Giai đoạn attention: Hiểu Self-Attention, sau đó mở rộng đến Multi-Head Attention.
- Giai đoạn mô-đun: Học về kết nối residual, LayerNorm, FFN và các hàm kích hoạt.
- Giai đoạn mô hình: Kết hợp các thành phần thành Transformer Block, rồi xếp chồng chúng thành GPT-2 hoàn chỉnh.
- Giai đoạn ứng dụng: Nạp trọng số chính thức, tạo văn bản và xem kết quả giải thích.
Mỗi tập lệnh đều có thể chạy độc lập. Ví dụ, để chạy chương về multi-head attention:
python chapters/01-inference/ep06_multi_head_attention.pyNội dung đầy đủ bằng hình ảnh và văn bản có thể xem trong hướng dẫn NamiGPT bằng hình ảnh và văn bản; bản thảo gốc trong kho nằm tại docs/01-inference/.
Bước 2: Tải GPT-2 và tạo văn bản
Sau khi cài đặt xong, bạn có thể trực tiếp import giao diện nạp mô hình và tạo văn bản do NamiGPT cung cấp. Ví dụ dưới đây sử dụng tokenizer GPT-2 để mã hóa câu nhắc tiếng Anh thành token ID, sau đó nạp mô hình tự viết cùng trọng số chính thức 124M:
import tiktoken, torch
from gpt2 import from_pretrained, generate

enc = tiktoken.get_encoding("gpt2")
model = from_pretrained("gpt2")

ids = torch.tensor([enc.encode("The cat sat on the")])
out = generate(
    model,
    ids,
    max_new_tokens=30,
    temperature=0.8,
    top_k=50,
)
print(enc.decode(out[0].tolist()))
Quy trình thực thi mã
tiktoken.get_encoding("gpt2")lấy encoder được GPT-2 sử dụng.enc.encode(...)chuyển văn bản nhắc thành token ID.torch.tensorđóng gói ID thành tensor batch mà mô hình cần.from_pretrained("gpt2")tạo GPT-2 tự viết và nạp trọng số chính thức 124M.generatetạo tối đa 30 token mới sau văn bản nhắc.enc.decodekhôi phục token ID đầu ra thành văn bản.
Lưu ý: GPT-2 chưa được tinh chỉnh cho hội thoại. Mô hình giỏi tiếp tục viết dựa trên nội dung đã có, chứ không trả lời câu hỏi như mô hình trò chuyện. Dữ liệu huấn luyện chủ yếu bằng tiếng Anh, vì vậy trước tiên nên sử dụng câu nhắc tiếng Anh.
Bước 3: Tìm hiểu các tham số tạo văn bản
Ví dụ sử dụng hai tham số lấy mẫu quan trọng:
temperature=0.8: Điều chỉnh phân phối xác suất của các token ứng viên. Mô-đun tạo văn bản của dự án hỗ trợ chiến lược temperature.top_k=50: Chỉ chọn trong 50 token ứng viên có xác suất cao nhất. Dự án đồng thời hỗ trợ tạo văn bản greedy và top-k.
Khi học, bạn có thể giữ nguyên văn bản nhắc, chỉ điều chỉnh temperature hoặc top-k rồi so sánh kết quả viết tiếp. Cách này giúp quan sát trực quan tác động của chiến lược tạo văn bản đến đầu ra, nhưng các tham số cụ thể nên được chọn theo mục tiêu thí nghiệm.
Bước 4: Khởi chạy bản demo web Gradio
Nếu muốn nhập câu nhắc trong trình duyệt và xem kết quả viết tiếp cùng xác suất của các từ ứng viên ở từng bước, bạn có thể cài đặt Gradio và khởi chạy chương trình demo trong kho mã:
pip install gradio
python demo/app.py
Bản demo web phù hợp để quan sát dự đoán của mô hình ở từng bước, còn các tập lệnh theo chương phù hợp hơn để nghiên cứu quá trình tính toán của từng thành phần. Kết hợp cả hai giúp liên hệ văn bản cuối cùng với sự thay đổi xác suất bên trong mô hình.
Bước 5: Chạy kiểm thử
Nên chạy kiểm thử sau khi sửa attention, logic nạp trọng số hoặc logic tạo văn bản. Kiểm thử mặc định sử dụng trọng số ngẫu nhiên để so sánh, không cần tải mô hình tiền huấn luyện và thường hoàn tất khá nhanh:
pytest tests/ -vNếu muốn sử dụng trọng số GPT-2 thực tế để đối chiếu thêm, có thể chạy:
TEST_PRETRAINED=1 pytest tests/ -vLệnh thứ hai sẽ tải thêm trọng số thực tế, vì vậy lần chạy đầu tiên cần chờ quá trình tải hoàn tất.
Tổng quan cấu trúc kho mã
gpt2/config.py: Cấu hình mô hình, bao gồm các quy mô 124M, 355M, 774M và 1.5B.gpt2/model.py: LayerNorm, Attention, FFN, Block và phần thân mô hình GPT.gpt2/load_weights.py: Nạp trọng số chính thức vào mô hình tự viết.gpt2/generate.py: Logic tạo văn bản greedy, temperature và top-k.chapters/01-inference/: Các tập lệnh demo tương ứng với từng chương hướng dẫn.docs/01-inference/: Bản thảo gốc của các bài hướng dẫn.demo/app.py: Bản demo web Gradio.tests/: Kiểm tra hình dạng và kiểm thử đối chiếu với HuggingFace.
Kỹ thuật nâng cao: ba chi tiết then chốt khi đối chiếu với HuggingFace
1. Áp dụng đúng causal mask
GPT-2 là mô hình ngôn ngữ tự hồi quy. Mỗi từ trong chuỗi chỉ có thể đọc chính nó và các từ đứng trước, không thể nhìn trước các token phía sau. Nếu bỏ qua causal mask, đầu ra của mô hình vẫn sẽ sai ngay cả khi đã nạp thành công trọng số chính thức.
2. Xử lý phép chuyển vị khi chuyển trọng số
Triển khai GPT-2 ban đầu sử dụng Conv1D, với hình dạng trọng số là [in, out]; nn.Linear của PyTorch sử dụng [out, in]. Vì vậy, khi nạp tham số chính thức vào lớp tuyến tính tự viết, bắt buộc phải chuyển vị.
Ngoài ra, c_attn ghép các tham số của Query, Key và Value lại với nhau. Khi đối chiếu với triển khai tự viết, cần tách chúng thành ba phần tương ứng trước, sau đó đặt vào đúng vị trí.
3. Sử dụng phiên bản GELU xấp xỉ bằng tanh
GPT-2 sử dụng phiên bản GELU xấp xỉ bằng tanh, trong khi nn.GELU() của PyTorch mặc định sử dụng phiên bản chính xác. Để đối chiếu từng phần, cần thiết lập:
nn.GELU(approximate="tanh")Ba chi tiết này có vẻ nhỏ nhưng sẽ ảnh hưởng trực tiếp đến khả năng tái tạo kết quả của triển khai chính thức bằng mô hình tự viết. Khi xác định lỗi, có thể lần lượt kiểm tra mask, hình dạng tham số và phiên bản hàm kích hoạt.
Phương pháp học và gỡ lỗi được đề xuất
- Trước tiên, sử dụng ảnh động về kiến trúc để hiểu mối quan hệ tổng thể rằng GPT-2 chỉ sử dụng phần decoder của Transformer.
- Chạy tập lệnh của chương hiện tại, ghi lại hình dạng của đầu vào, đầu ra và các tensor trung gian.
- Khi khó hiểu ma trận attention, đối chiếu với công cụ trực quan hóa ma trận trực tuyến và kiểm tra từng ô.
- Sau khi hoàn thành một thành phần, đọc phần triển khai tương ứng trong
gpt2/model.py. - Sau khi sửa triển khai, trước tiên chạy kiểm thử với trọng số ngẫu nhiên, rồi tùy nhu cầu chạy kiểm thử với trọng số thực tế.
- Cuối cùng, sử dụng ví dụ tạo văn bản và trang Gradio để quan sát hoạt động của mô hình hoàn chỉnh.
Trình tự này kết nối sơ đồ kiến trúc, phép tính ma trận, mã nguồn theo chương, mô hình hoàn chỉnh và đầu ra cuối cùng, giúp tránh bị choáng ngợp bởi cấu trúc nhiều lớp của GPT-2 ngay từ đầu.
Tóm tắt
NamiGPT cung cấp một lộ trình học tập từ các phép tính ma trận cơ bản đến suy luận GPT-2 hoàn chỉnh. Bạn có thể bắt đầu bằng cách chạy các tập lệnh của từng chương độc lập để hiểu từng thành phần, sau đó tải trọng số chính thức của OpenAI để hoàn thành việc tiếp nối văn bản tiếng Anh, và cuối cùng xác minh sự hiểu biết cũng như các thay đổi của mình thông qua trực quan hóa và các bài kiểm tra đối chiếu với HuggingFace.
Mã nguồn của dự án được phát hành theo giấy phép MIT; các bài viết trong thư mục docs/ được phát hành theo giấy phép CC BY-NC 4.0, khi đăng lại phải ghi rõ nguồn và không được sử dụng cho mục đích thương mại.