
LLaMA Factory (hiện đã đổi tên thành LlamaFactory) là một framework tinh chỉnh thống nhất dành cho các mô hình ngôn ngữ lớn. Dự án được khởi xướng bởi nhóm của Tiến sĩ Zheng Yaowei tại Đại học Hàng không Vũ trụ Bắc Kinh và có nền tảng học thuật từ bài báo ACL 2024. Framework áp dụng thiết kế “CLI không cần viết mã + Web UI”, nhằm đơn giản hóa quy trình tinh chỉnh. LlamaFactory đã tích lũy hơn 72 000 Stars trên GitHub và trở thành một triển khai tham chiếu trong lĩnh vực tinh chỉnh mô hình lớn.
>
I. Tổng quan dự án
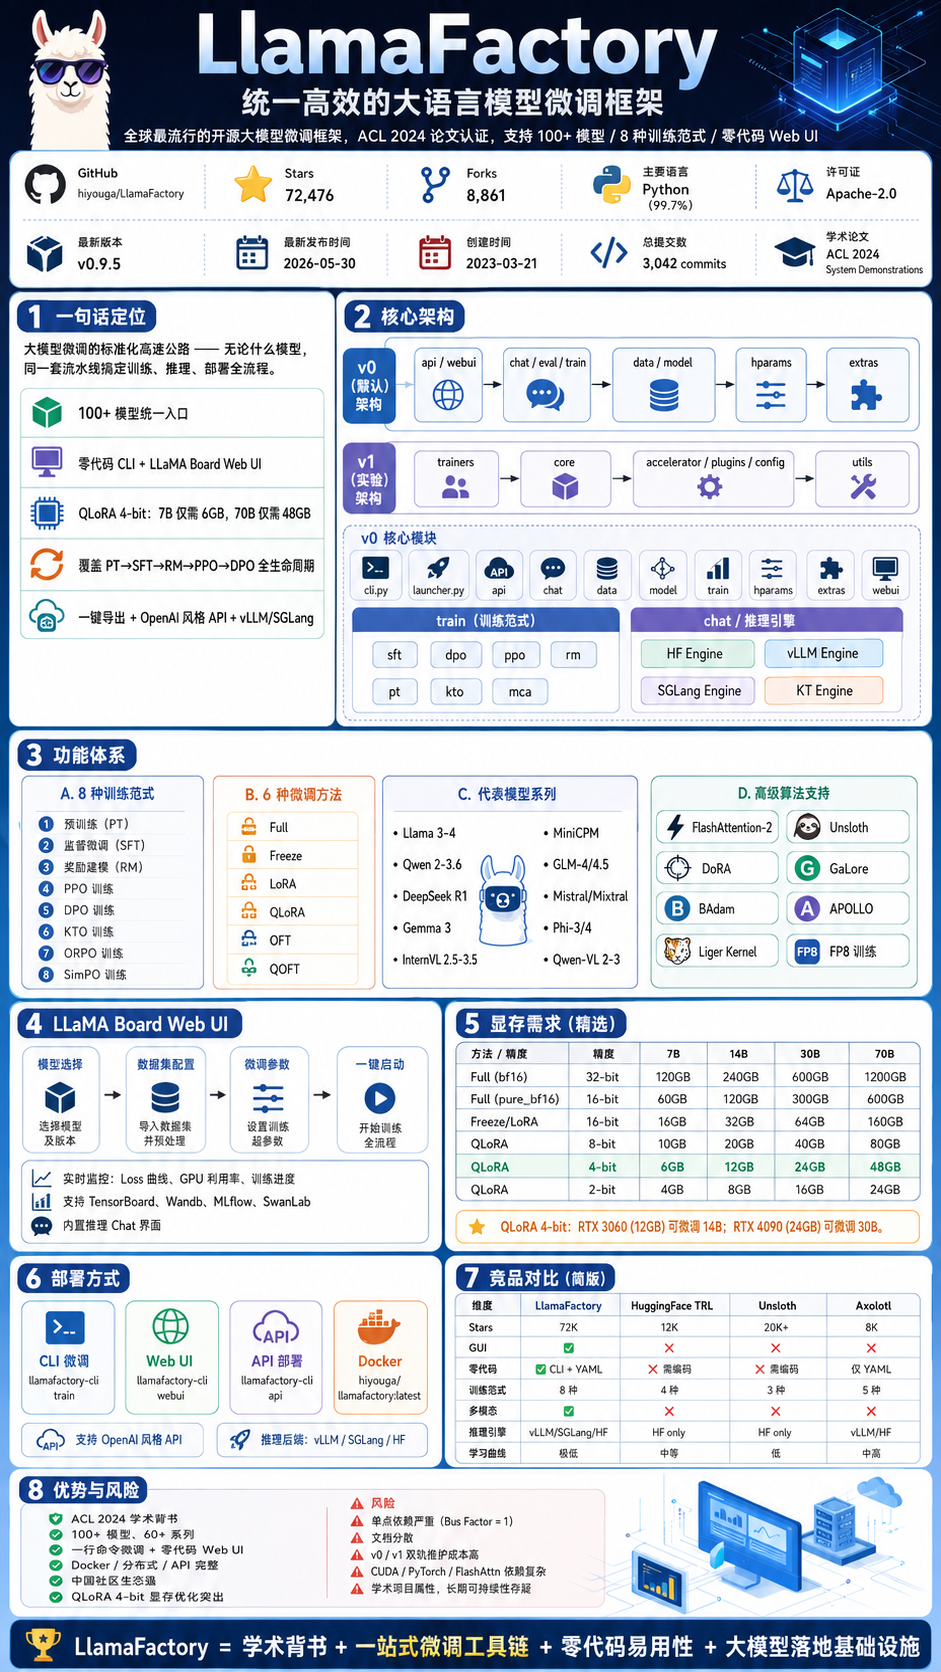
Hạng mục|Chi tiết
Tên đầy đủ|LlamaFactory (tên cũ LLaMA-Factory)
Địa chỉ GitHub|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
Ngôn ngữ chính|Python (99.7%)
Giấy phép|Apache-2.0
Thời gian tạo|2023-03-21
Phiên bản mới nhất|v0.9.5 (2026-05-30)
Tổng số commit|3,042 commits
Đóng góp viên chủ chốt|hiyouga (Zheng Yaowei, 2,188 commits, chiếm 72% tổng số commit)
Bài báo học thuật|ACL 2024 System Demonstrations
Kích thước kho lưu trữ|~412.9 MB
Issue đang mở|57
Nhà sáng lập Zheng Yaowei (hiyouga) là nghiên cứu sinh tiến sĩ tại Đại học Hàng không Vũ trụ Bắc Kinh. Anh từng là tác giả thứ nhất của nhiều bài báo được công bố tại các hội nghị quốc tế hàng đầu như ACL, CVPR và WWW, đồng thời là người phản biện cho các hội nghị như AAAI và EMNLP. Các giải thưởng của anh bao gồm Huawei Cup, giải Nhất toàn quốc Blue Bridge Cup, Danh hiệu Nhân vật Sinh viên của Năm Đại học Hàng không Vũ trụ Bắc Kinh và Giải thưởng Đóng góp Xuất sắc cho Mã nguồn mở trong hệ sinh thái Ascend. Các thành viên trong nhóm hợp tác gồm các giáo sư Zhang Richong, Zhang Junhao, Ye Yanhan, Luo Zheyan, Feng Zhangchi, Ma Yongqiang của Đại học Hàng không Vũ trụ Bắc Kinh.
II. Định vị và giá trị cốt lõi của dự án
2.1 Định vị trong một câu
Quy trình tinh chỉnh mô hình lớn được tiêu chuẩn hóa: một quy trình thống nhất áp dụng cho mọi mô hình, bao quát toàn bộ các bước từ chuẩn bị dữ liệu, huấn luyện mô hình, xác minh suy luận đến triển khai.
2.2 Những vấn đề cốt lõi được giải quyết
Vấn đề|Giải pháp của LLaMA Factory
Quy trình tinh chỉnh của các mô hình khác nhau, chi phí chuyển đổi cao|Thiết kế "tách biệt" thuật toán-mô hình-dữ liệu, một cổng thống nhất cho hơn 100 mô hình
Ngưỡng kỹ thuật của mã tinh chỉnh cao, yêu cầu nền tảng chuyên môn về học sâu|CLI không cần viết mã + LLaMA Board Web UI (Gradio)
Thiếu VRAM, GPU dành cho người dùng phổ thông không thể huấn luyện mô hình lớn|QLoRA 4-bit: 7B chỉ cần 6GB, 70B chỉ cần 48GB
Cộng đồng mã nguồn mở thiếu chuỗi công cụ một cửa|Bao phủ toàn bộ vòng đời PT→SFT→RM→PPO→DPO
Triển khai suy luận phức tạp|Xuất mô hình một lần nhấp + API theo phong cách OpenAI + vLLM/SGLang
2.3 Triết lý thiết kế: "tách biệt" thuật toán-mô hình-dữ liệu
Trong một cuộc phỏng vấn độc quyền, Zheng Yaowei ví quá trình suy luận mô hình như những chiếc xe di chuyển trên một tuyến cao tốc được tiêu chuẩn hóa. Bản thân mô hình tương đương với các loại xe khác nhau, còn dữ liệu tương đương với hàng hóa được chở trên xe. Chỉ cần mô hình có thể vận hành thuận lợi trên tuyến cao tốc này, quá trình tinh chỉnh chỉ cần hoàn tất bằng cách điều chỉnh các tham số.
III. Phân tích chuyên sâu kiến trúc kỹ thuật
3.1 Thiết kế song song hai kiến trúc
LLaMA Factory đồng thời cung cấp hai kiến trúc v0 (bản ổn định) và v1 (bản thử nghiệm), có thể chuyển đổi giữa hai kiến trúc bằng cách thiết lập biến môi trường USE_V1.
v0 (mặc định): api/webui → chat/eval/train → data/model → hparams → extras
v1 (thử nghiệm): trainers → core → accelerator/plugins/config → utils
Kiến trúc v0 là triển khai chủ đạo hiện nay, cung cấp đầy đủ chức năng và tài liệu hoàn chỉnh. Kiến trúc v1 vẫn đang trong giai đoạn thử nghiệm, áp dụng thiết kế phân tầng có tính mô-đun cao hơn.
3.2 Giải thích chi tiết các mô-đun cốt lõi của v0
src/llamafactory/
├── cli.py              # Cổng CLI, phân phối lệnh llamafactory-cli
├── launcher.py          # Trình khởi chạy, phân phối theo USE_V1
├── api/                 # REST API theo phong cách OpenAI
│   ├── app.py           # Ứng dụng FastAPI
│   ├── chat.py          # Endpoint hội thoại
│   └── protocol.py      # Định nghĩa giao thức
├── chat/                # Lớp engine suy luận
│   ├── base_engine.py   # Lớp cơ sở trừu tượng
│   ├── hf_engine.py     # Suy luận gốc HuggingFace
│   ├── vllm_engine.py   # Suy luận hiệu năng cao vLLM
│   └── sglang_engine.py # Suy luận SGLang
├── data/                # Lớp xử lý dữ liệu
│   ├── template.py      # Đăng ký template Prompt cho hơn 100 mô hình
│   ├── mm_plugin.py     # Xử lý đa phương thức (hình ảnh/video/âm thanh)
│   ├── loader.py        # Trình tải tập dữ liệu
│   ├── processor/       # Bộ xử lý theo giai đoạn huấn luyện
│   └── converter.py     # Chuyển đổi định dạng (Alpaca/ShareGPT)
├── model/               # Lớp mô hình
│   ├── loader.py        # Tải mô hình + tokenizer, lượng tử hóa, LoRA
│   └── patcher.py       # Bản vá tương thích mô hình
├── train/               # Lớp huấn luyện
│   ├── sft/             # Tinh chỉnh có giám sát
│   ├── dpo/             # Tối ưu hóa ưu tiên DPO
│   ├── ppo/             # Học tăng cường PPO
│   ├── rm/              # Mô hình phần thưởng
│   ├── pt/              # Tiền huấn luyện
│   ├── kto/             # Huấn luyện KTO
│   └── mca/             # Tích hợp Megatron-Core
├── hparams/              # Lớp cấu hình tham số
│   ├── model_args.py    # Tham số mô hình
│   ├── data_args.py     # Tham số dữ liệu
│   ├── finetuning_args.py # Tham số tinh chỉnh
│   └── training_args.py # Tham số huấn luyện (kế thừa HF TrainingArguments)
├── extras/               # Gói tiện ích
│   ├── constants.py     # Hằng số/enum toàn cục
│   └── packages.py      # Kiểm tra dependency
└── webui/                # Giao diện web LLaMA Board
    ├── interface.py     # Xây dựng giao diện Gradio
    ├── runner.py        # Khởi chạy tác vụ huấn luyện
    └── components/      # Các thành phần UI
3.3 Quy trình huấn luyện (v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → Phân tích cấu hình YAML/JSON
    → get_train_args() → Tạo 4 dataclass được định kiểu:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → Định tuyến đến hàm huấn luyện cụ thể:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (tùy chọn) export_model() → Hợp nhất và xuất trọng số LoRA
3.4 Ma trận engine suy luận
Engine|Đặc điểm|Trường hợp sử dụng
HF Engine|HuggingFace gốc, khả năng tương thích tốt nhất|Phát triển, gỡ lỗi và suy luận quy mô nhỏ
vLLM Engine|Tăng tốc suy luận 270%, PagedAttention|Suy luận trực tuyến hiệu năng cao
SGLang Engine|RadixAttention, sinh có cấu trúc|Suy luận hàng loạt, sinh phức tạp
KT Engine|Dành riêng cho chuyển giao tri thức|Chưng cất mô hình
IV. Hệ thống chức năng
4.1 Các mô hình huấn luyện được hỗ trợ (8 loại × 6 phương pháp tinh chỉnh = 48 tổ hợp)
Mô hình huấn luyện|Full|Freeze|LoRA|QLoRA|OFT|QOFT
Tiền huấn luyện (PT)|✅|✅|✅|✅|✅|✅
Tinh chỉnh có giám sát (SFT)|✅|✅|✅|✅|✅|✅
Mô hình phần thưởng (RM)|✅|✅|✅|✅|✅|✅
Huấn luyện PPO|✅|✅|✅|✅|✅|✅
Huấn luyện DPO|✅|✅|✅|✅|✅|✅
Huấn luyện KTO|✅|✅|✅|✅|✅|✅
Huấn luyện ORPO|✅|✅|✅|✅|✅|✅
Huấn luyện SimPO|✅|✅|✅|✅|✅|✅
4.2 Các dòng mô hình được hỗ trợ (hơn 60 dòng, hơn 100 biến thể)
Một số mô hình tiêu biểu:
Dòng mô hình|Quy mô tham số|Điểm nổi bật
Llama 3-4|1B–402B|Mô hình mã nguồn mở hàng đầu của Meta
Qwen 2-3.6|0.5B–397B|Toàn bộ dòng Qwen của Alibaba
DeepSeek R1|1.5B–671B|Các phiên bản chưng cất của mô hình suy luận
Gemma 3|270M–27B|Mô hình nhẹ của Google
InternVL 2.5-3.5|1B–241B|Mô hình ngôn ngữ thị giác đa phương thức
MiniCPM|0.5B–9B|Tối ưu hóa cho triển khai trên thiết bị đầu cuối
GLM-4/4.5|9B–355B|Dòng ChatGLM của Zhipu
Mistral/Mixtral|7B–8x22B|Hỗn hợp chuyên gia MoE
Phi-3/4|3.8B–14B|Mô hình nhỏ hiệu năng cao của Microsoft
Qwen-VL 2-3|2B–235B|Mô hình ngôn ngữ thị giác
4.3 Hỗ trợ thuật toán nâng cao
Thuật toán|Chức năng|Phiên bản tích hợp
FlashAttention-2|Tăng tốc tính toán attention|2023-09
Unsloth|Tăng tốc huấn luyện 170% + tiết kiệm 50% VRAM|2023-12
DoRA|Phân rã trọng số LoRA|2024-02
GaLore|Tối ưu hóa hạng thấp cho gradient|2024-03
BAdam|Tối ưu hóa giảm tọa độ theo khối|2024-04
APOLLO|Trình tối ưu hóa bậc cao|2025-Q1
Liger Kernel|Tăng tốc kernel Triton|2025
Huấn luyện FP8|Hỗ trợ Transformer Engine|2025
4.4 Giao diện Web LLaMA Board
Giao diện trực quan không cần viết code, được xây dựng dựa trên Gradio
Chọn mô hình → Cấu hình tập dữ liệu → Tham số tinh chỉnh → Khởi động huấn luyện bằng một cú nhấp
Giám sát theo thời gian thực: đường cong Loss, mức sử dụng GPU, tiến độ huấn luyện
Hỗ trợ ghi nhật ký qua nhiều backend: TensorBoard, Wandb, MLflow, SwanLab
Tích hợp sẵn giao diện Chat suy luận, có thể kiểm thử ngay sau khi huấn luyện
4.5 Phương thức triển khai
# Tinh chỉnh bằng CLI (một dòng lệnh)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Web UI
llamafactory-cli webui

# Triển khai API theo phong cách OpenAI
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
V. Yêu cầu phần cứng (ước tính VRAM)
Phương pháp|Độ chính xác|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
Lượng tử hóa QLoRA 4-bit cho phép tinh chỉnh mô hình 14B tham số trên một GPU RTX 3060 (12 GB VRAM), và tinh chỉnh mô hình 30B tham số trên một GPU RTX 4090 (24 GB VRAM).
VI. Tiến hóa phiên bản
Phiên bản|Ngày|Thay đổi chính
v0.1.0|2023-03|Phát hành ban đầu, hỗ trợ tinh chỉnh LLaMA
Các phiên bản đầu|2023|SFT + LoRA/QLoRA, DPO, Web UI, FlashAttention-2, Unsloth
Các phiên bản đầu|2024 Q1-Q3|DoRA, GaLore, BAdam, FSDP+QLoRA, vLLM, LLaVA đa phương thức, công bố bài báo
v0.9.1|2025 Q1|Llama 3.2 Vision, LLaVA-NeXT, Pixtral, Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o, SwanLab, trình tối ưu hóa APOLLO
v0.9.3|2025 Q2|Llama 4, Gemma 3, Qwen3, InternVL3, Qwen2.5-Omni
v0.9.4|2025-12|🔄 Kho mã được đổi tên thành LlamaFactory, ngừng hỗ trợ Python 3.9-3.10
v0.9.5|2026-05-30|Tương thích với Qwen3.5/3.6, Gemma 4, Transformers v5
v1.x (thử nghiệm)|2026|Kiến trúc mới trainers → core → accelerator, viết lại theo hướng mô-đun
Diễn giải các cột mốc chính
Công bố bài báo tại ACL 2024 —— Sự bảo chứng học thuật giúp số lượng Stars tăng vọt từ 10 nghìn lên hơn 30 nghìn
Nửa cuối năm 2024 —— Hỗ trợ đa phương thức (LLaVA/Video/Audio) mở ra thị trường mới
Năm 2025 —— Duy trì nhịp phát hành hàng tháng, hỗ trợ Qwen3/DeepSeek/Llama4, trở thành lựa chọn hàng đầu của cộng đồng mã nguồn mở Trung Quốc
Đổi tên kho mã —— LLaMA-Factory → LlamaFactory, giảm sự phụ thuộc vào thương hiệu Meta
Kiến trúc thử nghiệm v1 —— Cho thấy một đợt tái cấu trúc lớn sắp diễn ra
VII. Hệ sinh thái cộng đồng
7.1 Ma trận hệ sinh thái dự án
Dự án|Mô tả|Stars
LlamaFactory|Framework tinh chỉnh cốt lõi|72K+
EasyR1|Học tăng cường cho VLM (GRPO/DAPO/Reinforce++)|Mới nổi
FastEdit|Chỉnh sửa sự thật trong mô hình hiệu quả|Đã lưu trữ
llamafactory-community|Trung tâm giao lưu cộng đồng|-
Easy Dataset|Công cụ tạo dữ liệu tổng hợp|Bên thứ ba
DataFlow|Đường ống xử lý dữ liệu|Bên thứ ba
7.2 Mức độ quan tâm của cộng đồng
Cộng đồng AI Trung Quốc: CSDN, Zhihu, Blog Garden có hàng trăm bài hướng dẫn và kinh nghiệm thực tiễn
Doanh nghiệp áp dụng: Được Alibaba Cloud, Huawei Ascend, Amazon AWS và NVIDIA chính thức khuyến nghị
Ứng dụng giáo dục: Được Đại học Phúc Đán và nhiều trường đại học sử dụng làm công cụ giảng dạy trong các khóa học về mô hình lớn
Thích ứng với tiếng Trung: Hỗ trợ gốc ModelScope (cộng đồng ModelScope), tải xuống qua bản sao OpenMind Hub
LLaMA Factory Online: Từng cung cấp dịch vụ nền tảng trực tuyến, ngừng hoạt động vào 2026-06-20
7.3 So sánh với đối thủ
Framework|Stars|Đặc điểm cốt lõi|Hỗ trợ mô hình|Tính dễ sử dụng
LlamaFactory|72K|GUI/CLI một điểm đến, được bảo chứng bởi bài báo ACL|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|Bộ công cụ chính thức của HF, tích hợp sâu với hệ sinh thái|Tất cả mô hình HF|⭐⭐⭐
Axolotl|8K|Điều khiển bằng YAML, tùy chỉnh cho người dùng nâng cao|Các mô hình phổ biến|⭐⭐⭐
Unsloth|20K+|Tối ưu hóa hiệu năng cao (tăng tốc 2-5x)|LLaMA/Mistral và các mô hình khác|⭐⭐⭐⭐
Firefly|5K|Tối ưu hóa mô hình lớn tiếng Trung|Chủ yếu là mô hình tiếng Trung|⭐⭐⭐
LLaMA-Adapter|6K|Định hướng nghiên cứu học thuật|Dòng LLaMA|⭐⭐
Ưu thế cốt lõi của LlamaFactory:
Framework duy nhất đồng thời sở hữu bài báo ACL + 70 nghìn Stars + các trường hợp triển khai thương mại + GUI không cần code
Phạm vi mô hình rộng nhất (từ GPT-2 đến Llama 4, từ văn bản thuần túy đến đa phương thức)
Hệ sinh thái cộng đồng Trung Quốc mạnh nhất (bản sao HuggingFace + tích hợp ModelScope)
VIII. Phân tích SWOT
8.1 Điểm mạnh (Strengths)
Điểm mạnh|Chi tiết
🔬 Uy tín học thuật|Bài báo ACL 2024, thu hút hơn 500+ lượt trích dẫn học thuật
🎯 Ngưỡng sử dụng cực thấp|Tinh chỉnh bằng một dòng lệnh, thao tác không cần code qua Web UI
🌐 Phạm vi mô hình rộng nhất|100+ mô hình, 60+ dòng, văn bản/thị giác/video/audio
🇨🇳 Hệ sinh thái cộng đồng Trung Quốc|Bản sao ModelScope/OpenMind, số lượng lớn hướng dẫn tiếng Trung
🔧 Bộ công cụ cấp công nghiệp|Đầy đủ triển khai Docker/phân tán/API
💾 Tối ưu hóa VRAM tối đa|Chạy 70B trên GPU phổ thông với QLoRA 4-bit
8.2 Điểm yếu (Weaknesses)
Điểm yếu|Chi tiết
👤 Phụ thuộc nghiêm trọng vào một cá nhân|hiyouga chiếm 72% số commit (2,188/3,042), Bus Factor = 1
📚 Tài liệu phân tán|README quá dài (68KB), thông tin bị phân mảnh giữa Wiki/ReadTheDocs/bài viết cộng đồng
🐛 Tồn đọng Issue|Chỉ có 57 Open Issues, nhưng lượng thảo luận trong khu vực Issue rất lớn
🏗️ Phân tách hai nhánh v0/v1|Chi phí duy trì hai kiến trúc cao, v1 chưa ổn định trong thời gian dài
📦 Phụ thuộc gói phức tạp|Ma trận phiên bản CUDA/PyTorch/FlashAttn rất dễ phát sinh lỗi
🔒 Tính chất dự án học thuật|Thiếu đội ngũ vận hành toàn thời gian, đặt ra nghi vấn về khả năng duy trì lâu dài
8.3 Cơ hội (Opportunities)
Cơ hội|Chi tiết
🚀 Kịch bản tinh chỉnh Agent|Nhu cầu tinh chỉnh Function Calling / Tool Use bùng nổ
🎥 Mở rộng đa phương thức|Thị trường tiềm năng cho tinh chỉnh mô hình Video/Audio/3D
☁️ SaaS cloud-native|Dù LLaMA Factory Online đã ngừng hoạt động, nhu cầu lưu trữ và quản lý cấp doanh nghiệp vẫn còn
🏢 Thị trường đào tạo doanh nghiệp|Các khóa đào tạo tinh chỉnh mô hình lớn và hệ thống chứng nhận
🔗 Tích hợp MCP|Backend tinh chỉnh phục vụ hạ tầng AI Agent
8.4 Mối đe dọa (Threats)
Mối đe dọa|Chi tiết
🏢 Framework do các công ty lớn tự phát triển|Alibaba PAI và Huawei ModelArts cung cấp các giải pháp tích hợp
🔄 Cạnh tranh từ HF chính thức|Hệ sinh thái HuggingFace TRL/peft ngày càng hoàn thiện
📉 Nhu cầu tinh chỉnh suy giảm|Prompt Engineering + RAG thay thế một phần các kịch bản tinh chỉnh
👨🎓 Nhà sáng lập tốt nghiệp|Sau khi tiến sĩ Zheng Yaowei tốt nghiệp, mức độ duy trì dự án có thể giảm
IX. Đánh giá rủi ro
Danh mục rủi ro|Mức độ rủi ro|Mô tả
Bus Factor|🔴 Rủi ro cao|Một nhà phát triển cốt lõi chiếm 72% số lượt commit; nếu người này rời đi, nguy cơ dự án đình trệ là cực kỳ cao
Nợ kỹ thuật|🟡 Rủi ro trung bình|Hai kiến trúc v0/v1, README 68KB, tài liệu phân mảnh
Chuỗi phụ thuộc|🟡 Rủi ro trung bình|Chi phí duy trì ma trận phiên bản CUDA/PyTorch/FlashAttn cao
Thương mại hóa|🟢 Rủi ro thấp|Giấy phép Apache-2.0, không có hạn chế thương mại
Sức khỏe cộng đồng|🟢 Khỏe mạnh|72 nghìn Stars, cộng đồng toàn cầu sôi động, được doanh nghiệp sử dụng rộng rãi
10. Điểm nổi bật và đổi mới kỹ thuật
10.1 Kiến trúc “đường cao tốc tiêu chuẩn hóa”
Trong quá trình tinh chỉnh truyền thống, mỗi mô hình cần được điều chỉnh riêng. LLaMA Factory sử dụng cơ chế đăng ký template kết hợp kỹ thuật monkey‑patch, giúp giảm đáng kể chi phí thích ứng.
# Chỉ cần 3 bước để thêm mô hình mới:
# 1. Đăng ký template Prompt trong từ điển TEMPLATES của template.py
# 2. Thêm bản vá tương thích mô hình trong patcher.py (nếu cần)
# 3. Thêm hỗ trợ đa phương thức trong mm_plugin.py (nếu cần)
10.2 Hệ thống cấu hình tham số bốn lớp
Tệp cấu hình YAML/JSON
  → parser.py phân tích
    → ModelArguments (lựa chọn mô hình, lượng tử hóa)
    → DataArguments (tập dữ liệu, template, tiền xử lý)
    → FinetuningArguments (LoRA rank/target, phương pháp huấn luyện)
    → TrainingArguments (kế thừa HF, phân tán/log/checkpoint)
10.3 Chuẩn hóa đường ống dữ liệu
Công cụ này hỗ trợ hai định dạng dữ liệu phổ biến là Alpaca và ShareGPT, có thể tự động chuyển đổi hơn 50 tập dữ liệu dựng sẵn, đồng thời tương thích với các định dạng tệp JSON, JSONL, CSV, Parquet, Arrow và các định dạng khác.
10.4 Hỗ trợ lượng tử hóa tăng dần
Hỗ trợ sáu mức độ chính xác, từ độ chính xác đầy đủ 16 bit đến QLoRA 2 bit, có thể sử dụng trên nhiều môi trường phần cứng khác nhau, từ cụm máy chủ A100 đến máy tính xách tay thông thường.
11. Ma trận so sánh đối thủ
Tiêu chí|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
Hỗ trợ mô hình|100+ dòng|Tất cả HF|LLaMA/Qwen/Mistral|Các dòng phổ biến
GUI|✅ LLaMA Board|❌|❌|❌
Không cần code|✅ CLI + YAML|❌ Cần lập trình|❌ Cần lập trình|Chỉ YAML
Phương thức huấn luyện|8 loại|4 loại (SFT/DPO/PPO/GRPO)|3 loại|5 loại
Mức độ lượng tử hóa|2-16bit|4-16bit|4-16bit|4-16bit
Đa phương thức|✅ Hình ảnh/video/âm thanh|❌|❌|❌
Hệ sinh thái tiếng Trung|✅ ModelScope + ModelBest|⚠️ Cần vượt tường lửa|⚠️ Cần vượt tường lửa|❌
Bài báo học thuật|ACL 2024|-|-|-
Công cụ suy luận|vLLM/SGLang/HF|Chỉ HF|Chỉ HF|vLLM/HF
Độ dốc học tập|Rất thấp|Trung bình|Thấp|Trung bình-cao
12. Điểm chính khi triển khai thực tế
12.1 Bắt đầu nhanh (3 bước)
# Bước 1: Cài đặt
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# Bước 2: Khởi động Web UI
llamafactory-cli webui

# Bước 3: Mở localhost:7860 trong trình duyệt, chọn mô hình → tập dữ liệu → huấn luyện!
12.2 Khuyến nghị cho môi trường production
# Triển khai Docker (khuyến nghị)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# Triển khai API (tương thích OpenAI)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Lưu ý dành cho người dùng Windows
Cần cài thủ công phiên bản PyTorch GPU:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA yêu cầu cài đặt bản bitsandbytes biên dịch sẵn dành riêng cho Windows
FlashAttention-2 cần được biên dịch thủ công trên Windows
Thiết lập
dataloader_num_workers: 0để tránh lỗi tuần tự hóa
13. Triển vọng tương lai
Ổn định hóa kiến trúc v1: Nhánh thử nghiệm dự kiến trở thành kiến trúc chính vào năm 2026-2027, với mức độ mô-đun hóa cao hơn
Đào sâu tinh chỉnh Agent: Tinh chỉnh Tool Use / Function Calling sẽ trở thành tính năng tiêu chuẩn
Tinh chỉnh mô hình suy luận (Reasoning): Chưng cất DeepSeek-R1 + tinh chỉnh GRPO (dự án EasyR1)
Quản lý cloud-native: Sau khi LLaMA Factory Online ngừng hoạt động, các giải pháp lưu trữ của bên thứ ba có thể xuất hiện
Thống nhất huấn luyện đa phương thức: Tinh chỉnh văn bản/hình ảnh/video/âm thanh trong cùng một framework
14. Chấm điểm và tổng kết
Tiêu chí|Điểm số|Nhận xét
Kiến trúc kỹ thuật|9.5/10|Thiết kế mô-đun, tiến hóa hai kiến trúc, ma trận engine phong phú
Tính hoàn chỉnh chức năng|10/10|8 phương thức huấn luyện × 6 phương pháp tinh chỉnh × 100+ mô hình
Tính dễ sử dụng|10/10|Tinh chỉnh bằng một dòng lệnh + Web UI không cần code, tốt nhất ngành
Chất lượng tài liệu|7.5/10|README chi tiết nhưng quá dài, phân mảnh nghiêm trọng
Mức độ sôi động của cộng đồng|9.5/10|72K Stars, sức nóng hiện tượng trong cộng đồng Trung Quốc
Mức độ sẵn sàng production|9.0/10|Docker/API/phân tán hoàn chỉnh, được doanh nghiệp kiểm chứng rộng rãi
Khả năng phát triển bền vững|6.5/10|Bus Factor=1, mang tính chất dự án học thuật, triển vọng dài hạn còn bỏ ngỏ
Tính đổi mới|8.5/10|Bài báo ACL, cơ chế đăng ký template, hệ thống tham số bốn lớp
Điểm tổng thể: 9.
Tóm tắt trong một câu
LLaMA Factory là một framework mã nguồn mở để tinh chỉnh mô hình ngôn ngữ lớn, được triển khai dựa trên bài báo ACL 2024 và nhận được sự công nhận của cộng đồng với khoảng 72 000 Stars trên GitHub. Framework tuân theo triết lý thiết kế “tách biệt thuật toán‑mô hình‑dữ liệu”, cung cấp giao diện dòng lệnh (CLI) và Web UI không cần code, hỗ trợ tinh chỉnh hơn 100 mô hình, qua đó giảm đáng kể rào cản kỹ thuật trong việc tinh chỉnh mô hình ngôn ngữ lớn. Framework có thể được sử dụng làm hạ tầng nền tảng để đưa các ứng dụng mô hình ngôn ngữ lớn vào thực tế.