

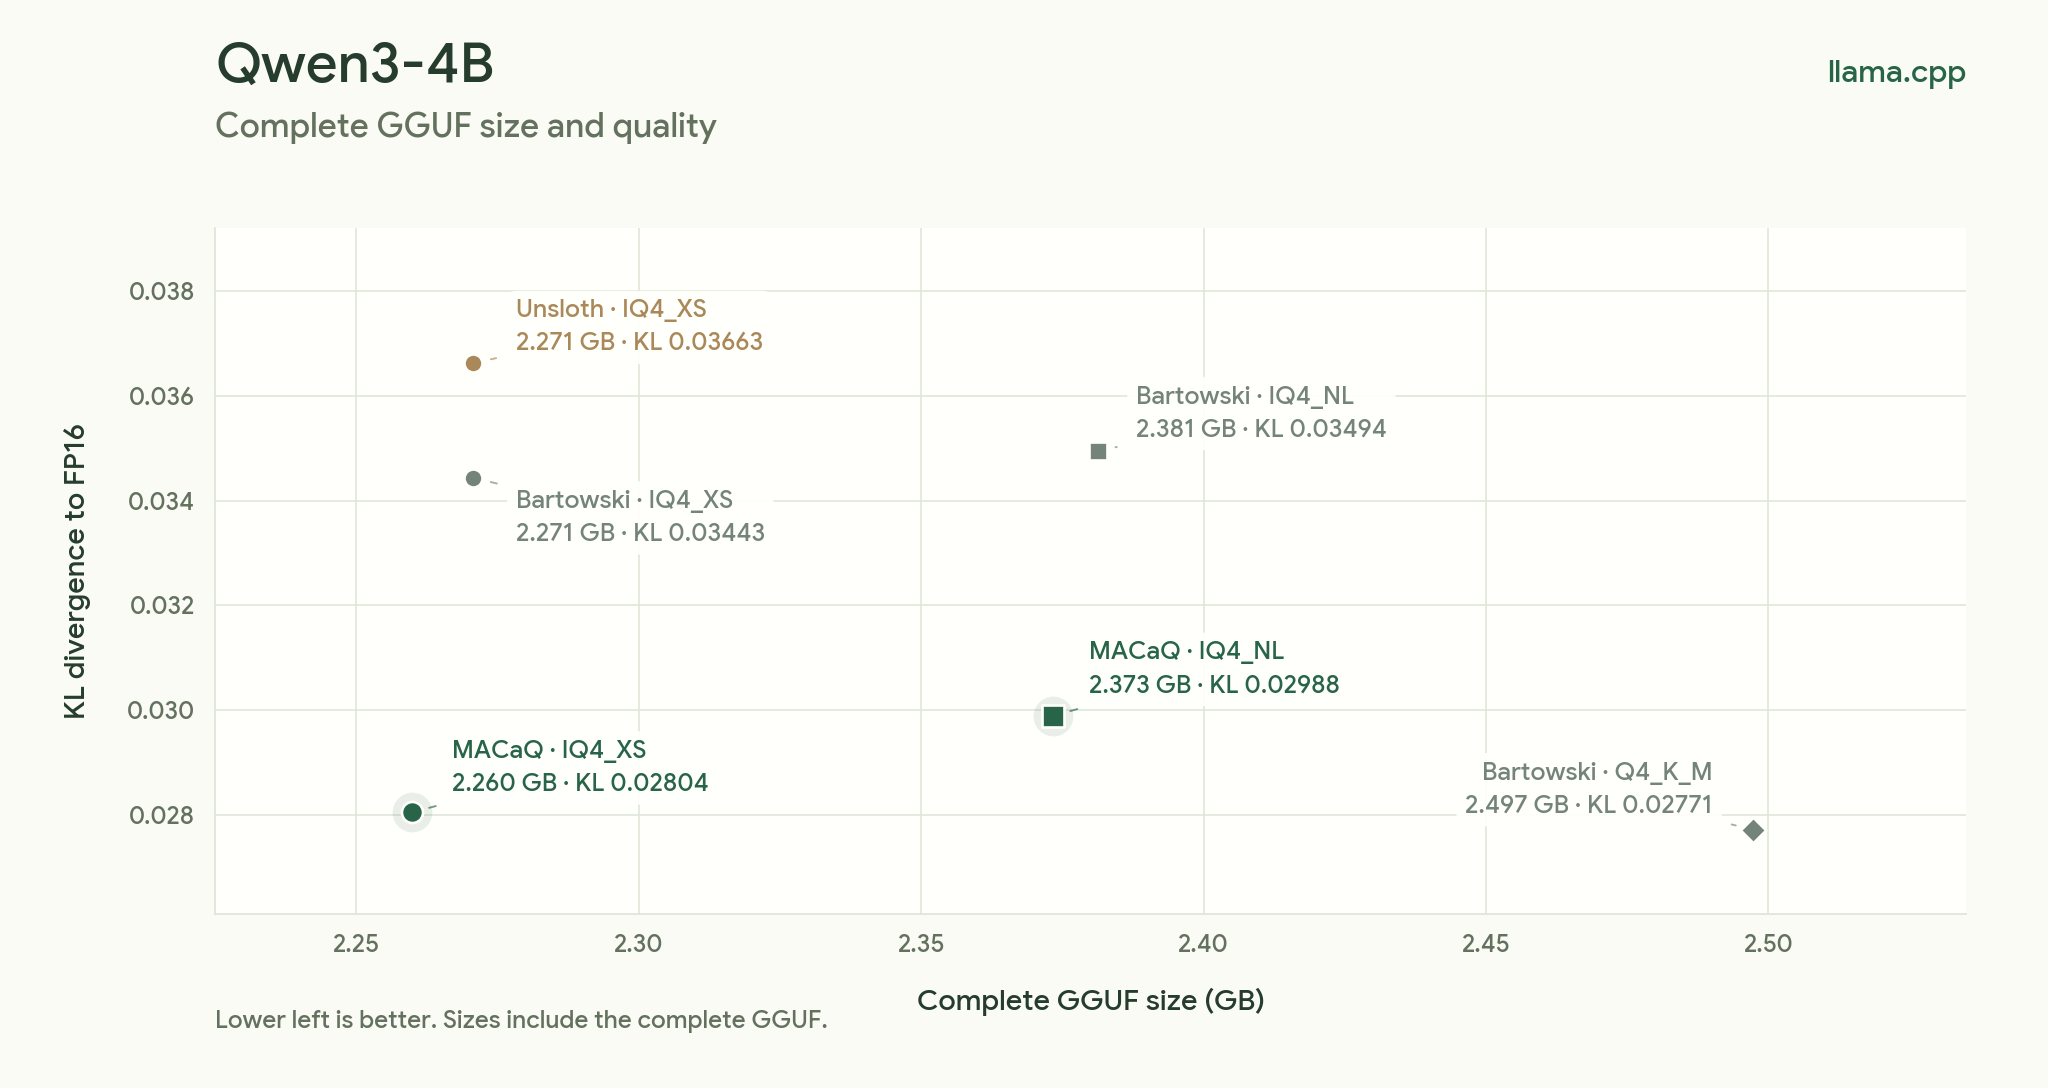
MACaQ là một dự án lượng tử hóa có hiệu chuẩn, không phụ thuộc mô hình, nhằm giảm yêu cầu về bộ nhớ và năng lực tính toán của các mô hình AI hiện đại. Dự án hỗ trợ quy trình làm việc với văn bản, hình ảnh, video và âm thanh thông qua llama.cpp, vLLM, Diffusers và PyTorch.
Dự án tập trung vào trọng số và giá trị kích hoạt có độ chính xác thấp được hiệu chuẩn, đồng thời vẫn duy trì khả năng tương thích thực tế khi suy luận. Theo README, MACaQ có thể lượng tử hóa một mô hình 122 tỷ tham số trong 64 phút bằng 32.5 GB bộ nhớ thiết bị. Dự án cũng ghi nhận perplexity thấp hơn MR-GPTQ và DuQuant++ trong một số phép so sánh, hoặc perplexity tương đương Llama-3-8B với thời gian lượng tử hóa ngắn hơn đáng kể.
Chọn backend MACaQ phù hợp
Bắt đầu bằng cách chọn backend phù hợp với mô hình và mục tiêu triển khai của bạn. Sử dụng một môi trường riêng cho từng backend và Python 3.12.
- Diffusers: lượng tử hóa các mô hình tạo hình ảnh, video và âm thanh thành các checkpoint safetensors W4A4.
- llama.cpp: lượng tử hóa các mô hình văn bản thành tệp GGUF 2, 3 hoặc 4 bit và chạy cục bộ, kể cả trên CPU.
- vLLM: lượng tử hóa các mô hình văn bản để tạo nội dung hoặc cung cấp qua HTTP bằng định dạng W4A4 hoặc chỉ lượng tử hóa trọng số.
- PyTorch: lượng tử hóa các mô hình tạo giọng nói thành checkpoint W4A4 và tạo âm thanh WAV.
Kho lưu trữ chứa hướng dẫn cài đặt, hiệu chuẩn, lượng tử hóa và tạo nội dung dành riêng cho từng backend. Hãy mở hướng dẫn tương ứng với backend bạn chọn trước khi bắt đầu:
- Cài đặt Diffusers và quy trình làm việc
- Cài đặt llama.cpp và quy trình làm việc
- Cài đặt và cung cấp dịch vụ bằng vLLM
- Quy trình làm việc với giọng nói bằng PyTorch
Chuẩn bị môi trường
Sử dụng Python 3.12 và tạo một môi trường biệt lập cho backend bạn định dùng. Việc tách riêng các môi trường giúp tránh xung đột phụ thuộc giữa llama.cpp, vLLM, Diffusers và PyTorch.
Sao chép kho lưu trữ MACaQ và truy cập vào thư mục của kho.
Tạo môi trường ảo Python 3.12 cho backend đã chọn.
Làm theo README của backend đó để cài đặt các phụ thuộc và mọi runtime bắt buộc.
Chuẩn bị mô hình gốc, dữ liệu hiệu chuẩn và thư mục đầu ra được chỉ định trong hướng dẫn của backend.
Các lệnh cài đặt chính xác phụ thuộc vào backend và họ mô hình, vì vậy hãy sử dụng README được liên kết thay vì áp dụng một lệnh cài đặt chung cho mọi quy trình.
Lượng tử hóa mô hình tạo sinh với Diffusers
Backend Diffusers xử lý các transformer khuếch tán và lưu checkpoint safetensors đã lượng tử hóa. Backend này hỗ trợ tạo hình ảnh, video, hình ảnh thành video và âm thanh.
Kho lưu trữ cung cấp quy trình làm việc cho các mô hình như black-forest-labs/FLUX.2-klein-4B, Wan-AI/Wan2.2-TI2V-5B-Diffusers và ylacombe/stable-audio-1.0. Đối với các mô hình hình ảnh thành video, quá trình hiệu chuẩn có thể sử dụng hình ảnh điều kiện để quy trình lượng tử hóa phản ánh mẫu đầu vào dự kiến.
Mở hướng dẫn Diffusers và chọn quy trình làm việc với hình ảnh, video hoặc âm thanh.
Cài đặt các yêu cầu của backend trong một môi trường Python 3.12 riêng.
Tải xuống hoặc xác định mô hình nguồn và chuẩn bị các đầu vào hiệu chuẩn cần thiết theo công thức đã chọn.
Chạy lệnh lượng tử hóa được hướng dẫn để lưu checkpoint safetensors W4A4.
Sử dụng lệnh tạo tương ứng để tạo kết quả hình ảnh, video hoặc âm thanh.
Lượng tử hóa mô hình văn bản với llama.cpp
Backend llama.cpp tạo ra các tệp GGUF nhỏ gọn để sinh văn bản. Backend này hỗ trợ định dạng GGUF 2 bit, 3 bit và 4 bit, đồng thời bao gồm runtime để sinh văn bản từ mô hình kết quả.
Kho lưu trữ hướng dẫn sử dụng các mô hình dense như Qwen/Qwen3-4B, các mô hình lai như Qwen/Qwen3.8-27B và các mô hình mixture-of-experts như Qwen/Qwen3-30B-A3B và Qwen/Qwen3-Coder-30B-A3B-Instruct. Kho cũng bao gồm các công thức cho Qwen3.6-35B-A3B và Qwen3.8-Flash-Next.
Quy trình lượng tử hóa tiêu chuẩn
Mở hướng dẫn llama.cpp và chọn công thức phù hợp với kiến trúc mô hình của bạn.
Cài đặt backend llama.cpp cùng các phụ thuộc trong một môi trường Python 3.12 riêng.
Chuẩn bị mô hình Hugging Face gốc và văn bản hiệu chuẩn được mô tả trong công thức đã chọn.
Chạy quy trình lượng tử hóa MACaQ được hướng dẫn và lưu đầu ra GGUF.
Sử dụng runtime đi kèm hoặc một bản cài đặt llama.cpp tương thích để sinh văn bản.
Để biết chi tiết theo từng mô hình, hãy xem phần dense, hybrid, mixture-of-experts hoặc Flash-Next trong README của backend. Các công thức này учиты đến sự khác biệt giữa các kiến trúc mô hình.
Chạy mô hình GGUF
Sau khi tạo tệp GGUF, hãy chạy tệp bằng ứng dụng dòng lệnh llama.cpp:
llama cli -m models/model-macaq-r.ggufBạn cũng có thể cung cấp mô hình qua llama.cpp:
llama serve -m models/model-macaq-r.ggufTinh chỉnh các tệp GGUF hiện có bằng MACaQ-R
MACaQ-R tinh chỉnh các mã trọng số trong một tệp GGUF đã lượng tử hóa, đồng thời giữ nguyên các định dạng gốc và hệ số tỷ lệ của block. Tệp kết quả vẫn tương thích với bản cài đặt llama.cpp tiêu chuẩn.
Điều này hữu ích khi bạn đã có một mô hình được lượng tử hóa và muốn cải thiện chất lượng hoặc điều chỉnh mô hình cho một khối lượng công việc mà không thay đổi định dạng GGUF. README cung cấp mô hình Qwen3.6-35B-A3B MACaQ-R trên Hugging Face và cho biết độ phân kỳ KL thấp hơn tệp Unsloth UD-Q4_K_XL được so sánh ở cùng kích thước được liệt kê.
Để tinh chỉnh một GGUF MoE đã lượng tử hóa, hãy cung cấp mô hình đã lượng tử hóa, mô hình Hugging Face gốc tương ứng, tệp teacher FP16, văn bản hiệu chuẩn, đường dẫn đầu ra và thư mục làm việc:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
Sau khi hoàn tất tinh chỉnh, hãy tải đầu ra bằng llama.cpp tiêu chuẩn:
llama cli -m models/model-macaq-r.ggufĐể xem quy trình MACaQ đầy đủ, bao gồm các phép biến đổi activation, hãy sử dụng hướng dẫn bundled-runtime.
Lượng tử hóa và cung cấp mô hình bằng vLLM
Backend vLLM tạo các checkpoint mô hình văn bản nhỏ gọn để sinh văn bản hoặc cung cấp qua HTTP. W4A4 là chế độ suy luận mặc định; backend cũng hỗ trợ lượng tử hóa chỉ trọng số.
Mở hướng dẫn vLLM và chọn quy trình cho mô hình văn bản hybrid hoặc mô hình văn bản mixture-of-experts.
Cài đặt backend vLLM trong môi trường Python 3.12 riêng.
Chuẩn bị mô hình nguồn và dữ liệu hiệu chuẩn cần thiết cho công thức đã chọn.
Chạy lệnh lượng tử hóa được ghi trong tài liệu để tạo checkpoint nhỏ gọn.
Tải checkpoint để sinh văn bản cục bộ hoặc khởi chạy máy chủ HTTP được ghi trong tài liệu.
README báo cáo kết quả so sánh Qwen3.8-27B, trong đó MACaQ W4A4 đạt perplexity 2.8994 so với 2.8463 của BF16, đồng thời có thời gian đo prefill và decode nhanh hơn trong thiết lập kiểm thử được liệt kê.
Lượng tử hóa bộ sinh giọng nói bằng PyTorch
Backend PyTorch hướng đến việc sinh giọng nói và lưu các checkpoint W4A4. Sau khi lưu checkpoint, bạn có thể tải checkpoint mà không cần lặp lại quá trình hiệu chuẩn.
Các quy trình được ghi trong tài liệu bao gồm Qwen3-TTS và Chatterbox Turbo.
Mở hướng dẫn PyTorch và chọn mô hình giọng nói.
Cài đặt các dependency PyTorch cần thiết trong một môi trường Python 3.12 riêng.
Chạy hiệu chuẩn và lượng tử hóa theo hướng dẫn dành riêng cho mô hình.
Lưu checkpoint W4A4.
Tải checkpoint đã lưu và sinh âm thanh WAV mà không cần hiệu chuẩn lại.
Sử dụng MACaQ với phần cứng Ascend
Các kernel nhân ma trận dense và grouped W4A4 của MACaQ có sẵn thông qua các pull request liên quan đến CANN. README trỏ đến các kernel PTO-ISA trong pull request 12568 của ops-nn và các kernel TileLang với backend CCE trong pull request 44 của ops-tilelang.
Hãy làm theo hướng dẫn build trong các dự án đó để sử dụng các phiên bản CANN, PyTorch và torch_npu tương thích. Việc thực thi toàn bộ mô hình yêu cầu tích hợp với runtime suy luận Ascend.
Mẹo thực tế để có quy trình tốt hơn
- Chọn backend phù hợp với mục tiêu triển khai. Chọn GGUF và llama.cpp để suy luận văn bản cục bộ, dễ chuyển đổi; vLLM để cung cấp văn bản; Diffusers để sinh nội dung đa phương thức; và PyTorch cho các mô hình giọng nói.
- Sử dụng công thức riêng cho từng mô hình. Các mô hình dense, hybrid và mixture-of-experts có thể yêu cầu các bước chuẩn bị và lượng tử hóa khác nhau.
- Đảm bảo dữ liệu hiệu chuẩn phù hợp với cách sử dụng. Ví dụ, quy trình image-to-video của Diffusers sử dụng hình ảnh điều kiện trong quá trình hiệu chuẩn.
- Tách riêng các môi trường. README nêu rõ nên sử dụng một môi trường riêng cho mỗi backend và Python 3.12.
- Đánh giá chất lượng, không chỉ kích thước tệp. Dự án sử dụng các so sánh perplexity và độ phân kỳ KL để đánh giá mô hình đã lượng tử hóa với FP16 hoặc các phương pháp lượng tử hóa khác.
- Sử dụng MACaQ-R khi bạn đã có GGUF. Công cụ này có thể tinh chỉnh tệp đã lượng tử hóa hiện có mà vẫn giữ khả năng tương thích với llama.cpp tiêu chuẩn.
Kết luận
MACaQ cung cấp một phương pháp lượng tử hóa cho nhiều tác vụ AI, từ các mô hình văn bản GGUF đến các mô hình hình ảnh, video và âm thanh Diffusers, các checkpoint phục vụ vLLM và các trình tạo giọng nói PyTorch. Hãy bắt đầu với README dành riêng cho backend, sử dụng Python 3.12 trong một môi trường cô lập, làm theo công thức mô hình để hiệu chuẩn và xác thực checkpoint thu được bằng runtime dự kiến sử dụng.
Để xem tài liệu nghiên cứu hoặc tài liệu kỹ thuật, hãy tham khảo