

DeepSelect là gì?
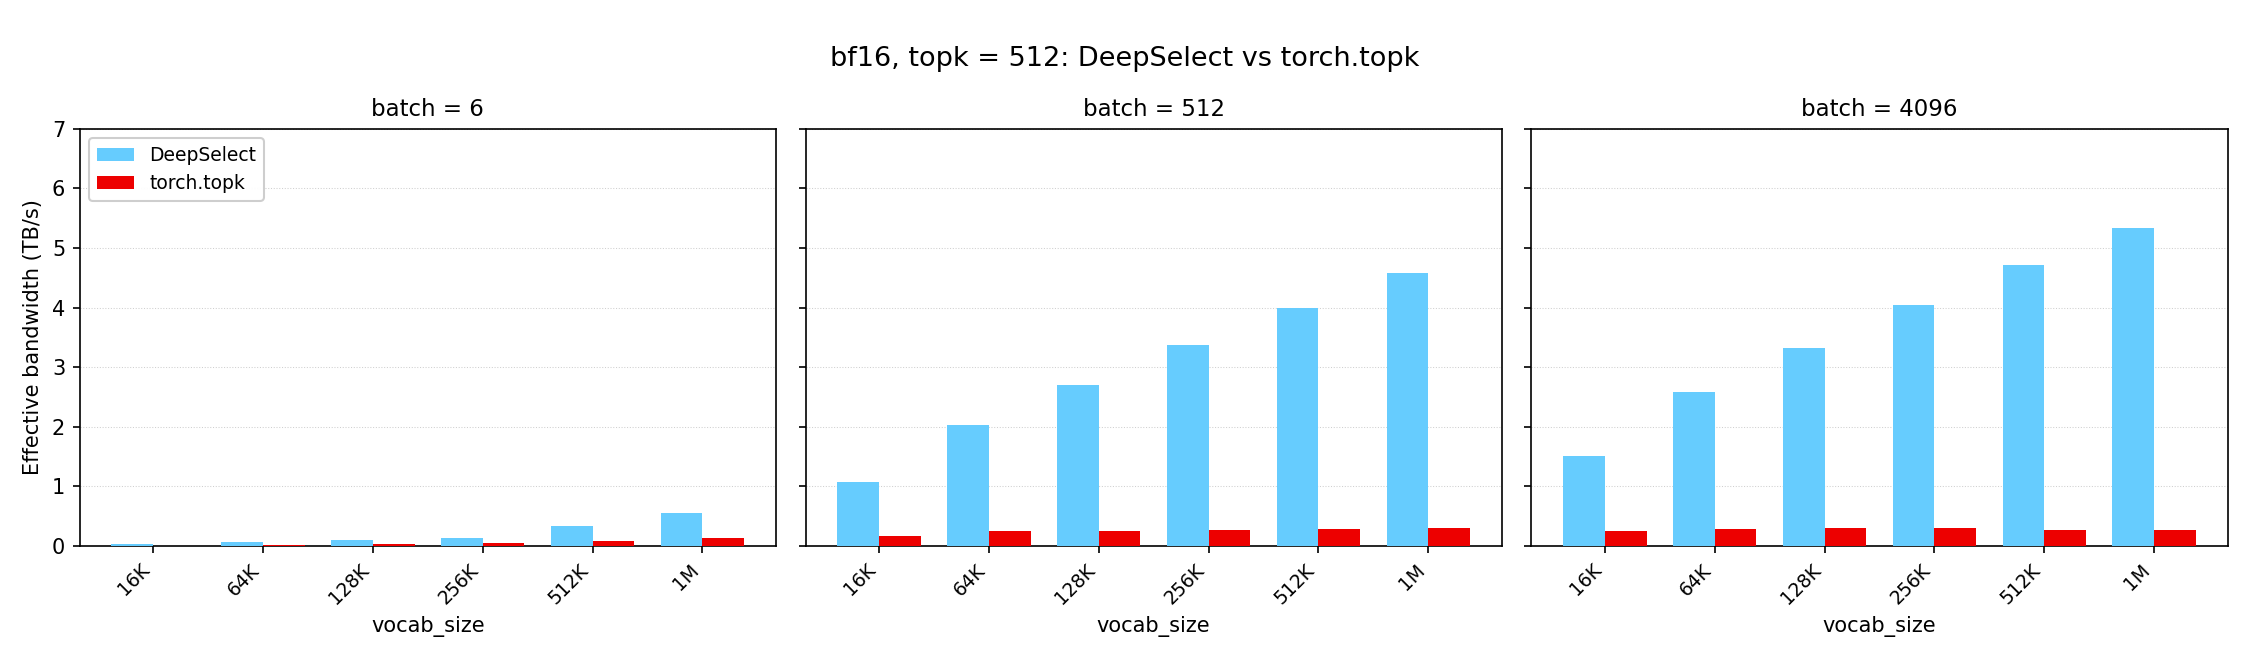
DeepSelect là một triển khai hiệu năng cao của kernel TopK được sử dụng trong DeepSeek Sparse Attention và quá trình lấy mẫu. Theo README của dự án, thư viện này có thể nhanh hơn 2–20 lần so với torch.topk mặc định đối với các workload được hỗ trợ.
Thay vì cố gắng tối ưu mọi cấu hình TopK có thể, DeepSelect tập trung vào hai trường hợp: workload Lightning Indexer sử dụng đầu vào torch.bfloat16 và workload lấy mẫu sử dụng đầu vào torch.float32.
Workload được hỗ trợ
Trường hợp Lightning Indexer
- Kiểu đầu vào:
torch.bfloat16 - Kích thước batch: từ 1 trở lên, với tối ưu hóa cho cả batch nhỏ và lớn
- Kích thước vocabulary: từ 1 trở lên, với tối ưu hóa cho cả vocabulary nhỏ và lớn
- Kích thước TopK: nhỏ và không lớn hơn
4096
Để đạt hiệu năng tốt hơn, hãy để sorted_index tắt trừ khi kết quả cần được sắp xếp. Nếu không cần các giá trị, hãy đặt return_value=False để bỏ qua việc xuất chúng.
Trường hợp lấy mẫu
- Kiểu đầu vào:
torch.float32 - Kích thước batch: từ 1 trở lên
- Kích thước vocabulary: khoảng 128K
- Kích thước TopK: nhỏ và không lớn hơn
4096
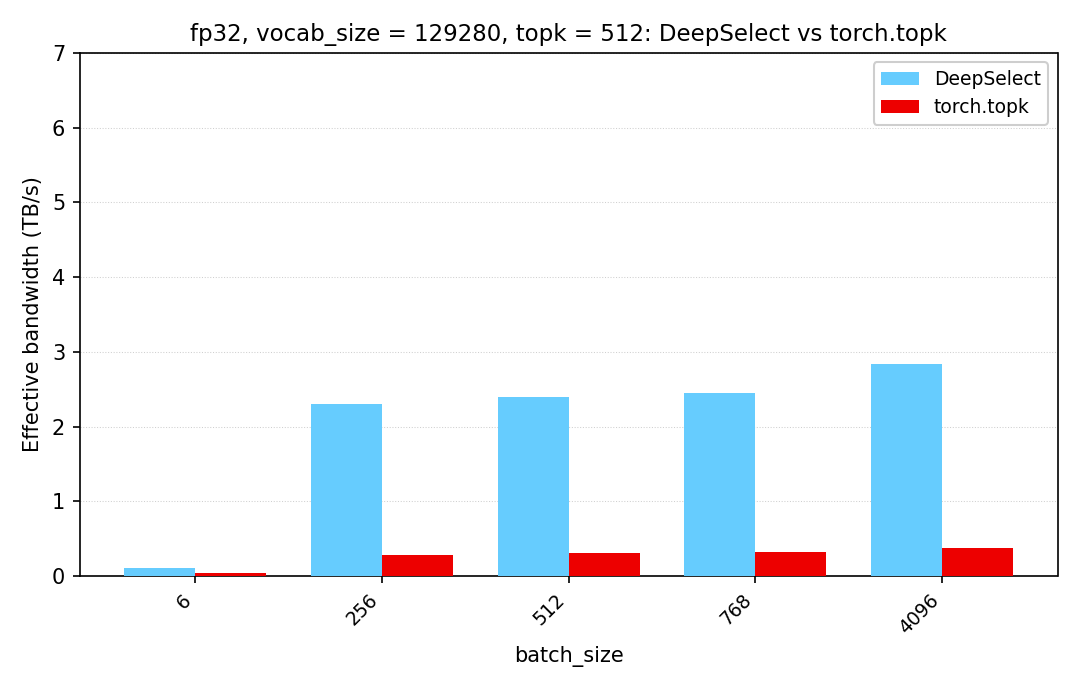
Kho lưu trữ đo hiệu năng bằng băng thông bộ nhớ hiệu dụng thay vì thông lượng dấu phẩy động, vì TopK không thực hiện phép tính dấu phẩy động. Benchmark của thư viện báo cáo hiệu năng tương đối so với torch.topk trên cùng một đầu vào.
Tính năng chính
- Các kernel TopK chuyên biệt cho workload DeepSeek Sparse Attention và lấy mẫu
- Hỗ trợ đầu vào
torch.bfloat16vàtorch.float32trong các trường hợp mục tiêu tương ứng - Cấu hình kiểu đầu ra chỉ mục
torch.int32hoặctorch.int64 - Xuất giá trị tùy chọn để giảm overhead khi chỉ cần các chỉ mục
- Các hàng có độ dài thay đổi thông qua giới hạn trên độc quyền cho từng hàng
- Buffer đầu ra chỉ mục do người dùng quản lý
- Tích hợp kiểm tra NaN
Cài đặt
Sao chép kho lưu trữ, khởi tạo các submodule và cài đặt package từ thư mục dự án:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
Các ví dụ sử dụng tensor CUDA, vì vậy hãy tạo đầu vào trên device="cuda".
Sử dụng TopK cơ bản
Nhập PyTorch và DeepSelect, tạo tensor đầu vào hai chiều rồi gọi deep_select.topk:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
Đầu vào phải có dạng (batch_size, vocab_size). Chiều cuối phải liên tục và stride của hàng phải là bội số của deep_select.get_stride_requirement()[0] byte.
Các giá trị trả về có cùng kiểu dữ liệu với x. Các chỉ mục sử dụng kiểu được chọn thông qua indices_type, có thể là torch.int32 hoặc torch.int64. Khi sorted_index=True, các chỉ mục trả về của mỗi hàng được sắp xếp theo thứ tự tăng dần.
Chỉ trả về các chỉ mục
Nếu mã downstream không cần các giá trị được chọn, hãy tắt việc xuất giá trị:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README cho biết việc bỏ qua đầu ra giá trị giúp nhanh hơn khoảng 10%. Tránh yêu cầu đầu ra được sắp xếp nếu không cần thứ tự, vì thao tác sắp xếp làm tăng overhead.
Xử lý căn chỉnh stride
DeepSelect áp đặt các yêu cầu căn chỉnh đối với hàng đầu vào và hàng đầu ra. Hãy kiểm tra chúng trong thời gian chạy:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
Nếu stride của một hàng đầu vào không phải là bội số của độ căn chỉnh đầu vào bắt buộc, hãy đệm tensor trước khi truyền vào DeepSelect. Chiều cuối phải tiếp tục liên tục.
Theo mặc định, DeepSelect cấp phát cả hai đầu ra. Stride của chúng được căn chỉnh theo deep_select.get_stride_requirement()[1] byte, nên các tensor trả về có thể không liên tục. Mã sử dụng các đầu ra không nên giả định stride liên tục tiêu chuẩn.
Sử dụng buffer chỉ mục có sẵn
API chấp nhận output_idx= khi các chỉ mục cần được ghi vào buffer do bên gọi quản lý. Buffer đó phải đáp ứng cùng yêu cầu về stride đầu ra. Hãy tham khảo deep_select/interface.py để xem chữ ký hàm đầy đủ trước khi cấu hình buffer tùy chỉnh.
Làm việc với các hàng có độ dài thay đổi
Sử dụng end để gán giới hạn trên độc quyền cho từng hàng. Cách này hữu ích khi các hàng trong cùng một batch có độ dài hợp lệ khác nhau:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
Ở đây, hàng đầu tiên có thể sử dụng toàn bộ 129280 phần tử, trong khi hàng thứ hai chỉ giới hạn ở 100000 phần tử đầu tiên. Nếu một hàng ngắn hơn kích thước TopK được yêu cầu, DeepSelect sẽ bổ sung các đầu ra của hàng đó bằng value_oob_fill_value và idx_oob_fill_value.
Xử lý NaN
Việc kiểm tra NaN luôn được bật. Theo mặc định, abort_when_nan_found=True, vì vậy kernel gọi trap() và dừng khi phát hiện NaN. Các hàng có độ dài hợp lệ nhỏ hơn hoặc bằng kích thước TopK được yêu cầu sẽ không được kiểm tra NaN.
Hãy xác thực hoặc làm sạch dữ liệu đầu vào trước khi khởi chạy kernel nếu có khả năng xuất hiện NaN, đặc biệt khi vẫn giữ hành vi dừng mặc định.
Mẹo về hiệu năng và nâng cao
- Tuân thủ phạm vi TopK được hỗ trợ. DeepSelect hỗ trợ các giá trị TopK nhỏ, tối đa và bao gồm
4096. Các giá trị lớn hơn không được hỗ trợ. - Phù hợp với khối lượng công việc dự kiến. Sử dụng
torch.bfloat16cho kịch bản Lightning Indexer vàtorch.float32cho kịch bản lấy mẫu được dự án mô tả. - Bỏ qua việc sắp xếp khi có thể. Sắp xếp theo chỉ mục hoặc giá trị làm giảm hiệu năng, vì vậy chỉ yêu cầu khi quá trình xử lý tiếp theo cần đến.
- Bỏ qua giá trị khi có thể. Đặt
return_value=Falsekhi chỉ sử dụng các chỉ mục. - Kiểm tra căn chỉnh sớm. Lập kế hoạch hình dạng tensor và phần đệm dựa trên
get_stride_requirement()thay vì sửa các tensor không tương thích trong vòng lặp quan trọng về hiệu năng. - Không giả định đầu ra liên tục. DeepSelect căn chỉnh stride của các hàng đầu ra, vì vậy các tensor kết quả có thể không liên tục.
- Đo hiệu năng với hình dạng thực tế. Hiệu năng TopK phụ thuộc vào kiểu dữ liệu đầu vào, kích thước batch, kích thước từ vựng và kích thước TopK. Hãy kiểm thử đúng cấu hình mà ứng dụng sử dụng.
Chạy benchmark được cung cấp
Kho mã nguồn có chế độ đo hiệu năng trong tập lệnh kiểm thử:
python3 tests/test.py --perf-onlyBenchmark này so sánh DeepSelect với torch.topk trên cùng dữ liệu đầu vào và báo cáo tỷ lệ dựa trên băng thông bộ nhớ hiệu dụng.
Kết luận
DeepSelect cung cấp các kernel TopK chuyên biệt cho các khối lượng công việc tương thích với DeepSeek Sparse Attention và lấy mẫu. Hãy bắt đầu với một tensor CUDA hai chiều đã được căn chỉnh, giữ topk ở mức không quá 4096, đồng thời tắt việc sắp xếp hoặc xuất giá trị khi không cần thiết. Khi tích hợp vào môi trường production, hãy xác minh các yêu cầu về stride, lưu ý rằng đầu ra có thể không liên tục và đo hiệu năng với đúng hình dạng tensor mà ứng dụng sử dụng.