

Tiny Classifiers hoạt động như thế nào
tiny-classifiers là một công thức thực tiễn để huấn luyện các bộ phân loại văn bản nhỏ, chuyên biệt cho từng tác vụ. Công cụ này sử dụng bộ mã hóa Ettin-17M với 17 triệu tham số, tinh chỉnh toàn bộ trọng số và lưu kết quả dưới dạng một mô hình Hugging Face tiêu chuẩn.
Dự án được thiết kế cho các tác vụ phân loại như định tuyến tin nhắn ngân hàng, phân loại tin tức, nhận diện ý định người dùng, phát hiện cảm xúc hoặc gán tài liệu pháp lý vào các danh mục định trước. Nếu không có đủ ví dụ đã gắn nhãn, một mô hình ngôn ngữ lớn hơn có thể đóng vai trò giáo viên và gắn nhãn cho tập huấn luyện.
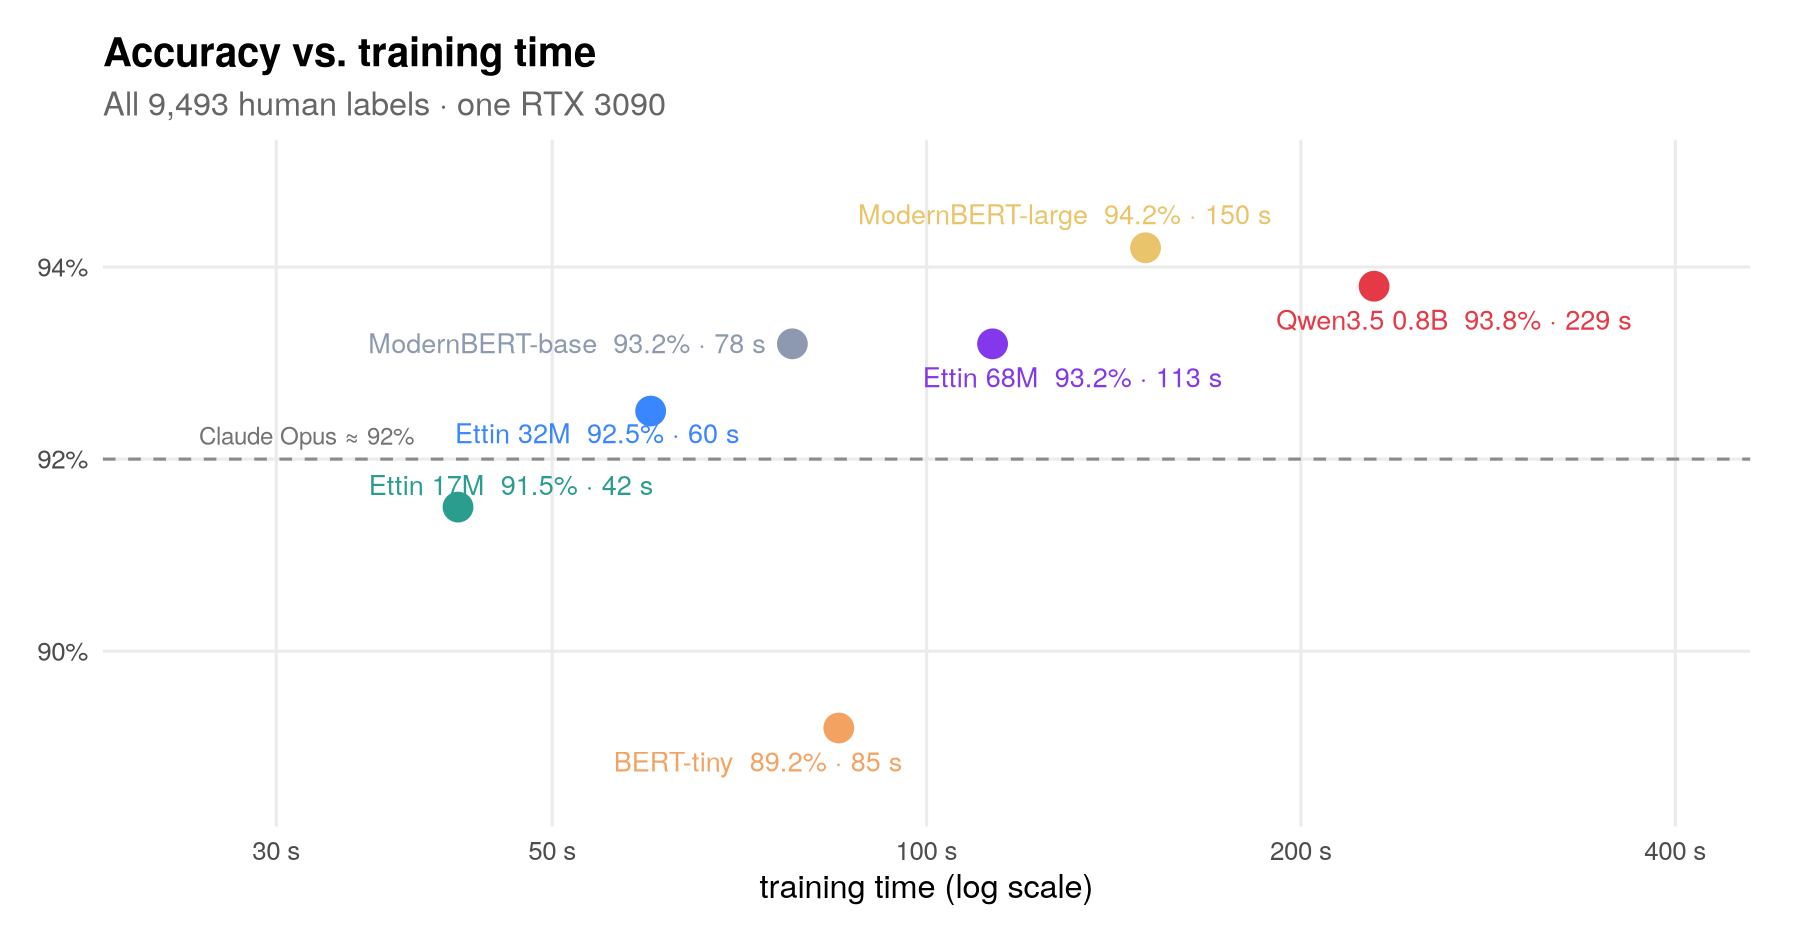
Trong thử nghiệm Banking77 của kho lưu trữ, Ettin-17M đạt độ chính xác 91.5%, so với 92% của Claude Opus. Quá trình huấn luyện mất 42 giây trên một GPU chơi game, trong khi suy luận mất khoảng 5 mili giây cho mỗi tin nhắn. Việc huấn luyện cũng hoạt động trên CPU máy tính xách tay trong khoảng 11 phút và trên GPU điện thoại trong khoảng 21 phút.
Độ chính xác Banking77 so với thời gian huấn luyện.
Tính năng chính
- Mô hình cục bộ nhỏ: Ettin-17M có 17 triệu tham số và tạo ra một điểm số cho mỗi danh mục.
- Nhãn do người hoặc giáo viên tạo: Huấn luyện bằng nhãn đã được xác minh hoặc yêu cầu Kimi K3 gắn nhãn cho các tin nhắn chưa có nhãn.
- Huấn luyện bằng GPU và CPU: Tập lệnh huấn luyện hỗ trợ cả hai môi trường.
- Đầu ra mô hình tiêu chuẩn: Các bộ phân loại đã huấn luyện có thể được tải thông qua pipeline
transformerscủa Hugging Face. - Gắn nhãn có thể tiếp tục: Tập lệnh gắn nhãn hỗ trợ thử lại, đồng thời thích ứng, xử lý dự phòng cho các yêu cầu chậm và ngân sách theo nhà cung cấp.
- Đánh giá tích hợp: Quá trình huấn luyện báo cáo độ chính xác trên tập kiểm tra, trong khi việc gắn nhãn bằng giáo viên có thể đo độ chính xác của giáo viên trên một tập kiểm tra đã gắn nhãn.
- Phân tích chi phí: Tập lệnh hòa vốn ước tính thời điểm chi phí gắn nhãn và huấn luyện thấp hơn chi phí trả cho dịch vụ phân loại qua API.
- Chuẩn bị dữ liệu có thể tái sử dụng: Dự án có thể chuẩn bị mười bộ dữ liệu phân loại công khai bằng một cấu trúc nhất quán.
Công thức huấn luyện hoạt động như thế nào
Ettin-17M là một bộ mã hóa mở do Johns Hopkins phát triển và có liên quan đến các mô hình kiểu BERT. Không giống mô hình sinh tạo văn bản theo từng token, nó đọc toàn bộ đầu vào và gán điểm số cho mọi danh mục khả dụng.
Kho lưu trữ bổ sung một đầu ra cho mỗi danh mục và tinh chỉnh mọi trọng số của mô hình. Công thức mặc định sử dụng kích thước batch 32, AdamW với tốc độ học 1e-4, suy giảm trọng số 0.01, khởi động 5% sau đó suy giảm cosine, cắt gradient ở 1.0 và hàm mất mát cross-entropy.
Với khoảng 9,500 tin nhắn, quá trình huấn luyện chạy qua sáu lượt. Với chỉ 2,000 ví dụ, công cụ sử dụng cùng số bước tối ưu hóa, tương đương khoảng 28 lượt. README nhấn mạnh rằng các thiết lập này không được tinh chỉnh riêng cho từng tác vụ.
Cài đặt và thiết lập
1. Cài đặt uv
Các tập lệnh sử dụng uv để tạo môi trường cần thiết và tự động cài đặt các phần phụ thuộc trong lần chạy đầu tiên. Cài đặt uv theo hướng dẫn dành cho hệ điều hành của bạn, sau đó mở terminal tại thư mục gốc của kho lưu trữ.
2. Chuẩn bị các bộ dữ liệu công khai
Chạy tập lệnh chuẩn bị:
uv run recipe/prepare.pyTập lệnh này tải Banking77, CLINC150, MASSIVE bằng tiếng Anh và tiếng Pháp, TREC, AG News, SST-5, Financial PhraseBank, LEDGAR và một bộ dữ liệu nhận diện lời nói thù ghét trong tweet từ Hugging Face Hub.
Với mỗi tác vụ, tập lệnh tạo một thư mục bên dưới data/tasks/. Tập lệnh xây dựng định nghĩa tác vụ, 2,000 tin nhắn huấn luyện, một phân tách huấn luyện lớn hơn chứa tối đa 150 ví dụ cho mỗi danh mục và một tập kiểm tra.
3. Cấu hình nhà cung cấp dịch vụ gắn nhãn
Nếu muốn một mô hình giáo viên tạo nhãn, hãy đặt khóa API cho một hoặc nhiều nhà cung cấp được hỗ trợ:
export OPENROUTER_API_KEY=...Công thức cũng nhận diện các khóa nhà cung cấp liên quan đến Fireworks, Together, DeepInfra và Parasail. Hãy kiểm tra giá hiện tại, chính sách sử dụng và điều khoản mô hình của nhà cung cấp tương ứng trước khi gửi dữ liệu hoặc sử dụng câu trả lời được tạo để huấn luyện.
Hướng dẫn cơ bản: Huấn luyện bộ phân loại AG News
Bước 1: Tạo nhãn bằng Kimi K3
Sau khi chuẩn bị các bộ dữ liệu, hãy gắn nhãn cho 2,000 tin nhắn huấn luyện AG News:
uv run recipe/label.py data/tasks/agnewsTrong lần chạy được báo cáo, Kimi K3 đã gắn nhãn 2,000 ví dụ trong khoảng 20 giây với chi phí khoảng $1. Thời gian và chi phí thực tế có thể thay đổi tùy nhà cung cấp. Tập lệnh có thể tiếp tục, vì vậy công việc gắn nhãn bị gián đoạn không cần bắt đầu lại từ đầu.
Bước 2: Tinh chỉnh Ettin-17M trên nhãn của giáo viên
Truyền tệp nhãn đã tạo vào tập lệnh huấn luyện và chọn một thư mục đầu ra:
uv run recipe/train.py data/tasks/agnews --labels labels/agnews-train.jsonl --save models/agnewsTập lệnh tinh chỉnh bộ phân loại, đánh giá mô hình trên tập kiểm tra, in độ chính xác kiểm tra và lưu một mô hình tương thích với Hugging Face tại models/agnews.
Bước 3: Huấn luyện đường cơ sở bằng nhãn của con người
Chạy cùng tập lệnh huấn luyện nhưng không có tham số nhãn giáo viên để huấn luyện trên các nhãn gốc do con người tạo:
uv run recipe/train.py data/tasks/agnewsSo sánh này giúp cho thấy hiệu suất đã giảm bao nhiêu trong quá trình chưng cất tri thức. Trong lần chạy hướng dẫn của kho lưu trữ, nhãn con người đạt độ chính xác 89.2%, nhãn Kimi K3 đạt 85.1% và nhãn Qwen3.8-27B đạt 81.8%.
Bước 4: Phân loại văn bản mới
Tải mô hình đã lưu bằng pipeline của Hugging Face:
from transformers import pipeline

classify = pipeline(
    "text-classification",
    model="models/agnews",
    device="cpu"
)

result = classify(
    "NASA's new telescope finds water vapour on a distant planet"
)
print(result)
Kết quả là một danh sách chứa nhãn dự đoán và điểm số của nhãn đó. Trong ví dụ này, danh mục dự kiến là Sci/Tech. Mô hình AG News được báo cáo đã xử lý một thông báo trong khoảng 6 mili giây trên CPU.
Sử dụng bộ phân loại nhỏ với dữ liệu của riêng bạn
1. Tạo thư mục tác vụ
Tạo một thư mục theo cùng bố cục với data/tasks/agnews/. Mỗi tác vụ tùy chỉnh cần có các tệp task.json, train.jsonl và test.jsonl.
2. Xác định các danh mục
Tệp task.json phải chứa tên, một câu hướng dẫn và danh sách đầy đủ các nhãn:
{"name":"support-routing","instruction":"Assign each support message to the correct team.","labels":["billing","technical","account"]}Sử dụng các tên nhãn khác biệt và có ý nghĩa. Câu hướng dẫn nên mô tả rõ quyết định phân loại mà mô hình hoặc mô hình giáo viên phải đưa ra.
3. Thêm bản ghi huấn luyện và kiểm thử
Lưu mỗi đối tượng JSON trên một dòng. Bản ghi có nhãn có cấu trúc như sau:
{"id":"msg-001","text":"I was charged twice for my subscription.","label":"billing"}Nếu mô hình giáo viên sẽ gắn nhãn cho dữ liệu huấn luyện, các bản ghi trong train.jsonl có thể bỏ trường label:
{"id":"msg-002","text":"The application closes whenever I upload a file."}Các bản ghi kiểm thử nên có nhãn đã được xác minh để bạn có thể đo độ chính xác của cả giáo viên và học sinh. Dự án khuyến nghị kiểm tra thủ công vài trăm thông báo kiểm thử trước khi tin dùng mô hình trong môi trường sản xuất.
4. Gắn nhãn, huấn luyện và đánh giá
Thay thư mục của bạn vào các lệnh chuẩn:
uv run recipe/label.py data/tasks/support-routing
uv run recipe/train.py data/tasks/support-routing \
  --labels labels/support-routing-train.jsonl \
  --save models/support-routing
Bạn cũng có thể huấn luyện trực tiếp trên các nhãn do con người tạo bằng cách bỏ qua --labels. Để sử dụng encoder khác thay cho Ettin-17M, truyền mô hình qua tùy chọn --model của tập lệnh huấn luyện.
Đo lường thời điểm tinh chỉnh mang lại hiệu quả
Chạy phân tích điểm hòa vốn sau khi chuẩn bị các tác vụ:
uv run recipe/breakeven.pyTập lệnh này ước tính cần phân loại bao nhiêu thông báo để thu hồi chi phí ban đầu cho việc gắn nhãn và huấn luyện, xét cả tiền bạc lẫn thời gian. So với API phân loại zero-shot Jev, kho mã nhận thấy điểm hòa vốn vào khoảng 50.000 đến 500.000 thông báo, tùy theo tác vụ.
Nếu khối lượng của bạn nhỏ hoặc chưa chắc chắn, API có thể là lựa chọn đơn giản hơn. Tinh chỉnh trở nên hấp dẫn hơn khi tác vụ ổn định, đã có dữ liệu đánh giá và khối lượng phân loại cao.
Mẹo nâng cao
Ưu tiên chất lượng nhãn
Các thử nghiệm cho thấy nhãn quan trọng hơn kích thước mô hình. Đường cong học tập tiếp tục cải thiện khi bổ sung thêm ví dụ được gắn nhãn. Học sinh được huấn luyện bởi giáo viên thường thấp hơn giáo viên vài điểm độ chính xác, trong khi nhãn do con người tạo có thể phá vỡ giới hạn đó.
Xem xét các danh mục mơ hồ, sửa lỗi gắn nhãn có tính hệ thống và bổ sung các ví dụ đại diện trước khi thay đổi kiến trúc hoặc tinh chỉnh nhiều siêu tham số.
Đánh giá riêng mô hình giáo viên
Một học sinh không thể bù đắp đáng tin cậy cho một giáo viên hoạt động kém trên tác vụ. Kết quả trên mười tác vụ cho thấy các mô hình được giáo viên gắn nhãn bị tụt lại ở những nơi bản thân giáo viên yếu hơn. Hãy duy trì một tập kiểm thử đã được con người kiểm tra và đo độ chính xác của giáo viên trước khi trả phí để gắn nhãn một tập dữ liệu lớn hơn nhiều.
Tính đến biến động trong thí nghiệm
README báo cáo biến động khoảng ±0,5 điểm phần trăm do các seed ngẫu nhiên và ±1,5 đến 2 điểm do kích thước tập kiểm thử. Các bảng được công bố sử dụng giá trị trung bình của ba lần chạy. Hãy dùng nhiều lần chạy và các tập kiểm thử đủ lớn khi những khác biệt nhỏ về độ chính xác ảnh hưởng đến quyết định triển khai.
Tôn trọng giấy phép và điều khoản của nhà cung cấp
Chỉ huấn luyện trên các câu trả lời được tạo khi giấy phép của mô hình giáo viên và điều khoản của nhà cung cấp cho phép. Kho mã sử dụng Kimi K3, nhưng một số mô hình và API cấm dùng đầu ra của chúng để huấn luyện mô hình khác. Các tập dữ liệu công khai cũng có giấy phép riêng; kho mã tải chúng xuống thay vì phân phối lại.
Khám phá phần cứng thay thế
Tập lệnh huấn luyện chính hỗ trợ thực thi trên CPU và GPU. Kho mã cũng bao gồm một triển khai riêng cho điện thoại, huấn luyện thông qua Chrome bằng WebGPU và jax-js. Hãy coi quy trình trên điện thoại là một triển khai chuyên biệt và làm theo hướng dẫn trong thư mục phone/ của dự án.
Khắc phục sự cố NixOS đã được ghi nhận
Nếu quá trình huấn luyện trên NixOS thất bại vì không tìm thấy /sbin/ldconfig, hãy đặt đường dẫn thư viện CUDA trước khi chạy huấn luyện:
export TRITON_LIBCUDA_PATH=/run/opengl-driver/libKết luận
tiny-classifiers cung cấp một quy trình gọn nhẹ để chuyển văn bản đã gắn nhãn thành bộ phân loại nhanh chạy cục bộ: chuẩn bị tác vụ, lấy nhãn do con người hoặc giáo viên tạo, tinh chỉnh Ettin-17M, đánh giá trên các ví dụ đã được kiểm tra và ước tính liệu suy luận cục bộ có hiệu quả kinh tế hơn API hay không.
Bài học quan trọng nhất là đầu tư vào nhãn và dữ liệu đánh giá đáng tin cậy. Khi đã có chúng, một encoder 17 triệu tham số có thể mang lại độ chính xác phân loại cao, suy luận ở mức mili giây và chi phí vận hành cục bộ có thể dự đoán mà không cần gọi mô hình lớn cho mọi thông báo.