

Recurrent Looped Transformer là gì?
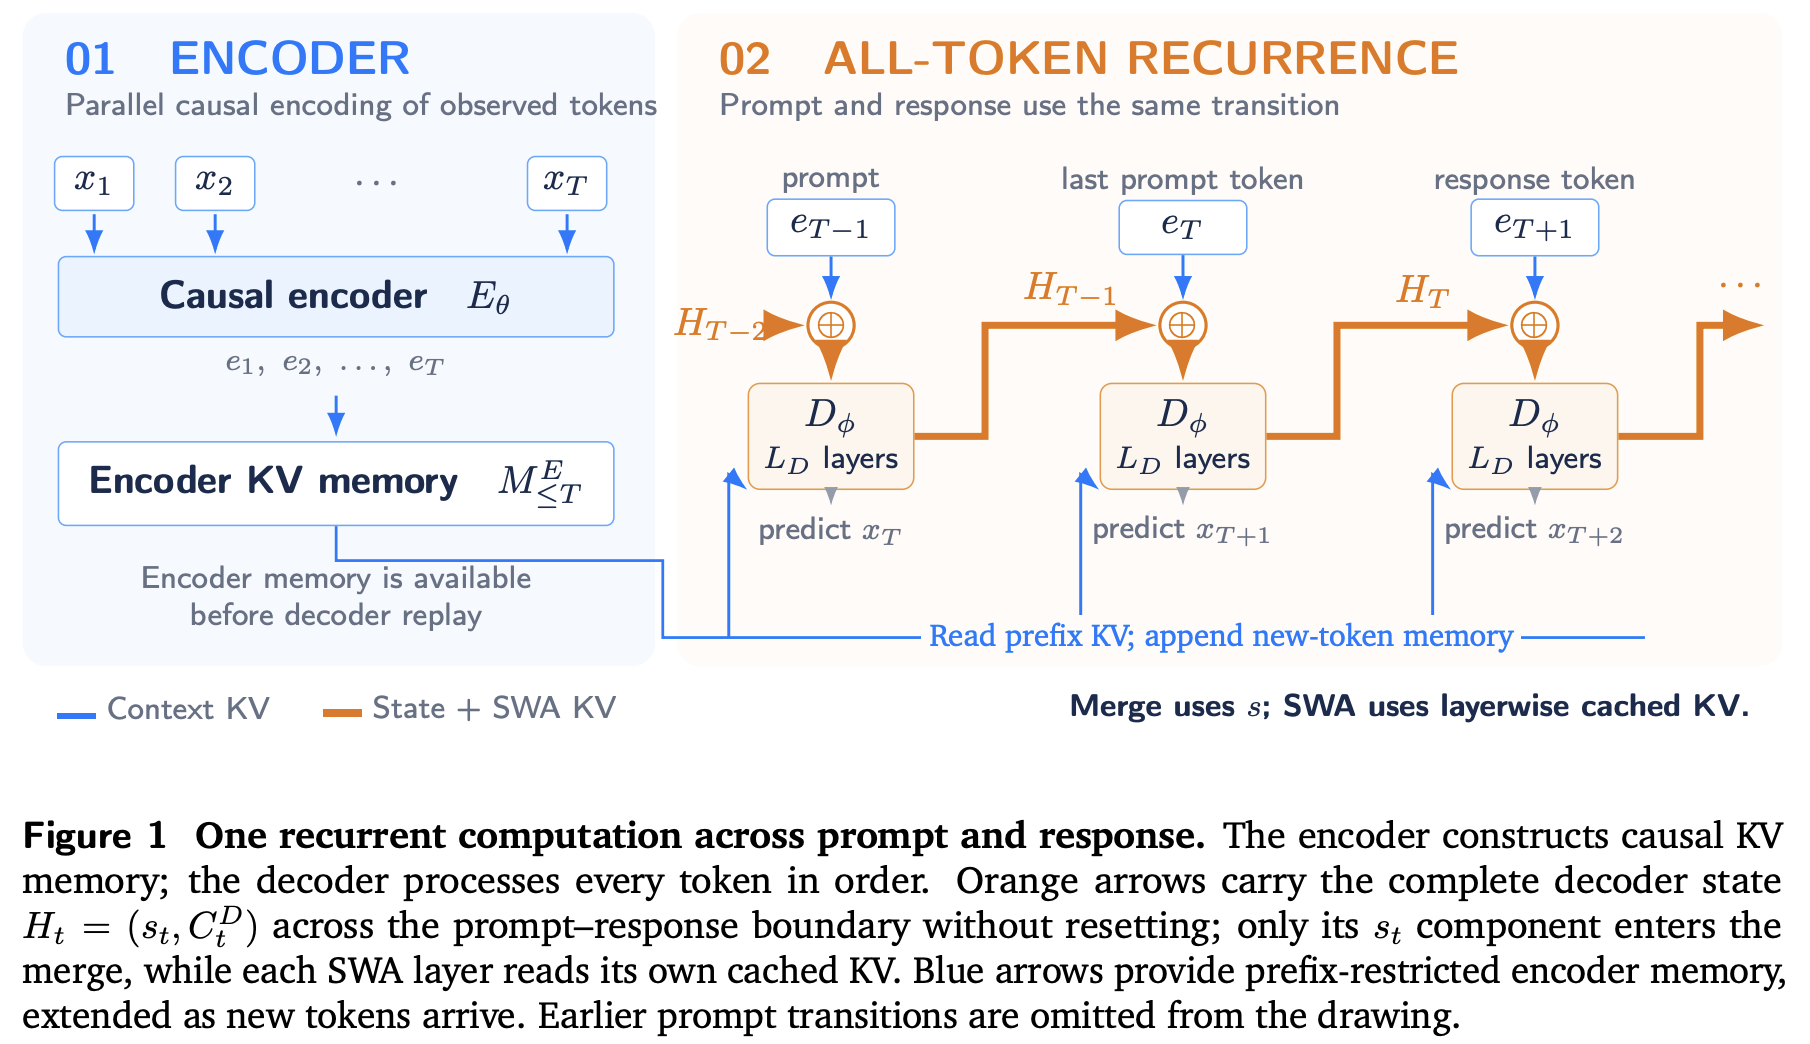
Recurrent Looped Transformer (RLT) là một kiến trúc nghiên cứu được thiết kế để duy trì quá trình tính toán ẩn qua mọi token trong một chuỗi. Bộ mã hóa nhân quả xây dựng bộ nhớ toàn cục dạng key–value, trong khi bộ giải mã hồi quy kết hợp bộ nhớ đó với cơ chế chú ý theo cửa sổ trượt và phản hồi từ trạng thái ẩn cuối cùng trước đó.
Điều này tạo ra một đường tính toán thời gian có thể mở rộng. Nếu bộ giải mã có L_D lớp, việc xử lý t token tạo ra một đường hồi quy đi qua tL_D khối giải mã, dù mô hình chỉ thực thi một số lượng khối cố định cho mỗi token.
Trong dự án này, “độ sâu thời gian vô hạn” có nghĩa là đường tính toán có thể tăng theo độ dài chuỗi. Điều đó không có nghĩa là mô hình thực hiện phép tính vô hạn trong một token duy nhất.
Nguyên tắc thiết kế chính
1. Suy luận ẩn theo thời gian
Đầu ra cuối cùng của bộ giải mã cho một token trở thành đầu vào của token tiếp theo. Do đó, mô hình có thể truyền trạng thái ẩn xuyên suốt prompt và phản hồi được tạo ra, thay vì xem ranh giới prompt–phản hồi như một điểm đặt lại.
2. Đồng thiết kế mô hình và phần cứng
Thiết kế được đề xuất mở ra một số cơ hội tối ưu hóa:
- Tính toán bộ mã hóa nhân quả song song trên các token đã biết
- Gom lô các chuỗi độc lập
- Tái sử dụng bộ nhớ được suy ra từ bộ mã hóa
- Checkpoint activation quanh quá trình thực thi bộ giải mã hồi quy
Đây là các cơ hội thiết kế và mục tiêu nghiên cứu. Báo cáo không tuyên bố đã đo được mức tăng tốc phần cứng quy mô lớn.
3. Ngữ nghĩa dùng chung cho huấn luyện và học tăng cường
Tiền huấn luyện, tinh chỉnh có giám sát, lấy mẫu và phát lại học tăng cường theo chính sách hiện tại đều sử dụng cùng một chuyển trạng thái đầy đủ. Trạng thái này bao gồm cả quá trình hồi quy của prompt và các bộ nhớ đệm key–value theo cửa sổ trượt của bộ giải mã.
Kiến trúc hoạt động như thế nào
Với một token x_t, bộ mã hóa nhân quả tạo ra biểu diễn e_t và bộ nhớ toàn cục bắt nguồn từ bộ mã hóa M_≤t. Trạng thái bộ giải mã chứa cả đầu ra hồi quy và bộ nhớ đệm chú ý theo cửa sổ trượt ở từng lớp:
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
Chuyển trạng thái là:
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
Phân phối token tiếp theo được tính từ đầu ra hồi quy cuối cùng:
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))Ba dạng ngữ cảnh
- Ngữ cảnh toàn cục của bộ mã hóa: Cơ chế chú ý chéo của bộ giải mã chỉ đọc bộ nhớ bộ mã hóa thông qua vị trí hiện tại, qua đó duy trì tính nhân quả.
- Bộ nhớ cục bộ của bộ giải mã: Cơ chế chú ý theo cửa sổ trượt đọc các mục key–value gần đây của bộ giải mã và mục của token hiện tại. Cửa sổ kích thước
Wbao gồm token hiện tại, nên ở lần cập nhật tiếp theo chỉ còn tối đaW - 1mục lịch sử. - Phản hồi theo thời gian: Đầu ra bộ giải mã cuối cùng trước đó được hợp nhất với biểu diễn bộ mã hóa hiện tại.
Cả đầu ra hồi quy lẫn bộ nhớ đệm của bộ giải mã đều không được đặt lại khi chuỗi chuyển từ prompt sang phản hồi.
Cấu hình mô hình cụ thể
Báo cáo mô tả một cấu hình gồm 48 lớp mã hóa và 48 lớp giải mã. Các trọng số chú ý và truyền xuôi tương thích được dùng chung giữa các giai đoạn. Ngoài ra, các khối giải mã thực hiện chú ý chéo trên bộ nhớ bộ mã hóa, vì vậy số lớp giống nhau không đồng nghĩa với số phép toán dấu phẩy động giống nhau.
Cài đặt và thiết lập kho mã
README trình bày một báo cáo về kiến trúc thay vì một gói phần mềm có tài liệu đầy đủ. Tài liệu không cung cấp yêu cầu phụ thuộc, lệnh cài đặt, script huấn luyện công khai hoặc API có thể chạy. Bạn vẫn có thể sao chép kho mã để đọc bài báo và tài liệu hỗ trợ:
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformer
Hãy bắt đầu với tệp Recurrent_Looped_Transformer.pdf đi kèm. Bạn cũng có thể truy cập trang web của dự án và xem ghi chú về sự không tương thích kernel prefill–decode.
Vì README không mô tả một triển khai có thể thực thi, không nên suy ra hướng dẫn cài đặt gói hoặc mã mô hình có thể chạy ngay từ phần mô tả kho mã.
Cách sử dụng cơ bản: Làm theo mô hình thực thi RLT
Cách hữu ích nhất để áp dụng báo cáo là xem nó như một bản thiết kế triển khai. Mã giả khái niệm sau đây tóm tắt một lần chuyển trạng thái; đây không phải là API do kho mã cung cấp:
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
Prefill prompt
- Chạy bộ mã hóa nhân quả trên các token prompt đã biết theo dạng một lô.
- Thực hiện hồi quy qua mọi token prompt bằng bộ giải mã.
- Xây dựng bộ nhớ đệm key–value theo cửa sổ trượt của bộ giải mã trong quá trình hồi quy này.
- Giữ lại đầu ra hồi quy cuối cùng và bộ nhớ đệm để tạo sinh.
Chỉ chạy encoder trong giai đoạn điền prompt sẽ không tái tạo đầy đủ trạng thái RLT được mô tả trong báo cáo.
Sinh tự hồi quy
- Sử dụng trạng thái trước đó để tính phân phối cho token tiếp theo.
- Lấy mẫu một token từ phân phối đó.
- Mã hóa token được lấy mẫu theo từng bước.
- Đưa token đó qua bộ giải mã hồi quy đúng một lần.
- Cập nhật cả đầu ra hồi quy và bộ nhớ đệm cửa sổ trượt.
Thứ tự này tránh việc một token được sinh ra bị tiêu thụ hai lần và duy trì cùng ngữ nghĩa chuyển trạng thái được sử dụng trong quá trình huấn luyện.
Tiền huấn luyện và tinh chỉnh có giám sát
Trong quá trình tiền huấn luyện, encoder chạy theo nhân quả và bộ giải mã hồi quy sử dụng lan truyền ngược đầy đủ qua thời gian. Mọi mục tiêu token tiếp theo hợp lệ đều được giám sát.
Trong quá trình tinh chỉnh có giám sát, trạng thái được cập nhật trên tất cả token ngữ cảnh, nhưng hàm mất mát chỉ được áp dụng cho các mục tiêu của trợ lý. Prompt vẫn tham gia vào việc xây dựng trạng thái hồi quy ngay cả khi các token của nó không được giám sát.
Phát lại học tăng cường theo chính sách hiện tại
Phát lại theo chính sách hiện tại phải tái dựng toàn bộ lịch sử chuỗi bằng các trọng số hiện tại của mô hình. Điều này bao gồm các đầu ra hồi quy, bộ nhớ encoder và tất cả bộ nhớ đệm cửa sổ trượt của bộ giải mã.
- Tái dựng các biểu diễn và bộ nhớ của encoder bằng các tham số hiện tại.
- Phát lại mọi token trước đó để tái dựng trạng thái hồi quy và các bộ nhớ đệm của bộ giải mã.
- Đánh giá xác suất của một hành động trước khi tiêu thụ token hành động đó.
- Tiêu thụ hành động một lần để chuyển sang trạng thái tiếp theo.
Các bộ nhớ đệm phụ thuộc vào tham số sẽ trở nên lỗi thời sau khi trọng số được cập nhật, vì vậy việc phát lại chính xác đòi hỏi phải tái dựng chúng. Gradient đầy đủ truyền qua các đầu ra hồi quy, các mục khóa-giá trị của bộ giải mã và bộ nhớ encoder. Tách bất kỳ thành phần nào trong số này đều là một phép xấp xỉ gradient.
Log-xác suất hành vi phải tương ứng với phân phối thực sự được sử dụng để lấy mẫu. Việc lấy mẫu tầm quan trọng chính xác cũng đòi hỏi độ bao phủ miền hỗ trợ. Ngữ nghĩa thực thi thống nhất làm giảm sự không khớp về ranh giới prompt theo cấu trúc, nhưng không đảm bảo sự tương đồng số học giữa các kernel hoặc một mục tiêu off-policy không chệch.
Kết quả tổng hợp sơ bộ
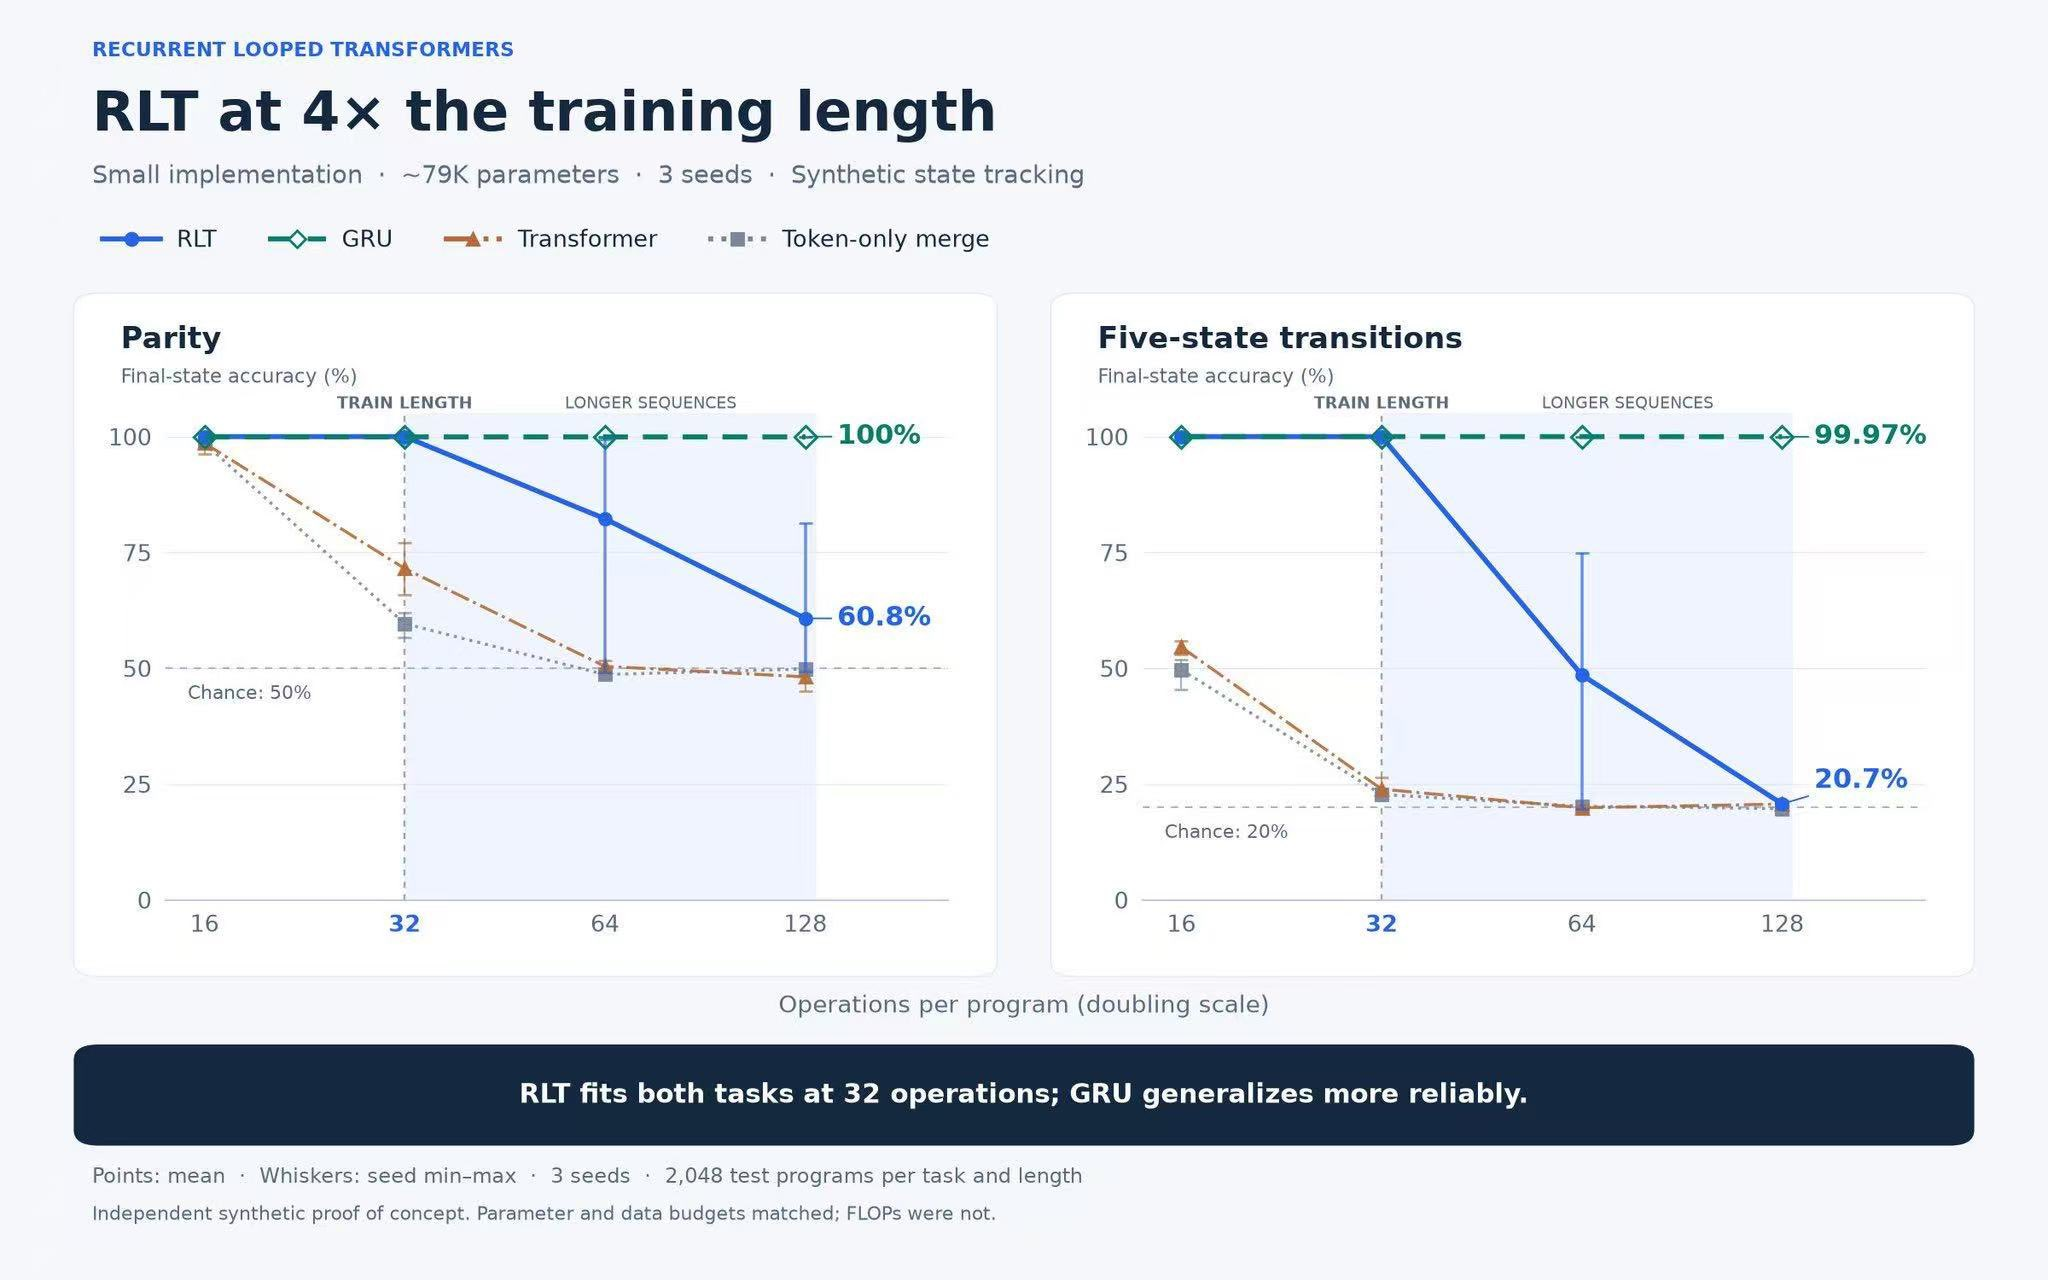
README báo cáo các thí nghiệm theo dõi trạng thái nhằm chứng minh khái niệm độc lập, sử dụng một triển khai nhỏ với khoảng 79.000 tham số và ba seed ngẫu nhiên. Các mô hình được huấn luyện trên các chuỗi gồm 32 phép toán và được đánh giá với tối đa 128 phép toán, cùng 2.048 chương trình kiểm thử cho mỗi tác vụ và độ dài.
Tác vụ chẵn lẻ
- Ở 32 phép toán, RLT đạt độ chính xác trạng thái cuối khoảng 100%.
- Ở 64 phép toán, độ chính xác đạt khoảng 82%.
- Ở 128 phép toán, độ chính xác đạt 60,8%.
- Độ chính xác ngẫu nhiên đối với tác vụ chẵn lẻ là 50%.
Tác vụ chuyển đổi năm trạng thái
- Ở 32 phép toán, RLT đạt độ chính xác trạng thái cuối khoảng 100%.
- Ở 64 phép toán, độ chính xác đạt khoảng 49%.
- Ở 128 phép toán, độ chính xác đạt 20,7%.
- Độ chính xác ngẫu nhiên đối với tác vụ này là 20%.
Kết quả cho thấy RLT khớp với cả hai tác vụ ở độ dài huấn luyện, nhưng độ chính xác giảm trên các chuỗi dài hơn. Các giá trị được đánh dấu là xấp xỉ được đọc từ hình gốc, trong khi các giá trị RLT ở 128 phép toán được ghi nhãn bằng số.
Ngân sách tham số và dữ liệu được cân bằng, nhưng ngân sách phép toán dấu phẩy động thì không. Đây là các minh họa tổng hợp, không phải bằng chứng về cải thiện khả năng suy luận quy mô lớn, tăng tốc phần cứng hay khả năng mở rộng của học tăng cường.
Mẹo triển khai nâng cao
- Coi trạng thái đầy đủ là không thể tách rời: Bảo toàn cả
s_tvàC_t^D. Chỉ khôi phục vector hồi quy sẽ không tái tạo được chuyển trạng thái đã ghi nhận. - Không đặt lại tại ranh giới phản hồi: Tính hồi quy của prompt và bộ nhớ đệm bộ giải mã của nó phải truyền trực tiếp vào quá trình sinh phản hồi.
- Xác định chính xác cửa sổ: Cửa sổ trượt kích thước
Wbao gồm token hiện tại, vì vậy chỉ cònW - 1mục lịch sử khả dụng cho lần cập nhật tiếp theo. - Tái dựng bộ nhớ đệm sau khi cập nhật: Phát lại theo chính sách hiện tại yêu cầu các bộ nhớ đệm được tạo bởi trọng số hiện tại, thay vì các giá trị được lưu từ chính sách trước đó.
- Giữ đồng bộ thứ tự lấy mẫu và phát lại: Đánh giá hành động được sinh ra từ trạng thái trước đó, sau đó tiêu thụ hành động đó một lần.
- Phân biệt gradient chính xác với phép xấp xỉ: Tách trạng thái hồi quy, bộ nhớ đệm bộ giải mã hoặc bộ nhớ encoder sẽ thay đổi đường truyền gradient.
- Đo lường riêng chi phí tính toán: Ngân sách tham số hoặc dữ liệu bằng nhau không chứng minh FLOPs bằng nhau, đặc biệt vì các lớp bộ giải mã bổ sung attention chéo với bộ nhớ encoder.
- Xác thực hành vi số học: Ngữ nghĩa thực thi cấp cao thống nhất không tự động loại bỏ khác biệt giữa các kernel điền prompt và giải mã.
Kết luận
Recurrent Looped Transformer kết hợp bộ nhớ encoder nhân quả toàn cục, attention cửa sổ trượt cục bộ của bộ giải mã và phản hồi hồi quy giữa các token. Quy tắc triển khai cốt lõi của nó là tính nhất quán: mọi token prompt và phản hồi phải tham gia vào cùng một chuyển trạng thái đầy đủ trong suốt quá trình tiền huấn luyện, tinh chỉnh, sinh và phát lại theo chính sách hiện tại.
Các thí nghiệm sơ bộ cho thấy khả năng tổng quát hóa độ dài hữu ích trên các tác vụ theo dõi trạng thái quy mô nhỏ, nhưng hiệu suất vẫn giảm vượt quá độ dài huấn luyện. Do đó, kiến trúc này nên được xem là một đề xuất nghiên cứu và bằng chứng khái niệm, thay vì một hệ thống suy luận quy mô lớn đã được kiểm chứng.