

Benchmark Tác nhân Tuyển sinh Sau đại học Hoạt động Như thế nào
Benchmark Tác nhân Tuyển sinh Sau đại học đánh giá các cấu hình tác nhân dùng để tư vấn tuyển sinh sau đại học. Một cấu hình tác nhân kết hợp hệ thống thực thi với mô hình ngôn ngữ và được kiểm tra qua các nhiệm vụ đề xuất hồ sơ, lập kế hoạch, ra quyết định và cập nhật tư vấn khi có thông tin mới về sinh viên.
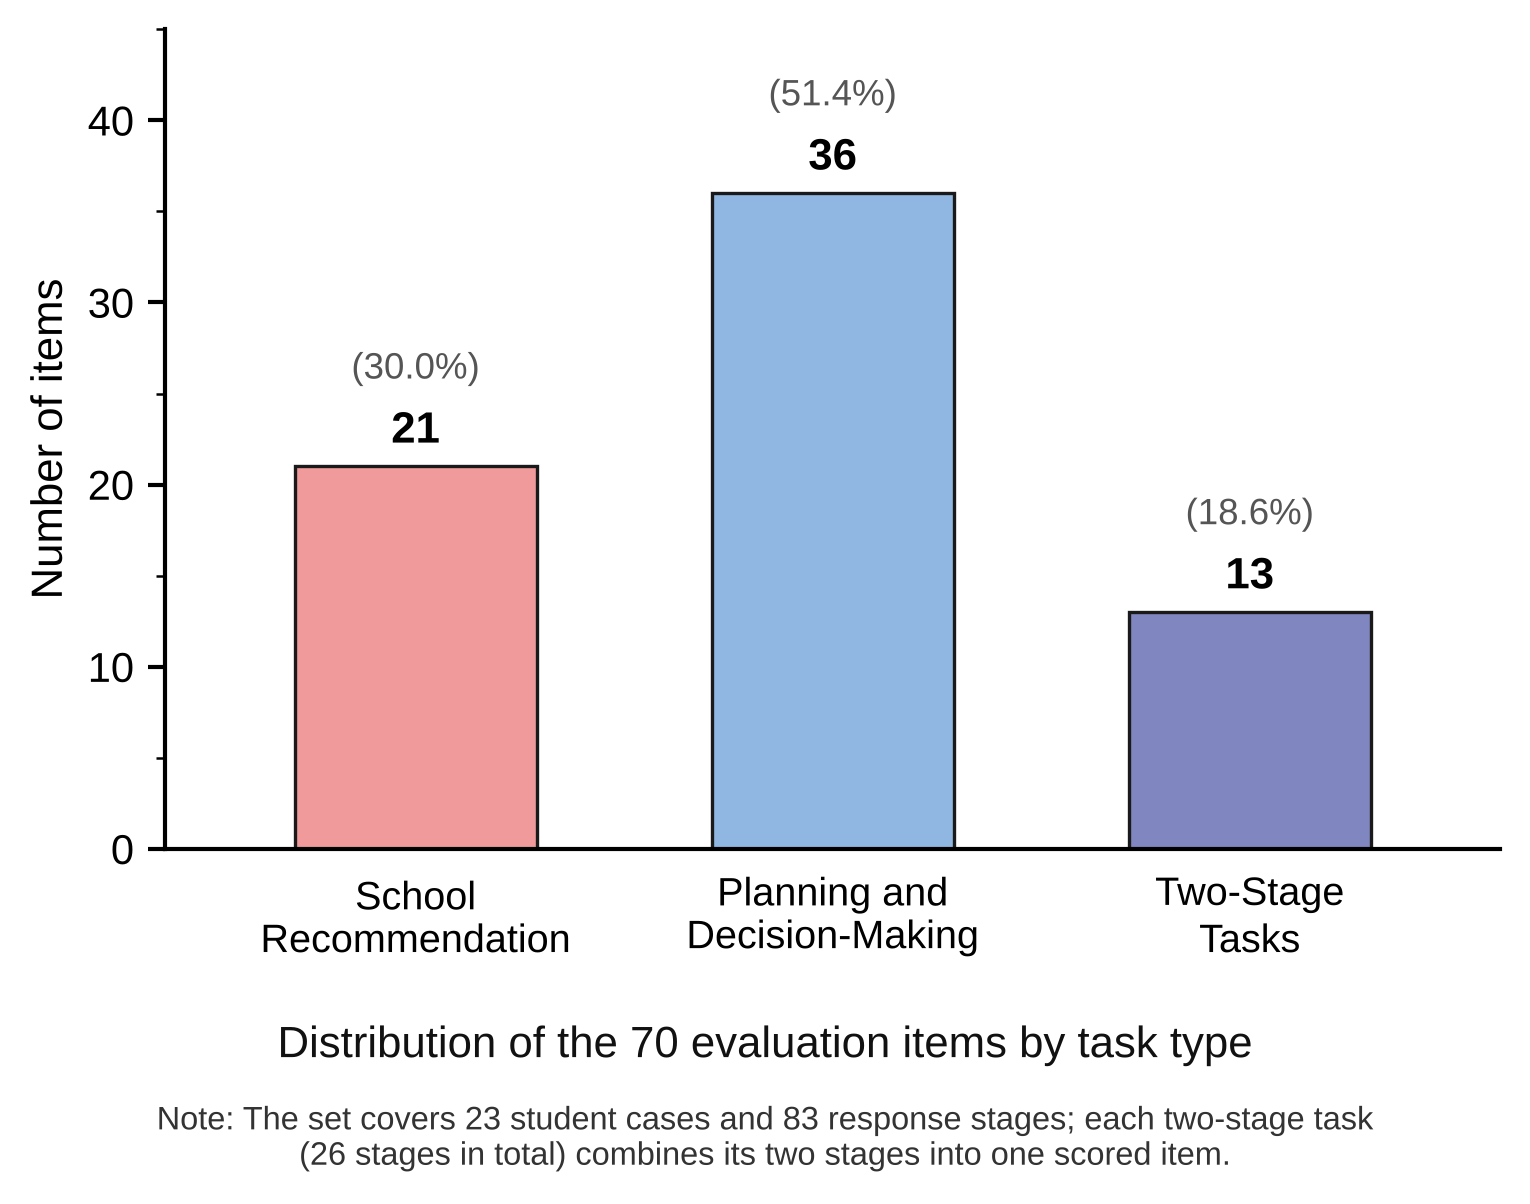
Benchmark hiện bao gồm 70 nhiệm vụ bằng tiếng Trung, 23 trường hợp và 83 giai đoạn trả lời. Mỗi nhiệm vụ có tiêu chí đánh giá và chương trình tham chiếu. Bộ dữ liệu công khai không yêu cầu phê duyệt quyền truy cập, nhưng tài liệu chấm điểm cần được giữ ngoài tầm truy cập của các tác nhân được đánh giá để tránh làm sai lệch kết quả.
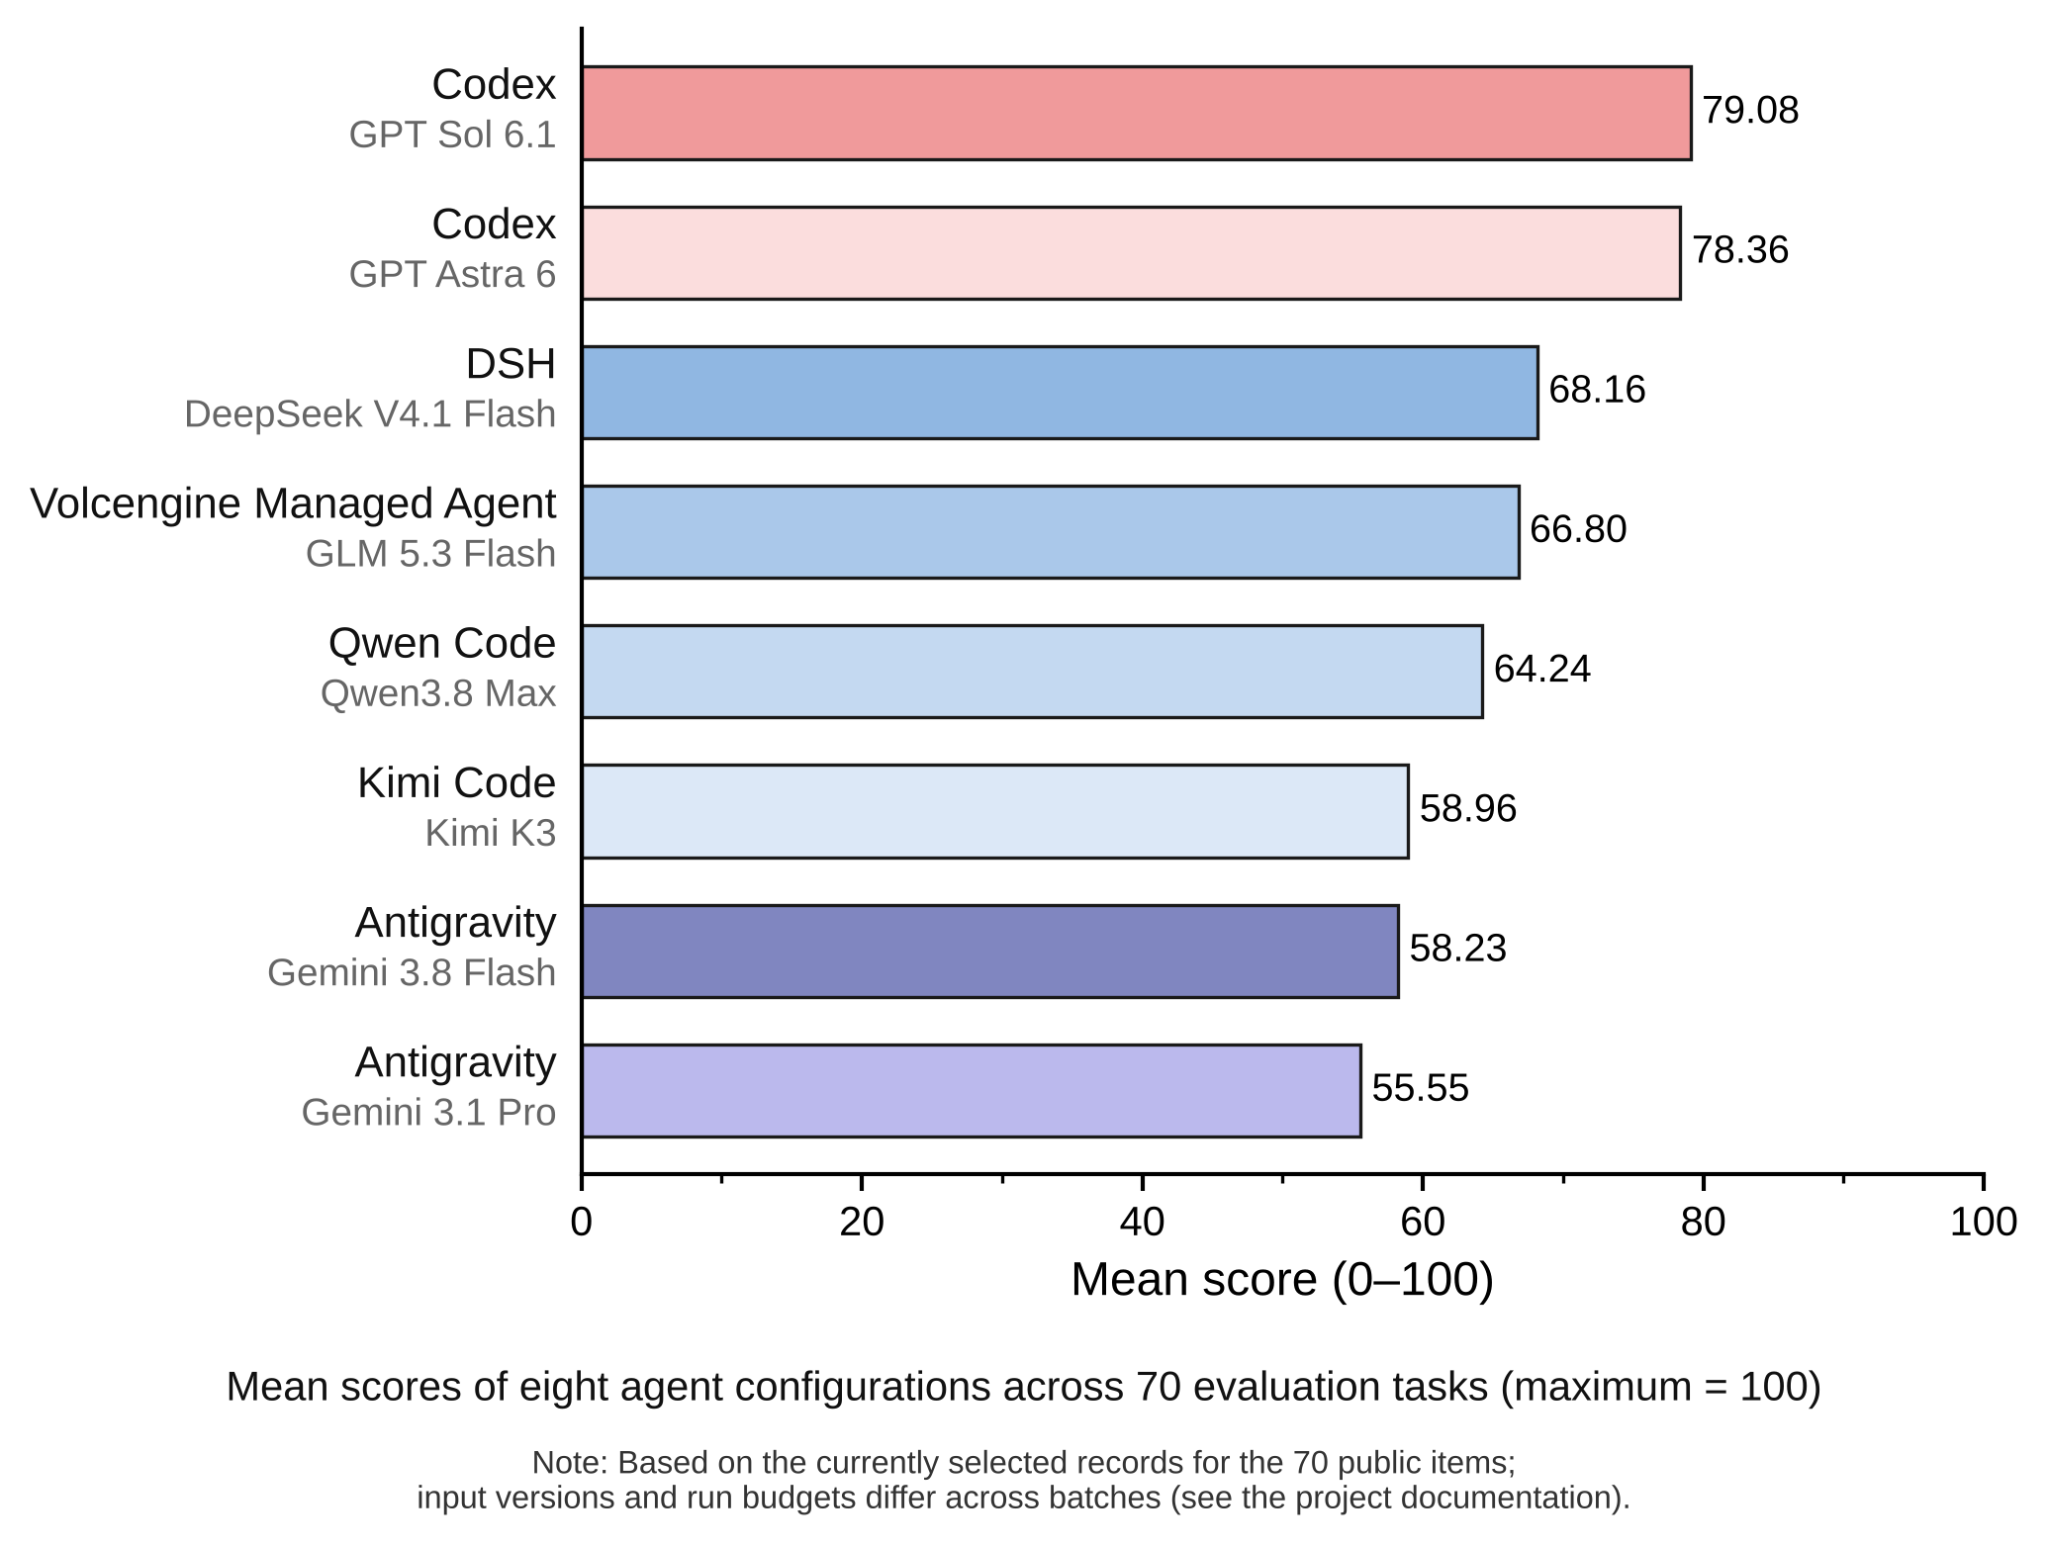
Kho mã cũng công bố hồ sơ đánh giá của tám cấu hình. Mọi cấu hình đều đã hoàn thành 70 nhiệm vụ hiện tại, dù dự án lưu ý rằng các lần chạy sử dụng những phiên bản đầu vào và ngân sách khác nhau, vì vậy không nên xem kết quả bảng xếp hạng là các thử nghiệm hoàn toàn đồng nhất.
Tìm hiểu Cấu trúc Đánh giá
Bộ nhiệm vụ được chia thành ba nhóm:
- 21 nhiệm vụ đề xuất: đánh giá mức độ các chương trình được đề xuất phù hợp với nền tảng và ràng buộc của sinh viên.
- 36 nhiệm vụ lập kế hoạch và ra quyết định: đánh giá kế hoạch chuẩn bị, phân tích rủi ro và tư vấn có thể thực hiện.
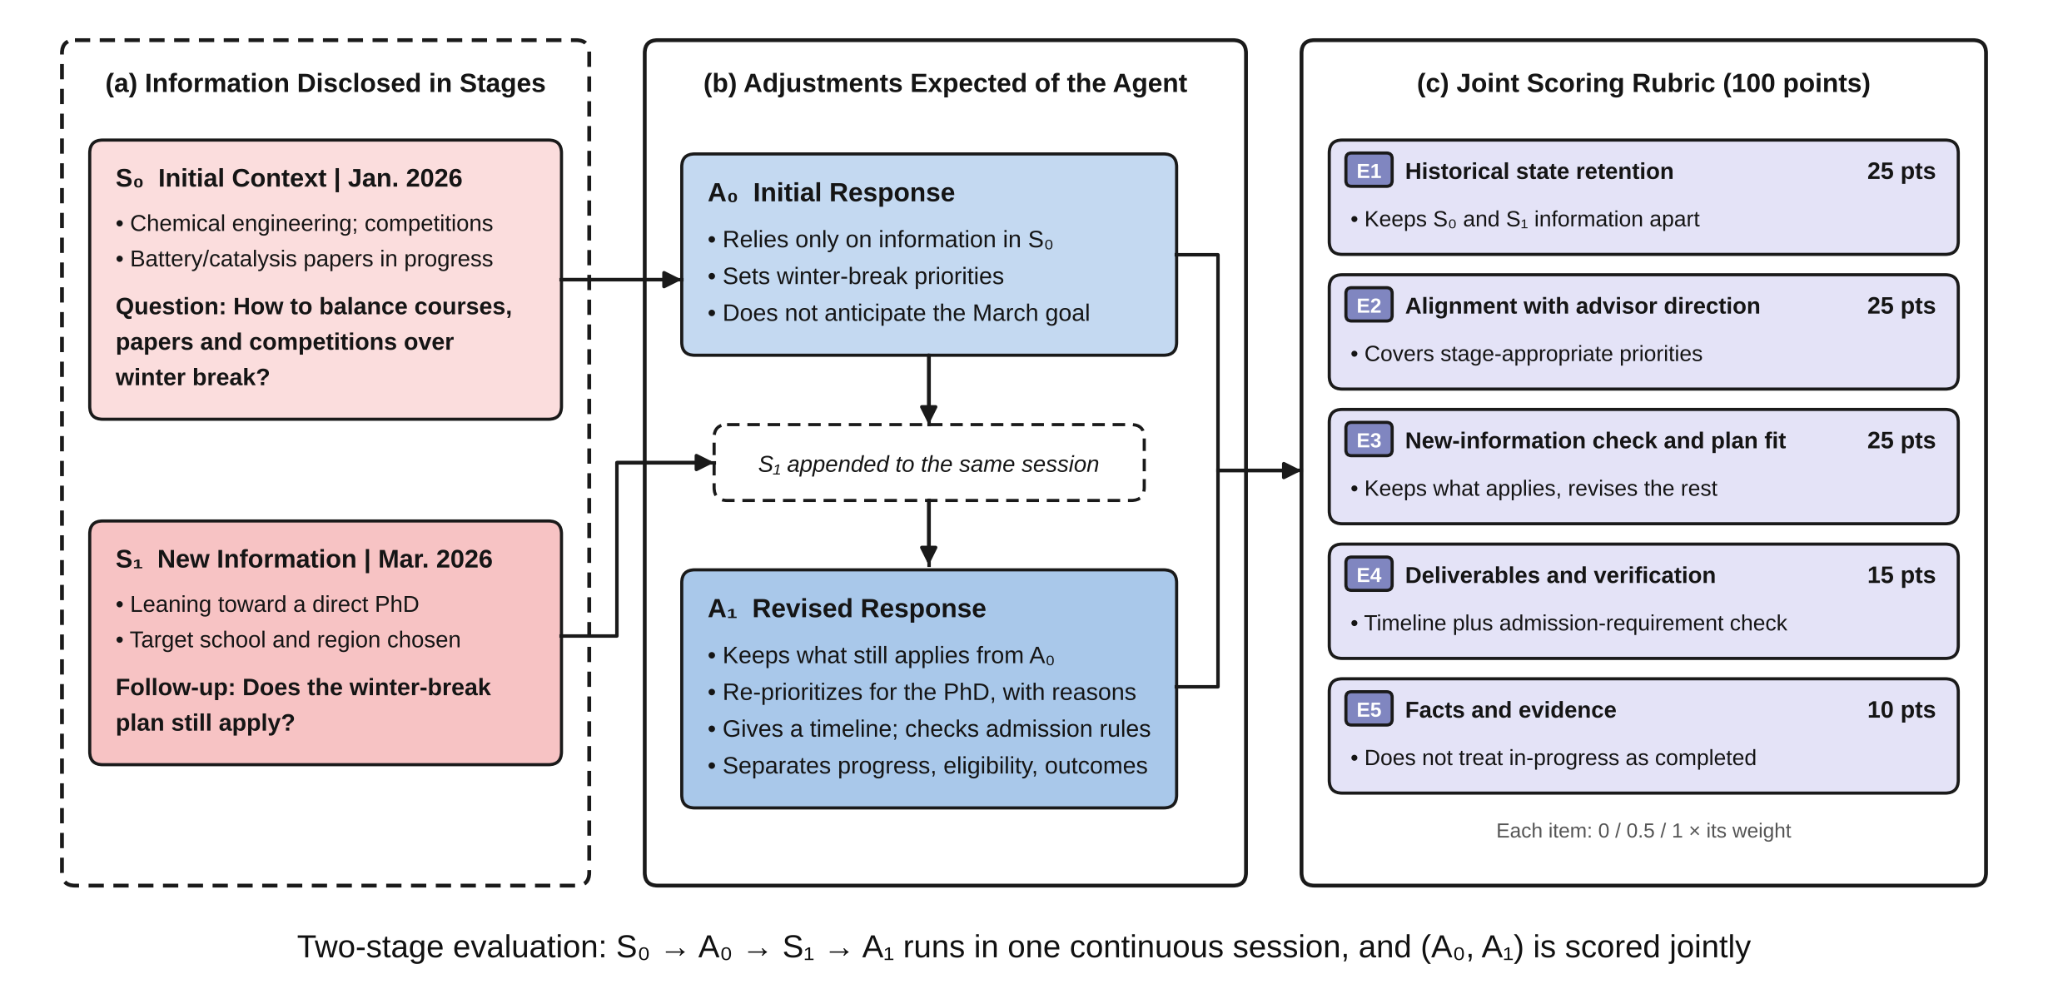
- 13 nhiệm vụ hai giai đoạn: cung cấp thông tin mới trong cùng một phiên và kiểm tra xem tác nhân có điều chỉnh lời khuyên trước đó hay không.
Mỗi nhiệm vụ có giá trị 100 điểm. Nhiệm vụ đề xuất phân bổ 70 điểm cho việc đối sánh với chương trình tham chiếu và 30 điểm cho chất lượng đề xuất. Một người đánh giá riêng sẽ chấm toàn bộ câu trả lời, trong khi các tiêu chí vẫn nằm ngoài quy trình trả lời.
Nhiệm vụ hai giai đoạn bắt đầu bằng bối cảnh ban đầu, gọi là S₀, sau đó cung cấp thông tin cập nhật, gọi là S₁. Tác nhân tạo câu trả lời ban đầu A₀ và câu trả lời đã sửa A₁ trong cùng một phiên. Cả hai câu trả lời được chấm điểm đồng thời. Ví dụ công khai O03-04 minh họa một tình huống từ tháng 1 đến tháng 3, trong đó sinh viên chuyển hướng sang nộp hồ sơ tiến sĩ trực tiếp.
Chuẩn bị Môi trường
Chạy lệnh từ thư mục gốc của kho mã. Việc thực thi native tự động yêu cầu macOS Seatbelt và Python 3.10 trở lên. Cấu hình đăng ký Kimi yêu cầu Python 3.11 trở lên.
Framework chỉ sử dụng thư viện chuẩn của Python, vì vậy kho mã không yêu cầu bước pip install. Tuy nhiên, bạn phải cài đặt ứng dụng khách chính thức cho cấu hình muốn chạy và chuẩn bị thông tin đăng nhập gói thuê bao hoặc khóa API.
Các ứng dụng khách hiện có gồm Codex, Claude Code, Antigravity, DeepSeek Harness, Qwen Code và Kimi Code. Cách xác thực khác nhau tùy ứng dụng khách: một số cấu hình sử dụng gói thuê bao hoặc OAuth, trong khi DeepSeek và Qwen sử dụng xác thực qua API như tài liệu dự án mô tả.
Chọn Cấu hình Tác nhân
ID tác nhân lấy từ registry hiện tại của kho mã tại config/agents-cli.example.json. Đây là các mã định danh cấu hình benchmark, không phải tham số mô hình trực tiếp.
gpt-6-astracho Codex với GPT Astra 6gpt-6-1-solcho Codex với GPT Sol 6.1claude-opus-5-5cho Claude Code với Claude Opusclaude-sonnet-5-5cho Claude Code với Claude Sonnetantigravity-gemini-3-8-flash-highcho Antigravity với Gemini Flashdeepseek-v4-1-flashcho DeepSeek Harness với DeepSeek Flashqwen3-8-max-0902cho Qwen Code với Qwen Maxkimi-k3cho Kimi Code với Kimi K3
Chạy Quy trình Bắt đầu Nhanh
Benchmark sử dụng cùng một quy trình cho mọi cấu hình. Trước tiên, gán ID tác nhân cho biến shell AGENT:
AGENT=gpt-6-1-solTiếp theo, lưu cấu hình cục bộ:
python3 -m benchmark setup --agent "$AGENT"
Kiểm tra xem ứng dụng khách và xác thực đã sẵn sàng hay chưa:
python3 -m benchmark cli-check --agent "$AGENT"Khi kết quả kiểm tra trả về ready_for_trial, hãy chạy một lô bằng lựa chọn nhiệm vụ hiện tại:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT"
Theo mặc định, thực thi theo lô sẽ xem trước 70 nhiệm vụ và 83 giai đoạn mà không gọi mô hình. Thêm --execute khi bạn sẵn sàng sử dụng hạn mức tài khoản:
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent "$AGENT" --out "./runs/current-$AGENT" \
  --execute
Hãy bắt đầu bằng một nhiệm vụ thử nghiệm sau khi cli-check thành công. Việc này giúp xác nhận ứng dụng khách, chế độ xác thực, sandbox và vị trí đầu ra hoạt động chính xác trước khi khởi chạy toàn bộ lô.
Chạy Nhiều Cấu hình
Cấu hình và kiểm tra từng ứng dụng khách riêng biệt, sau đó truyền nhiều tùy chọn --agent cho một lệnh theo lô. Sử dụng một thư mục đầu ra mới để kết quả từ các cấu hình khác nhau không ghi đè lên nhau.
python3 -m benchmark cli-batch \
  --selection config/selections/current.json \
  --agent gpt-6-1-sol \
  --agent claude-opus-5-5 \
  --out "./runs/comparison" \
  --execute
Giữ chế độ xác thực của mỗi cấu hình nhất quán với ứng dụng khách được liệt kê trong registry. Cấu hình dựa trên gói đăng ký nên sử dụng phương thức đăng nhập gói đăng ký được hỗ trợ, còn cấu hình API nên sử dụng thông tin xác thực API bắt buộc.
Kiểm tra tác vụ và kết quả
Chỉ mục tác vụ có tại config/selections/current.json. Để xem các câu hỏi, tiêu chí và định nghĩa chấm điểm, hãy tham khảo Questions and scoring, the data format guide và the scoring rules.
Kết quả đã công bố có sẵn dưới nhiều dạng:
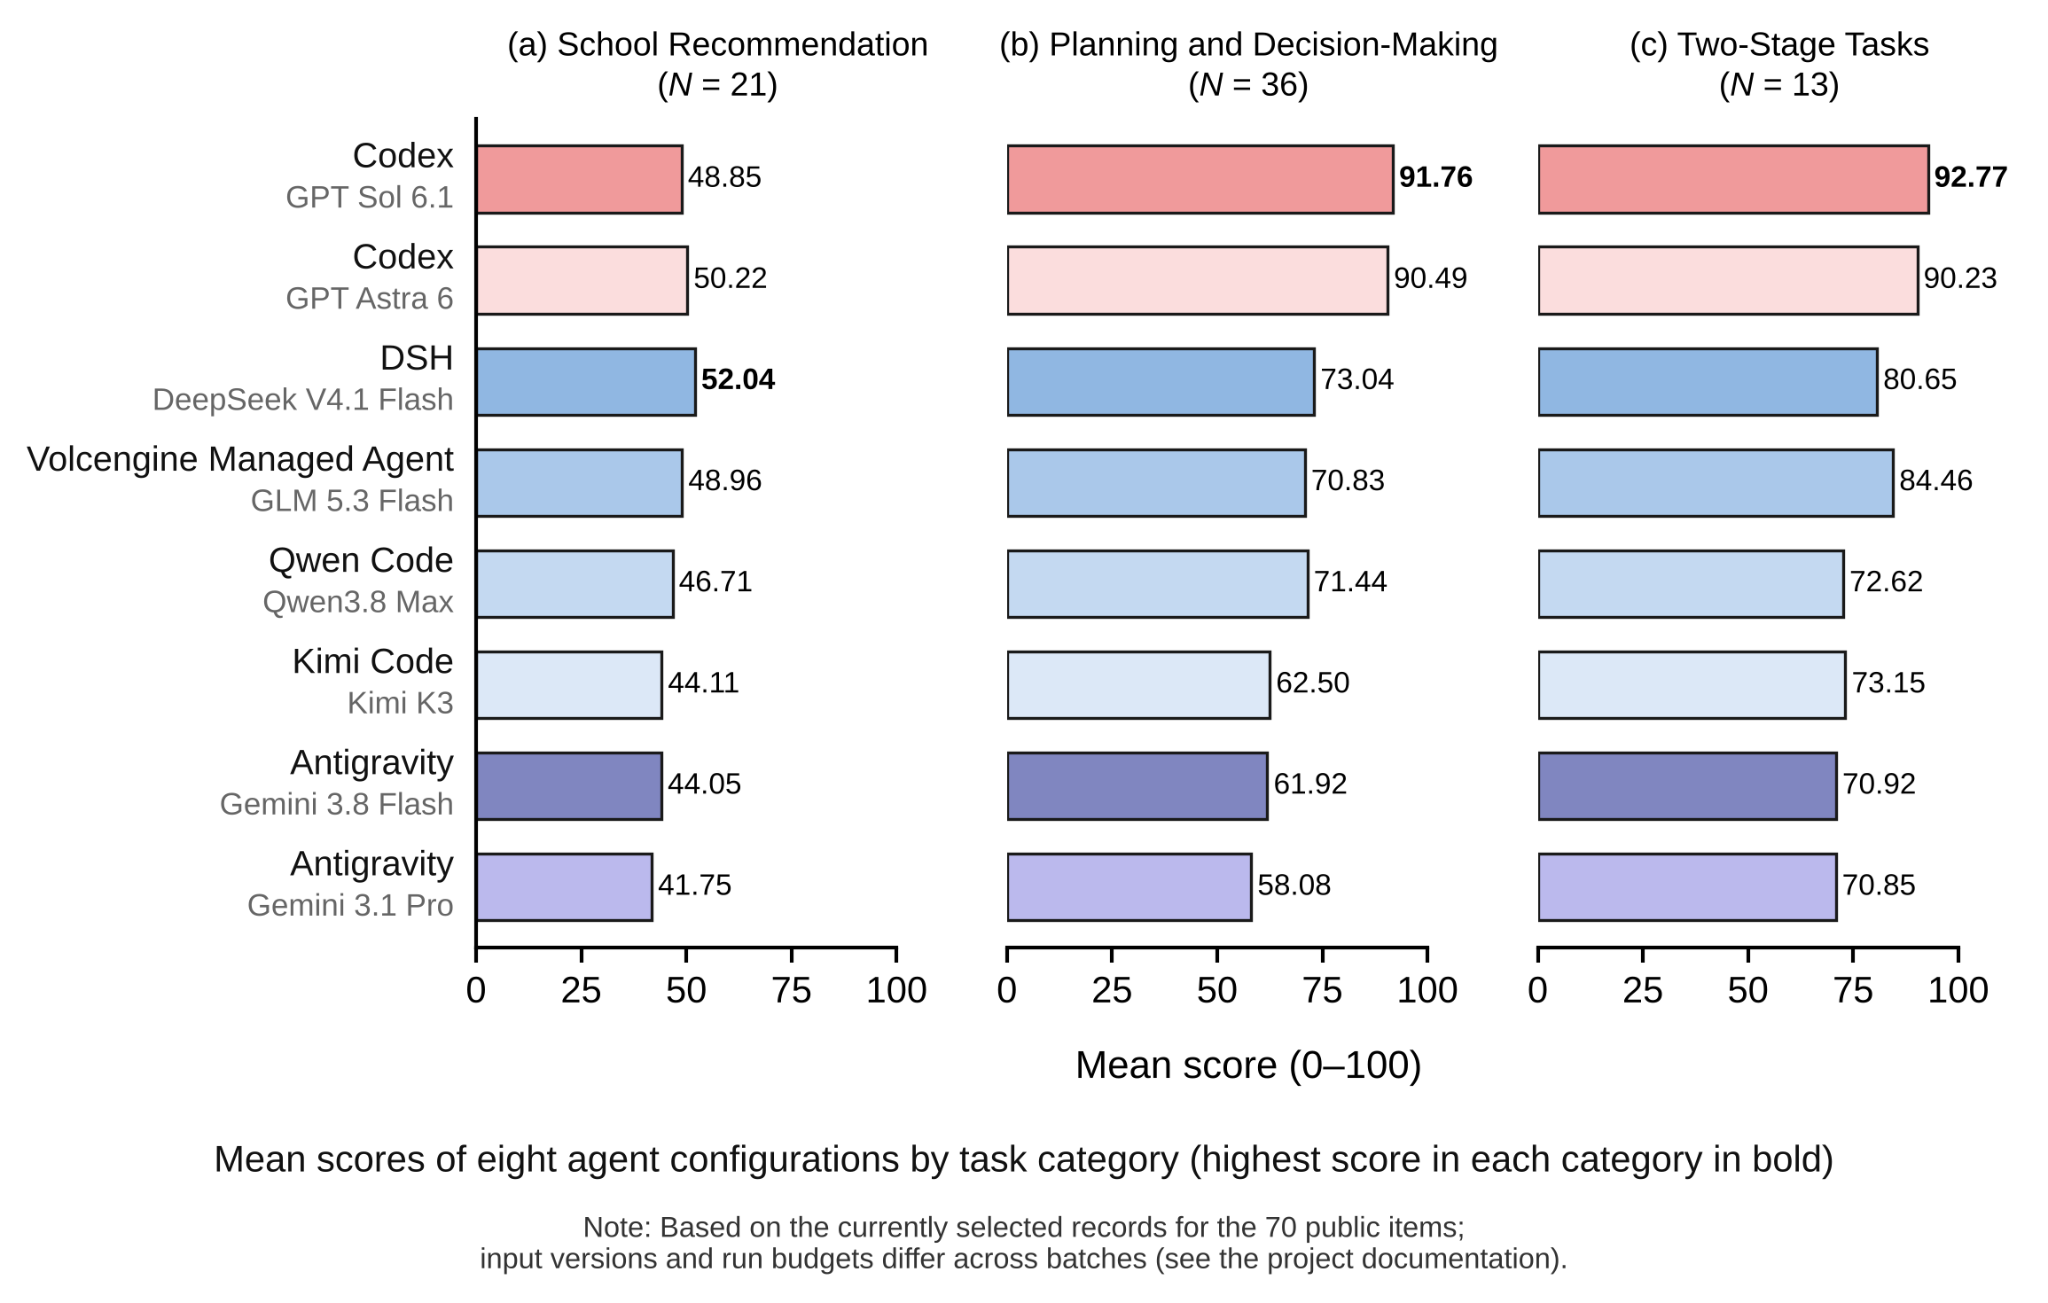
- Tóm tắt điểm cho kết quả tổng hợp.
- Kết quả theo từng tác vụ cho các bản ghi chi tiết ở cấp tác vụ.
- Câu trả lời và điểm số theo cấu hình cho nội dung câu trả lời công khai và thông tin đánh giá.
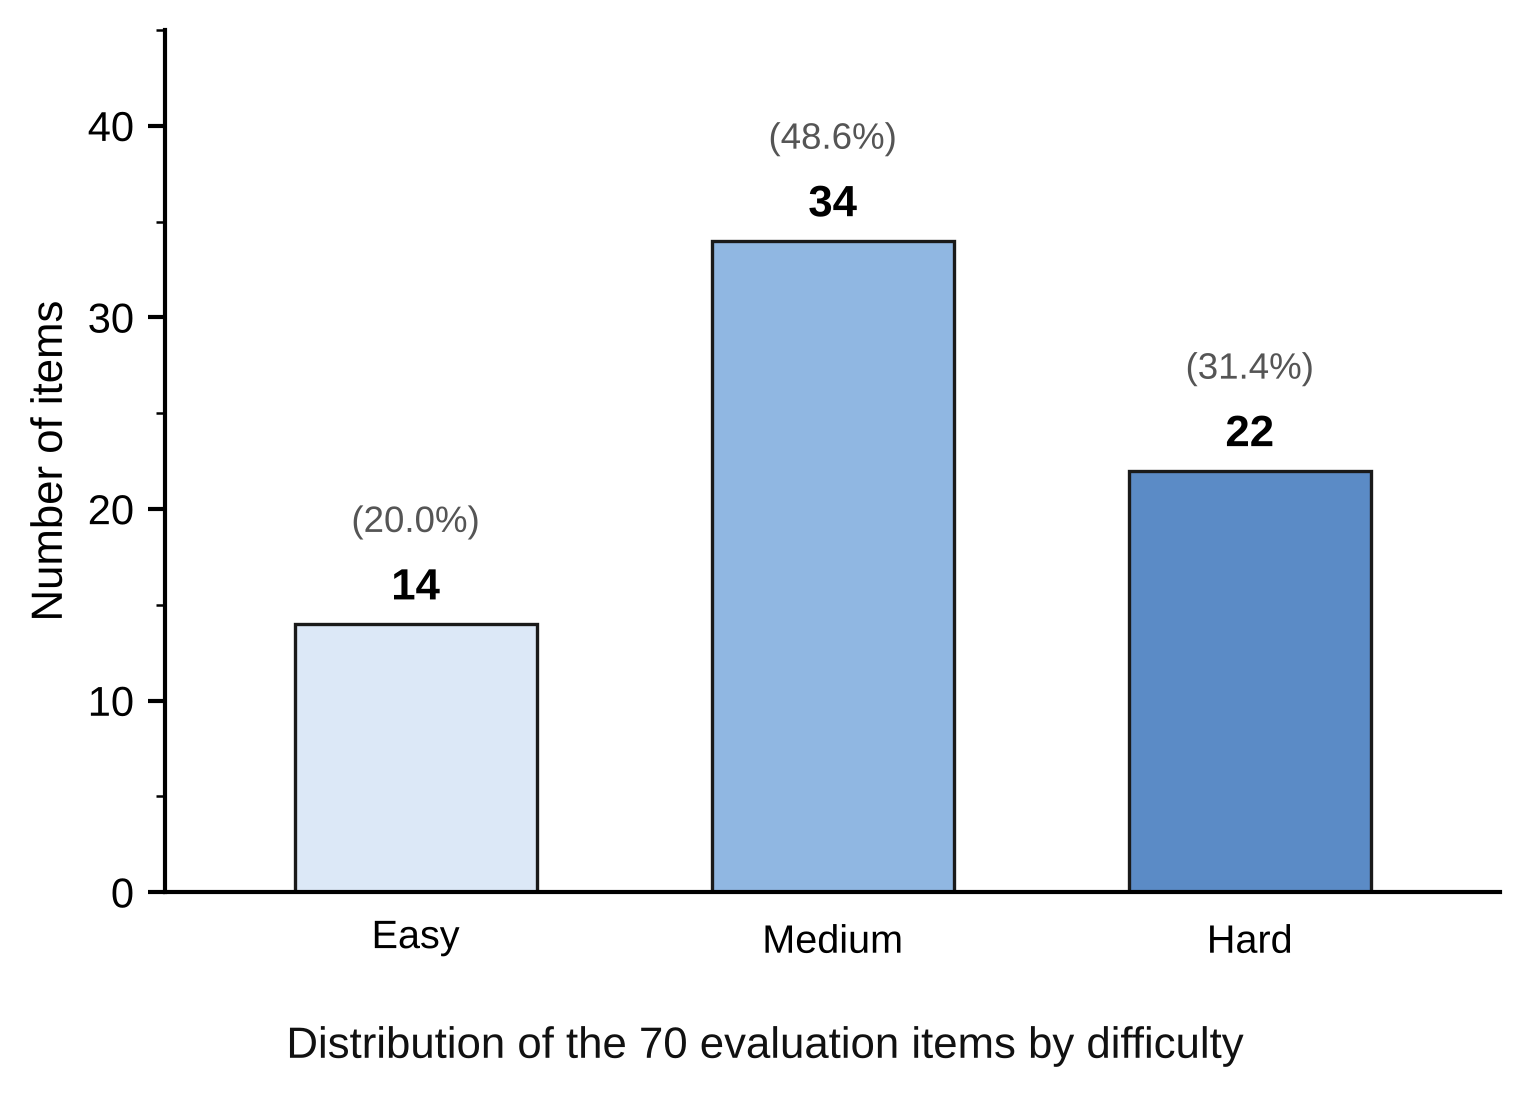
Bảng xếp hạng đã công bố báo cáo điểm trung bình và tỷ lệ hoàn thành của tám cấu hình được đánh giá. Kho lưu trữ cũng ghi lại nhãn độ khó cho các tác vụ hiện tại: 14 dễ, 34 trung bình và 22 khó. Các nhãn này được chủ sở hữu xác nhận thông qua hiệu chuẩn với giáo viên và không được trình bày như một vòng đánh giá kép độc lập.
Mẹo chấm điểm và đánh giá
Việc chấm điểm có thể sử dụng một phiên đăng ký Codex riêng để xem xét các tài liệu đã xuất. Việc chấm điểm tùy chọn bằng API cần cấu hình bổ sung. Giữ quy trình trả lời tách biệt khỏi tài liệu chấm điểm, vì việc cung cấp rubric hoặc chương trình tham chiếu cho tác nhân được đánh giá có thể làm mất hiệu lực phép so sánh.
Khi so sánh các lần chạy của riêng bạn, hãy ghi lại ID tác nhân, phiên bản ứng dụng khách, phiên bản đầu vào, ngân sách thực thi, thư mục đầu ra và mọi mã băm nội dung liên quan. Dự án cảnh báo rằng các lần chạy trên bảng xếp hạng công khai không phải lúc nào cũng có điều kiện thực thi giống hệt nhau, vì vậy hãy so sánh kết quả cùng với phương pháp luận và bản ghi lần chạy tương ứng.
Để thực hiện các thí nghiệm có thể tái lập, hãy làm theo hướng dẫn tái lập, trong đó đề cập đến đầu vào cố định, bài nộp và xác minh điểm số. Tài liệu phương pháp luận giải thích các thiết lập và giới hạn của việc đánh giá, còn hướng dẫn CLI gốc cung cấp thêm chi tiết về cài đặt, xác thực và nhiều giai đoạn.
Kết luận
Graduate Admissions Agent Benchmark cung cấp một cách có cấu trúc để kiểm tra liệu các tác nhân tuyển sinh có đưa ra khuyến nghị chính xác, tư vấn lập kế hoạch hữu ích và cập nhật phù hợp khi hoàn cảnh của sinh viên thay đổi hay không. Thiết lập ứng dụng khách được hỗ trợ, chọn ID tác nhân từ registry, xác minh bằng cli-check, xem trước lô, rồi thực hiện các thử nghiệm hoặc đánh giá đầy đủ. Sử dụng các định nghĩa tác vụ, kết quả và tài liệu phương pháp luận đã công bố để diễn giải điểm số một cách có trách nhiệm và tái lập các phép so sánh.