

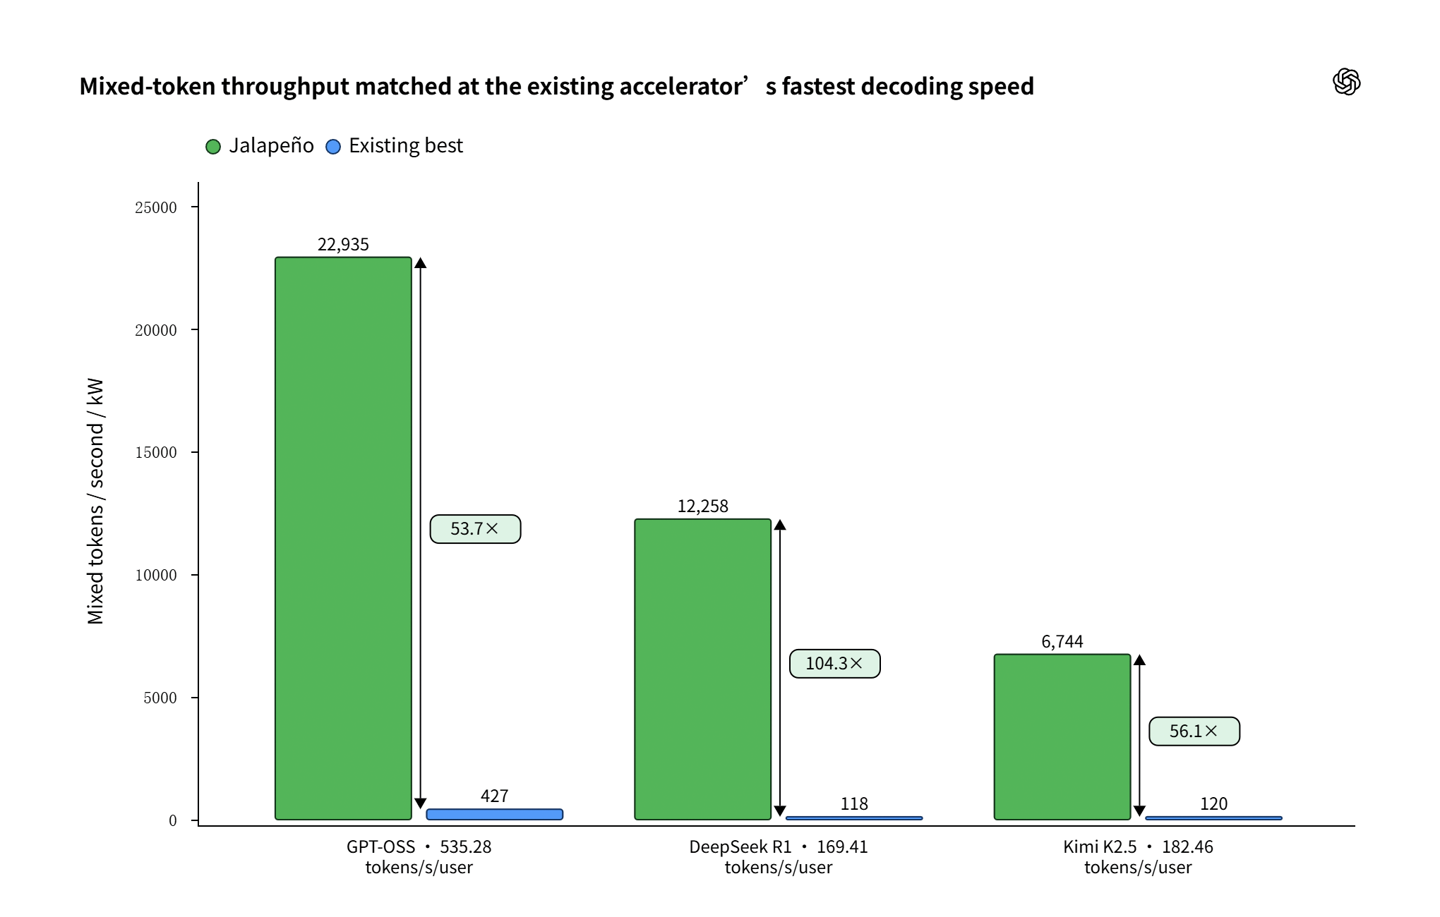
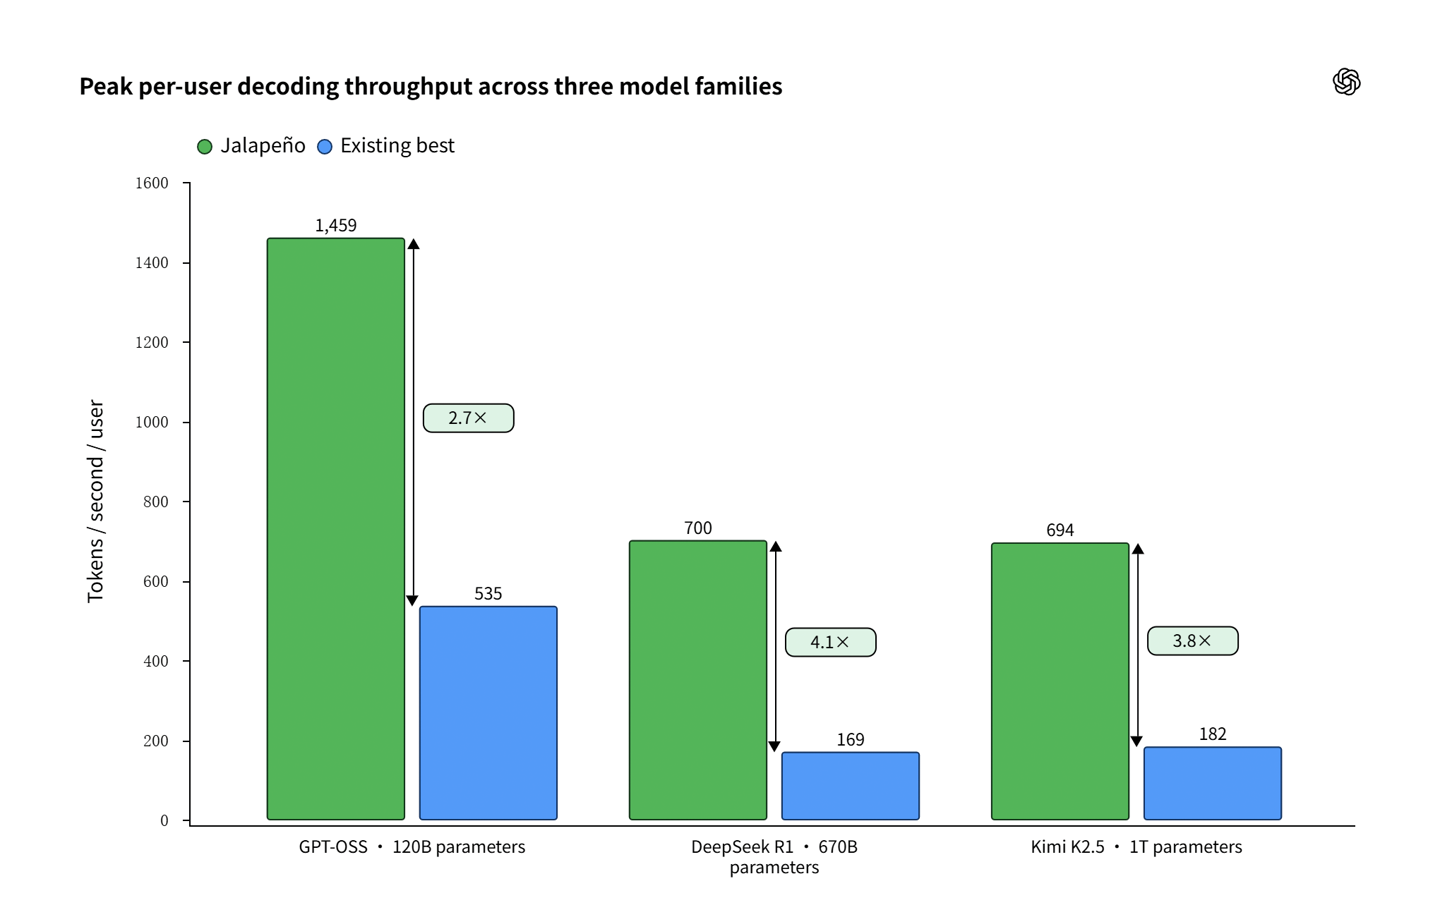
Izolo, mhla ka-25 Agasti, i-OpenAI yashicilela ibhulogi ekhombisa i-chip yayo yokuqala eyazakhela yona, i-Jalapeño, yathi kokubili inani lama-token acutshungulwa ngumsebenzisi oyedwa kanye nomthamo nge-kilowatt ngayinye kudlula owamaphrosesa aphambili okwenza inference atholakala emakethe njengamanje.
Ebhulogini yayo esemthethweni, i-OpenAI yasebenzisa ithuluzi lokuhlola elivulekile i-InferenceX, elakhiwe yinkampani yocwaningo lwama-semiconductor i-SemiAnalysis, ukuhlola amamodeli amathathu: i-GPT-OSS 120B, i-DeepSeek R1 670B kanye ne-Kimi K2.5 1T.
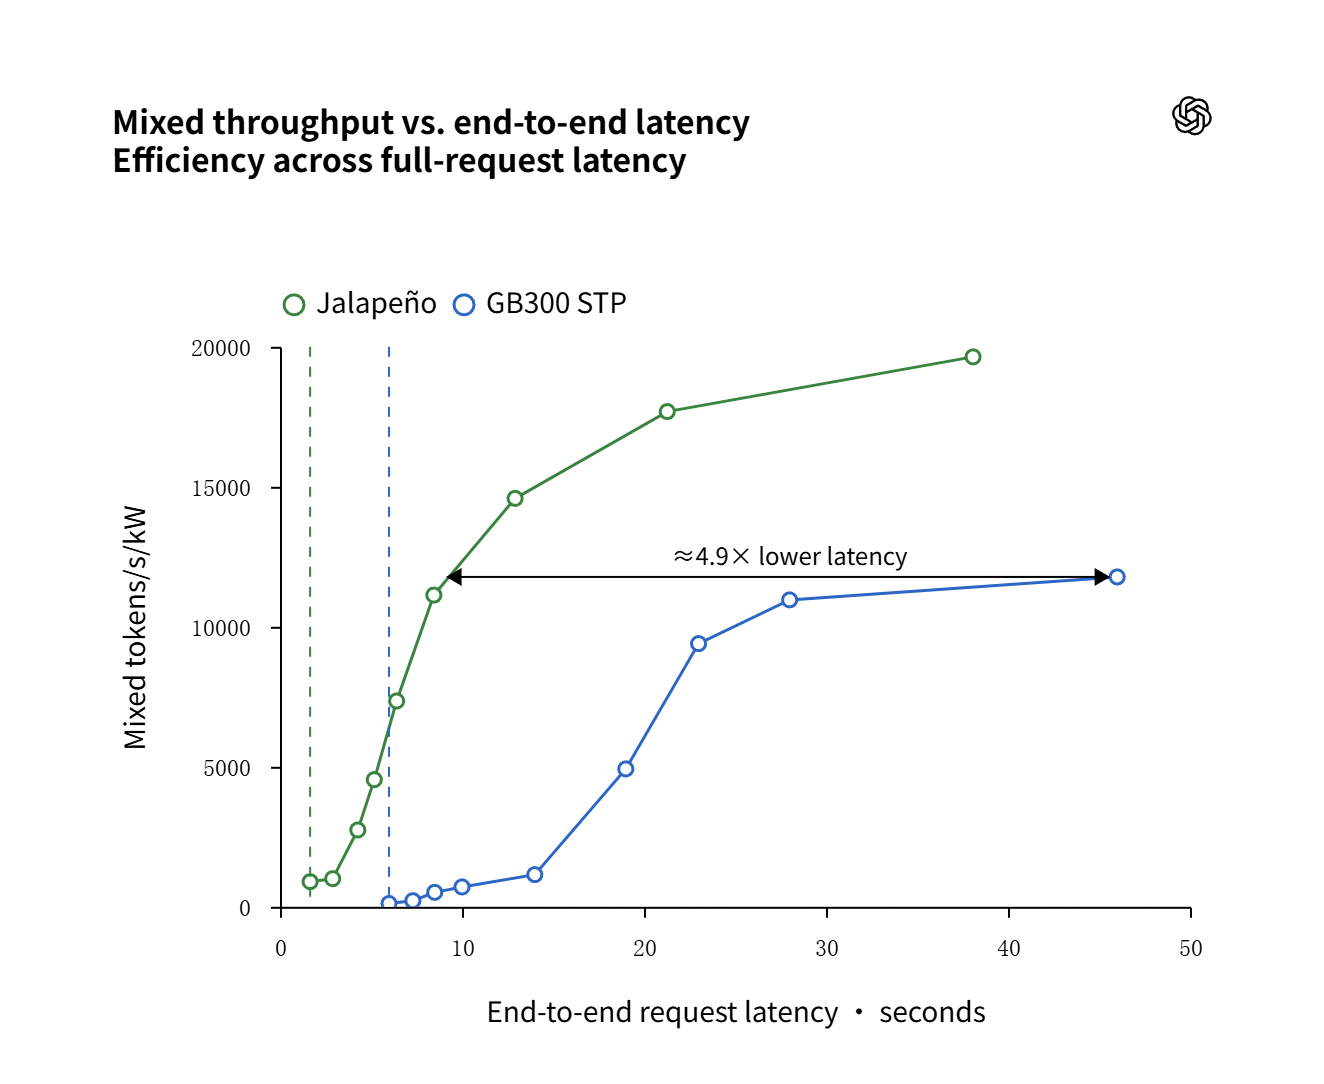
Ukuhlola kubonisa ukuthi uma iqhathaniswa nezinhlelo ze-AI ezihamba phambili emakethe, i-GB200 ne-GB300, i-Jalapeño ingenza umthamo we-AI nge-watt ngayinye ophindwe ngo-1.5 kuya ku-1.9 kunowezinhlelo eziqhathaniswayo, kanti ukubambezeleka kusukela ekuqaleni kuya ekugcineni kungaba cishe u-28% kuya ku-59% kuphela kwalokho kwezinhlelo eziqhathaniswayo.
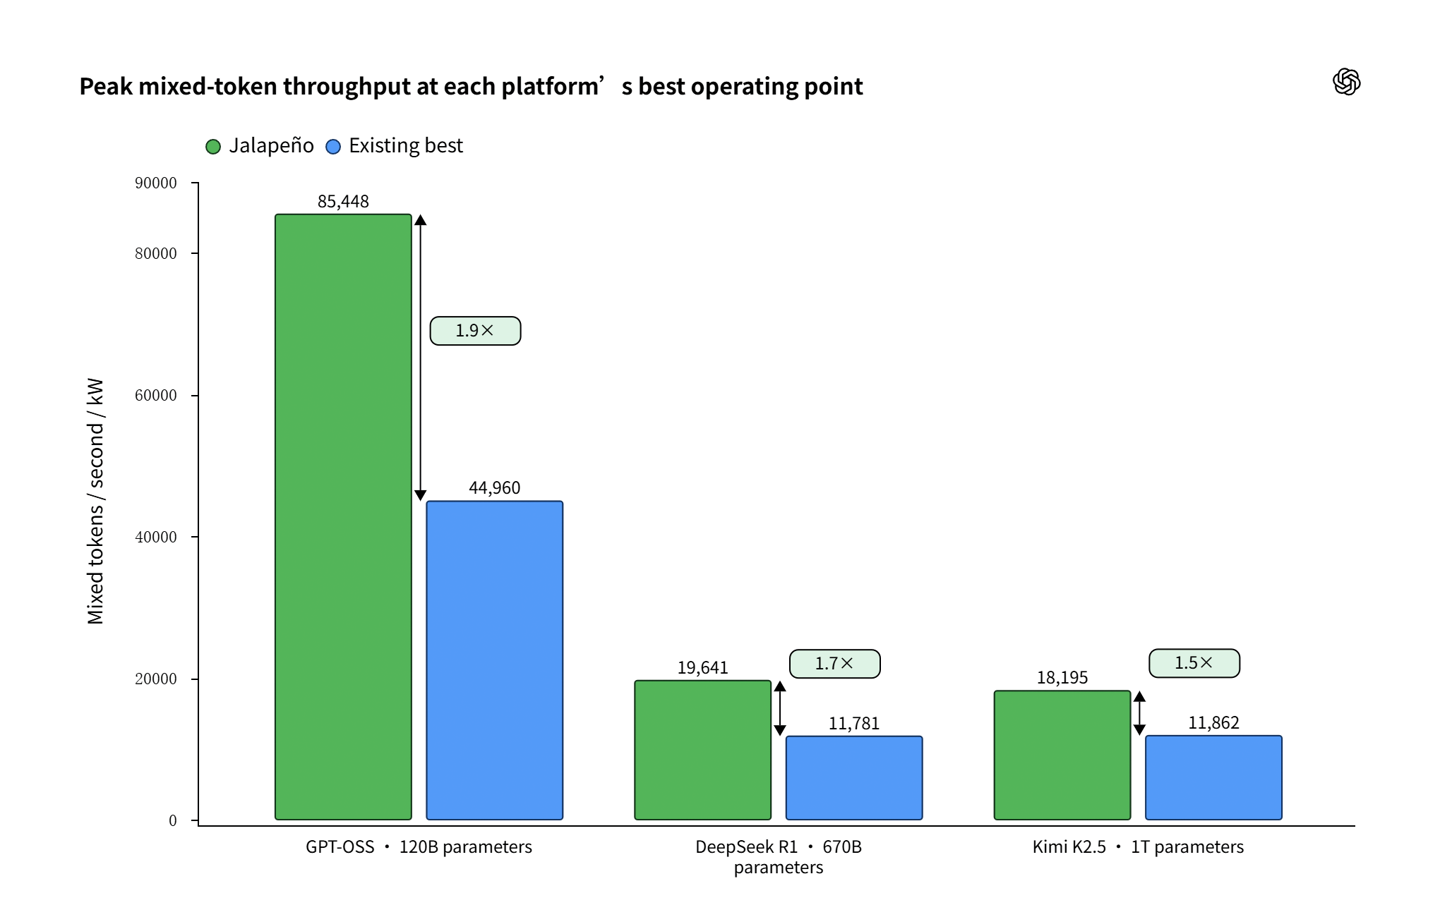
I-OpenAI ithe lapho isebenzisa i-GPT-OSS 120B, umthamo omkhulu we-Jalapeño nge-kilowatt ngayinye uphakeme cishe ngo-1.9 kunowohlelo lwe-GB200.
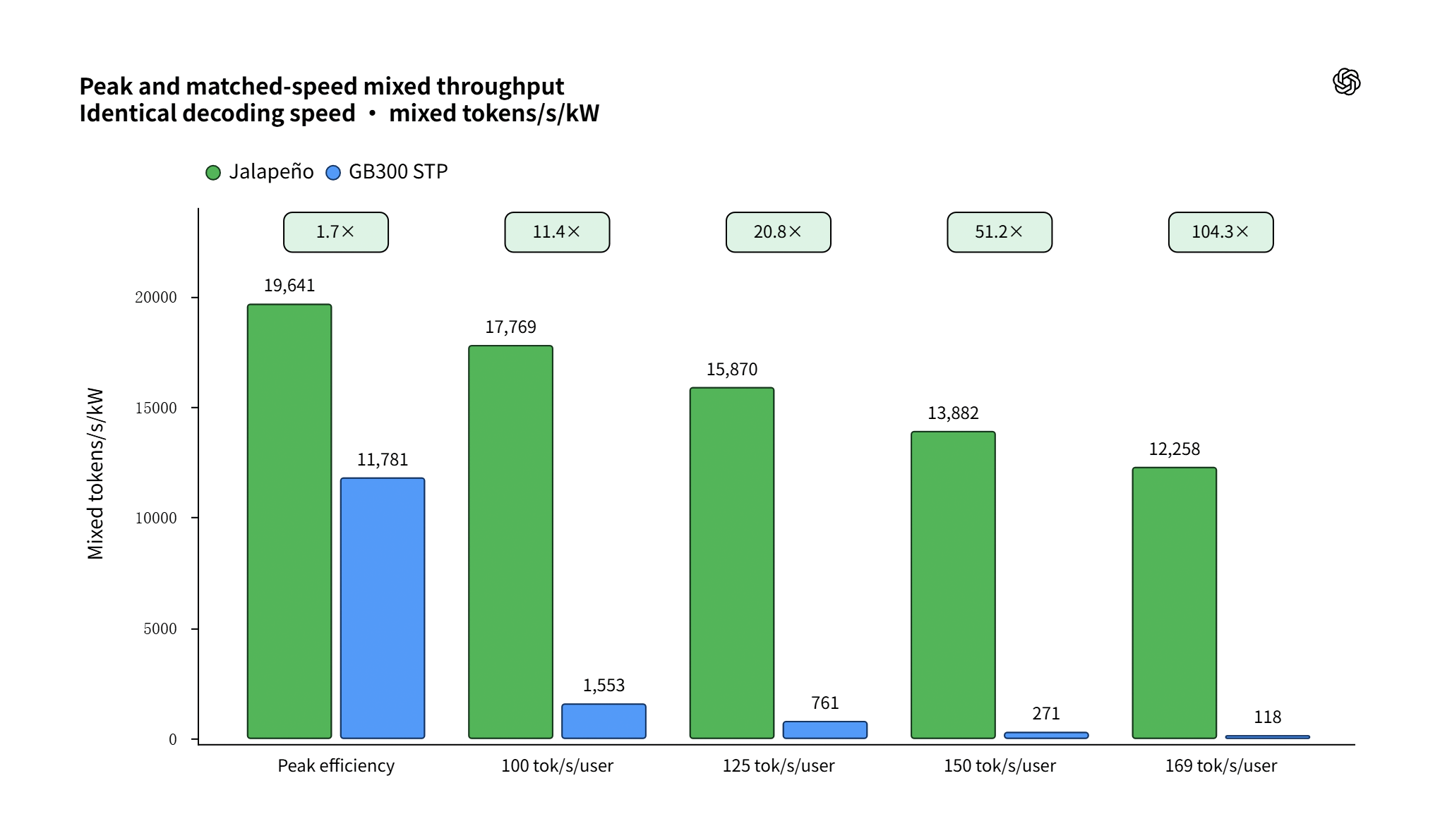
Ku-DeepSeek R1, ukusebenza kwayo nge-watt ngayinye kuphakeme cishe ngo-1.7 kunowe-GB300; ku-Kimi K2.5, ukusebenza kwayo nge-watt ngayinye kuphakeme cishe ngo-1.5 kunowe-GB300. Amandla alinganisiwe e-Jalapeño angama-700 watts, kodwa ngesikhathi somthwalo wokuhlola ukusetshenziswa kwayo okuqhubekayo kwamandla kwahlala kungu-550 watts noma ngaphansi. Izithombe ezihlobene ziboniswe ngezansi:
I-Jalapeño iyi-chip yokuqala ye-AI inference eyazakhelwa yona yi-OpenAI, eyathuthukiswa ngokubambisana phakathi kwe-OpenAI ne-Broadcom, yakhiqizwa yi-TSMC kusetshenziswa inqubo ye-3nm, futhi yaboniswa okokuqala emphakathini mhla ka-24 Juni 2026. Le chip iyi-ASIC (isifunda esididiyelwe esikhethekile), isebenzisa i-systolic array architecture, futhi ifakwe inkumbulo ye-HBM enomkhawulokudlulisela ophezulu. Yakhelwe ngokukhethekile ukwenza inference yamamodeli amakhulu olimi, futhi ayisetshenziselwa ukuqeqesha amamodeli. I-chip kanye nohlelo lwamaseva oluhambisana nayo ngeke kuthengiswe emphakathini; kuzosetshenziswa ngaphakathi kwa-OpenAI kuphela, ngenhloso yokwehlisa izindleko zokuthenga ama-GPU nokusebenzisa amandla ekhompyutha. URichard Ho, ophethe ihardware kwa-OpenAI, wahola ukuthuthukiswa kwale chip. Phambilini wasebenza kwa-Google cishe iminyaka eyisishiyagalolunye futhi wayengomunye wonjiniyela ababalulekile bephrojekthi ye-Cloud TPU. Kusukela ekwakhiweni kwe-architecture kuya ekuqedweni kokukhiqizwa kwe-wafer, i-Jalapeño yathatha cishe izinyanga ezingu-9 kuphela. I-OpenAI ithi lokhu kungesinye sezikhathi zokuthuthukiswa kwe-ASIC esheshayo emlandweni emkhakheni wama-semiconductor athuthukile asebenza kahle kakhulu. Amamodeli e-AI akwa-OpenAI nawo abambe iqhaza elijulile enqubweni yokuklama le chip, esiza ukusheshisa ukuthuthukiswa nokwenza ngcono ukwakhiwa. Njengamanje, i-chip yesizukulwane sesibili ye-Jalapeño isisesigabeni sokugcina sokuthuthukiswa, futhi kulindeleke ukuthi kuqedwe ukukhiqizwa kwe-wafer ezinyangeni ezizayo; i-chip yesizukulwane sesithathu nayo isiqalile ukwakhiwa komqondo. I-OpenAI ihlela ukuqala ukusebenzisa i-Jalapeño ngezinga elincane ngaphambi kokuphela kuka-2026, bese ikhulisa kancane kancane izinga lokusetshenziswa ngo-2027. Kumele kuqashelwe ukuthi izinto eziqhathaniswe ne-Jalapeño kulokhu kuhlola yizinhlelo ze-NVIDIA GB200 ne-GB300; ayikahlolwa uma iqhathaniswa ne-chip yakamuva yesizukulwane se-NVIDIA, i-Vera Rubin. I-OpenAI ithe i-NVIDIA isengumlingani wayo obalulekile, futhi esikhathini esizayo izoqhubeka nesu labahlinzeki abaningi ukuze ihlangabezane nesidingo sayo esikhulu samandla ekhompyutha.