

Ithimba le-Alibaba Tongyi Qianwen limemezele ngokusemthethweni i-Qwen3.8-Flash kusihlwa. Ithimba le-Tongyi liphinde lakhulula izisindo zomthombo ovulekile ze-Qwen3.8-Flash-Next; isakhiwo esisha se-Next sizoba yisisekelo sochungechunge olusha ngokuphelele lwamamodeli e-Qwen4.
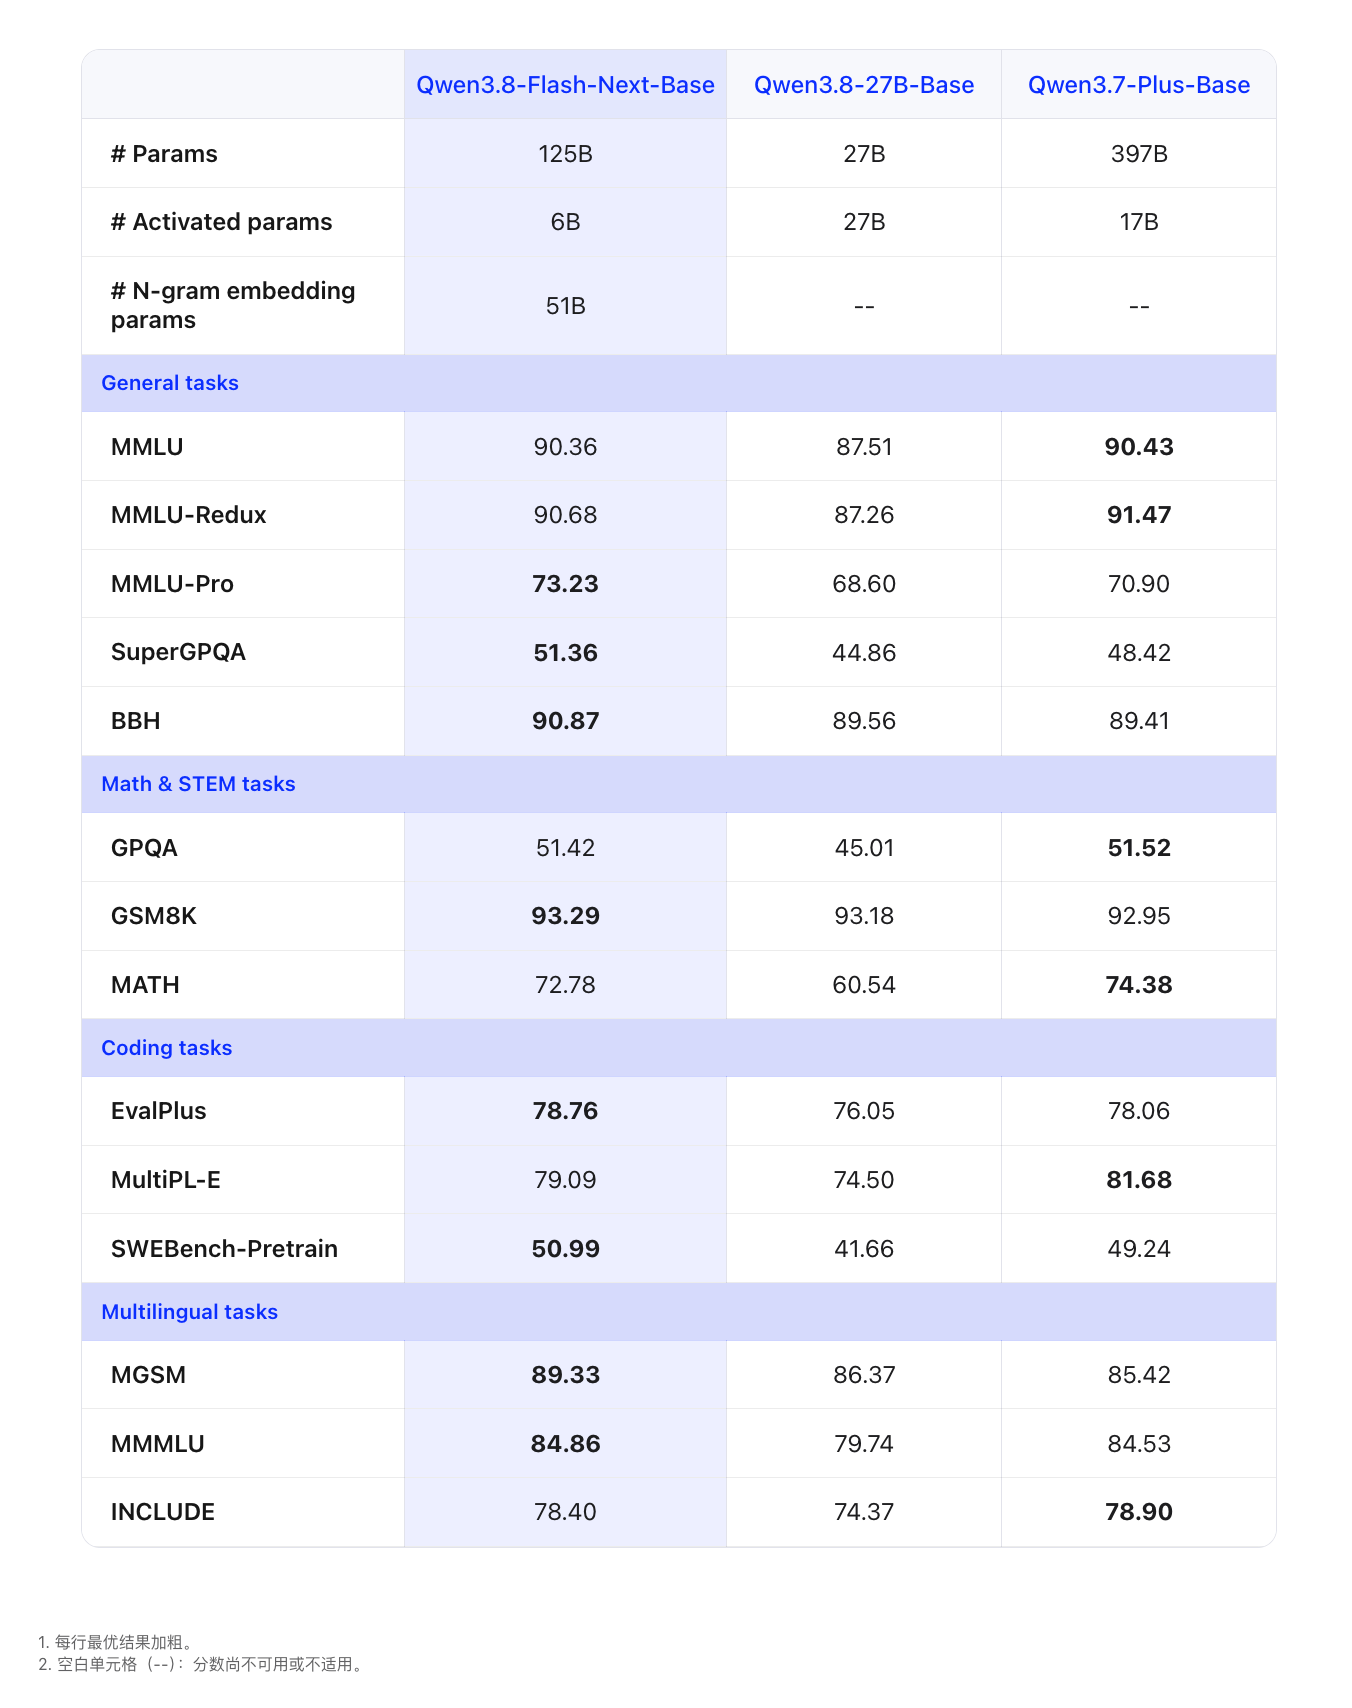
Lena imodeli ye-MoE exhasa izindlela eziningi, enamapharamitha angu-125B kumodeli eyinhloko, kanye namanye amapharamitha angu-51B e-N-gram Embedding; amathokheni asebenzisa amapharamitha angu-6B. Isekela ngokwemvelo umongo wamathokheni angu-262,144, futhi inganwetshwa ibe ngamathokheni angu-1M kusetshenziswa i-YaRN.
Ngokwethulwa, i-Qwen3.8-Flash yenze ukuthuthukiswa okuhlelekile ezindaweni ezine:
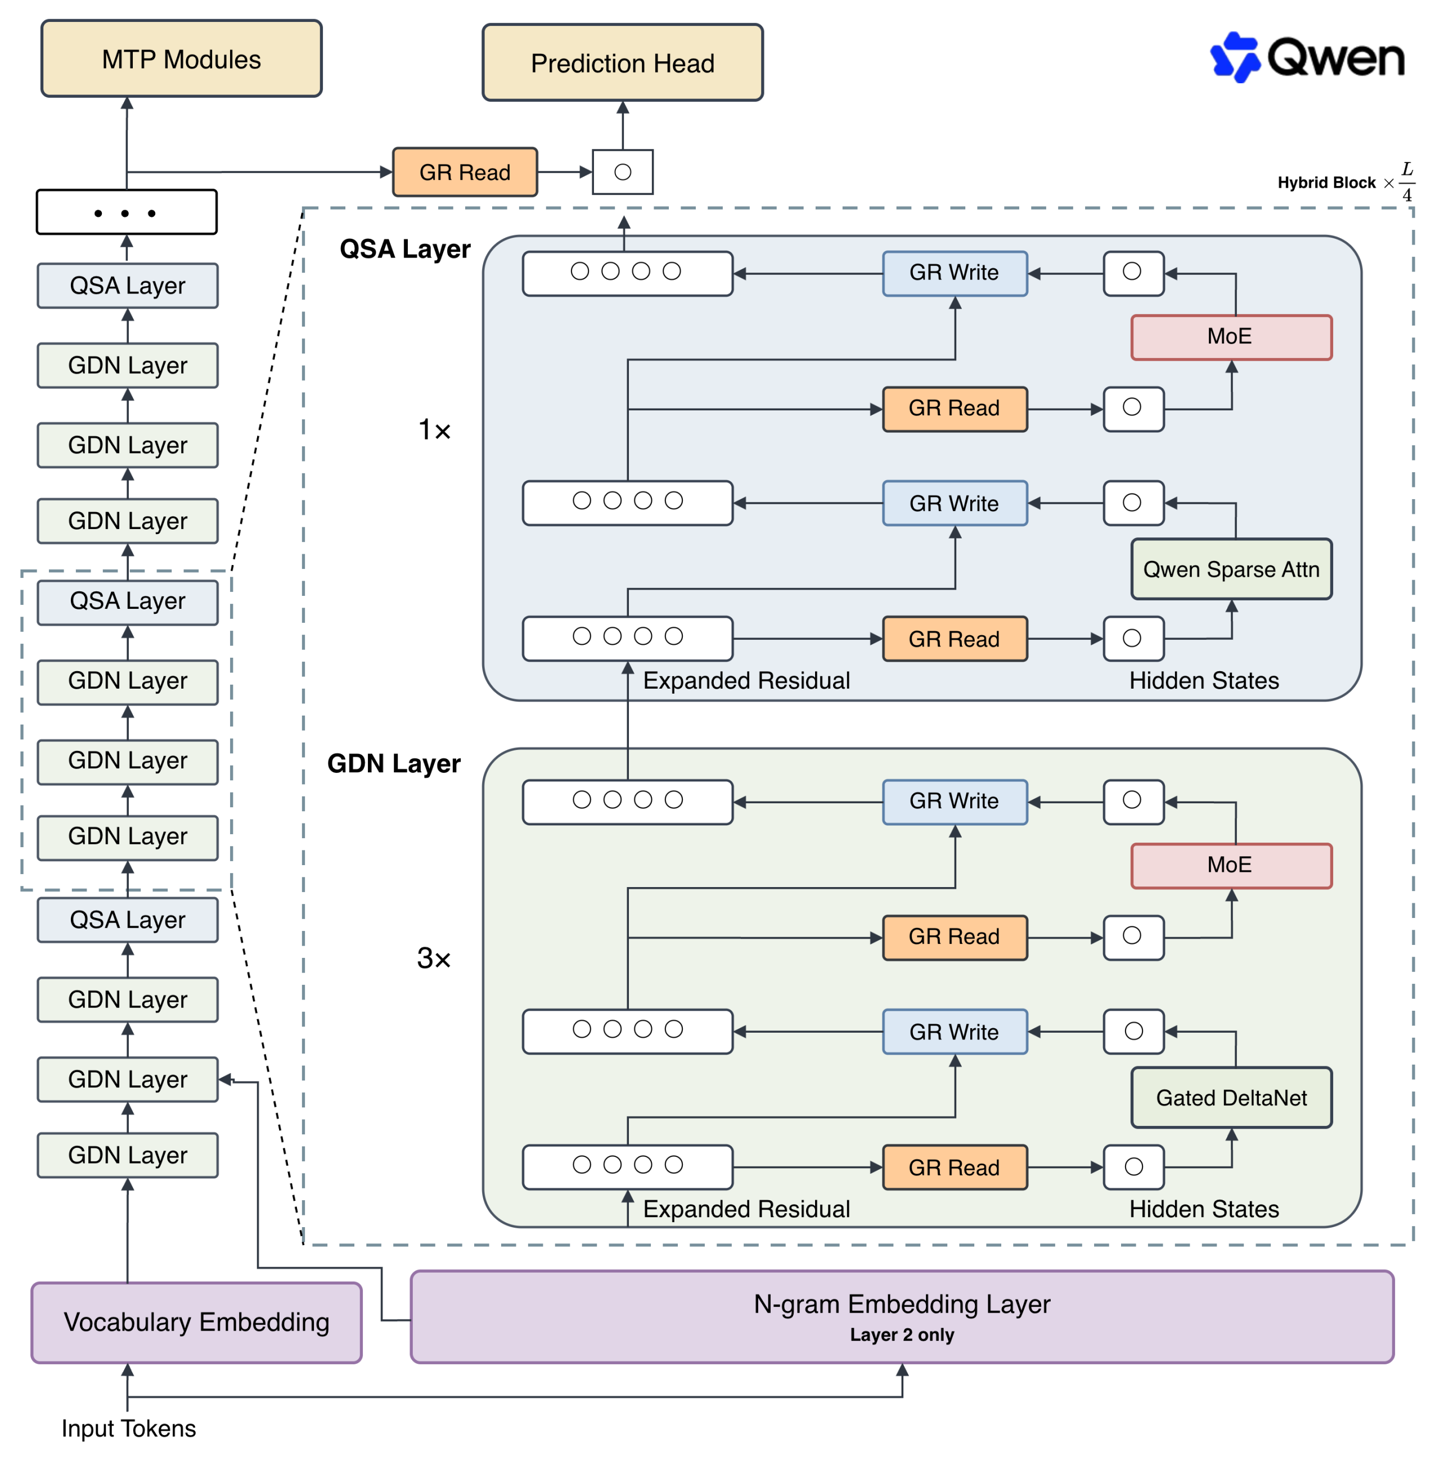
Endabeni ye-Attention, kusetshenziswa isakhiwo esixubile se-GDN (Gated DeltaNet) + QSA (Qwen Sparse Attention). I-GDN icindezela kahle ulwazi lomlando, kanti i-QSA isebenzisa i-Indexer elula ukukhetha umongo obalulekile ezingeni le-micro-block, inciphise kakhulu izindleko ze-Attention ezilandelaneni ezinde. Lapho ibhekene nomongo omude ngokwedlulele wamathokheni angu-1M, i-Attention Kernel ye-QSA ithola ukusheshiswa okuphezulu okuphindwe izikhathi ezingu-7.6 esigabeni se-Prefill nezingu-4.9 esigabeni se-Decode.
Endabeni ye-Residual, kwethulwa indlela ye-Gated Residual (GR), eyandisa ukugeleza kwe-residual kube amagatsha angu-4 asebenza ngokufana, ilawule ukufundwa nokubhalwa kolwazi nge-Gate eguqukayo. Isimo se-residual sisekela ukugcinwa kwe-FP8, kwehlise kakhulu izindleko zokufinyelela kwimemori.
Endabeni ye-Embedding, kwethulwa i-N-gram Embedding enamapharamitha angu-51B, esebenzisa ukubheka umongo wendawo etafuleni ukuze kwandiswe umthamo wemodeli. Lawa mapharamitha angadluliselwa ku-Host Memory, bese i-asynchronous Prefetch idlulela kanye nokubalwa kwemodeli, ngaphandle kokuhlala ithatha inkumbulo ye-GPU.
Endabeni ye-Optimization, kusetshenziswa i-Muon Optimizer, kwenziwa nokuthuthukiswa kwamasu ahlanganisa ukunemba kwe-orthogonalization, ukwabiwa kwamapharamitha, nokuhlukaniswa kwamatrices ahlanganisiwe. I-Scaling Law iphinde yalinganiswa kabusha ngokwesakhiwo esisha.
Uma iqhathaniswa ne-Qwen3.7-Plus, i-Qwen3.8-Flash inezindleko zokuqeqesha ezicishe zibe yingxenye eyodwa kwezingu-9 kuphela zale yangaphambili, kodwa inamandla angcono emisebenzini yokubhala amakhodi neyasehhovisi.
Ngamapharamitha angu-6B asebenzayo, i-Qwen3.8-Flash-Next-Base ithole imiphumela ehamba phambili ezivivinyweni ezi-8 kweziyi-14, okuhlanganisa i-MMLU-Pro, SuperGPQA, BBH, SWEBench-Pretrain, MGSM ne-MMMU.
Umbhalo kuphela:
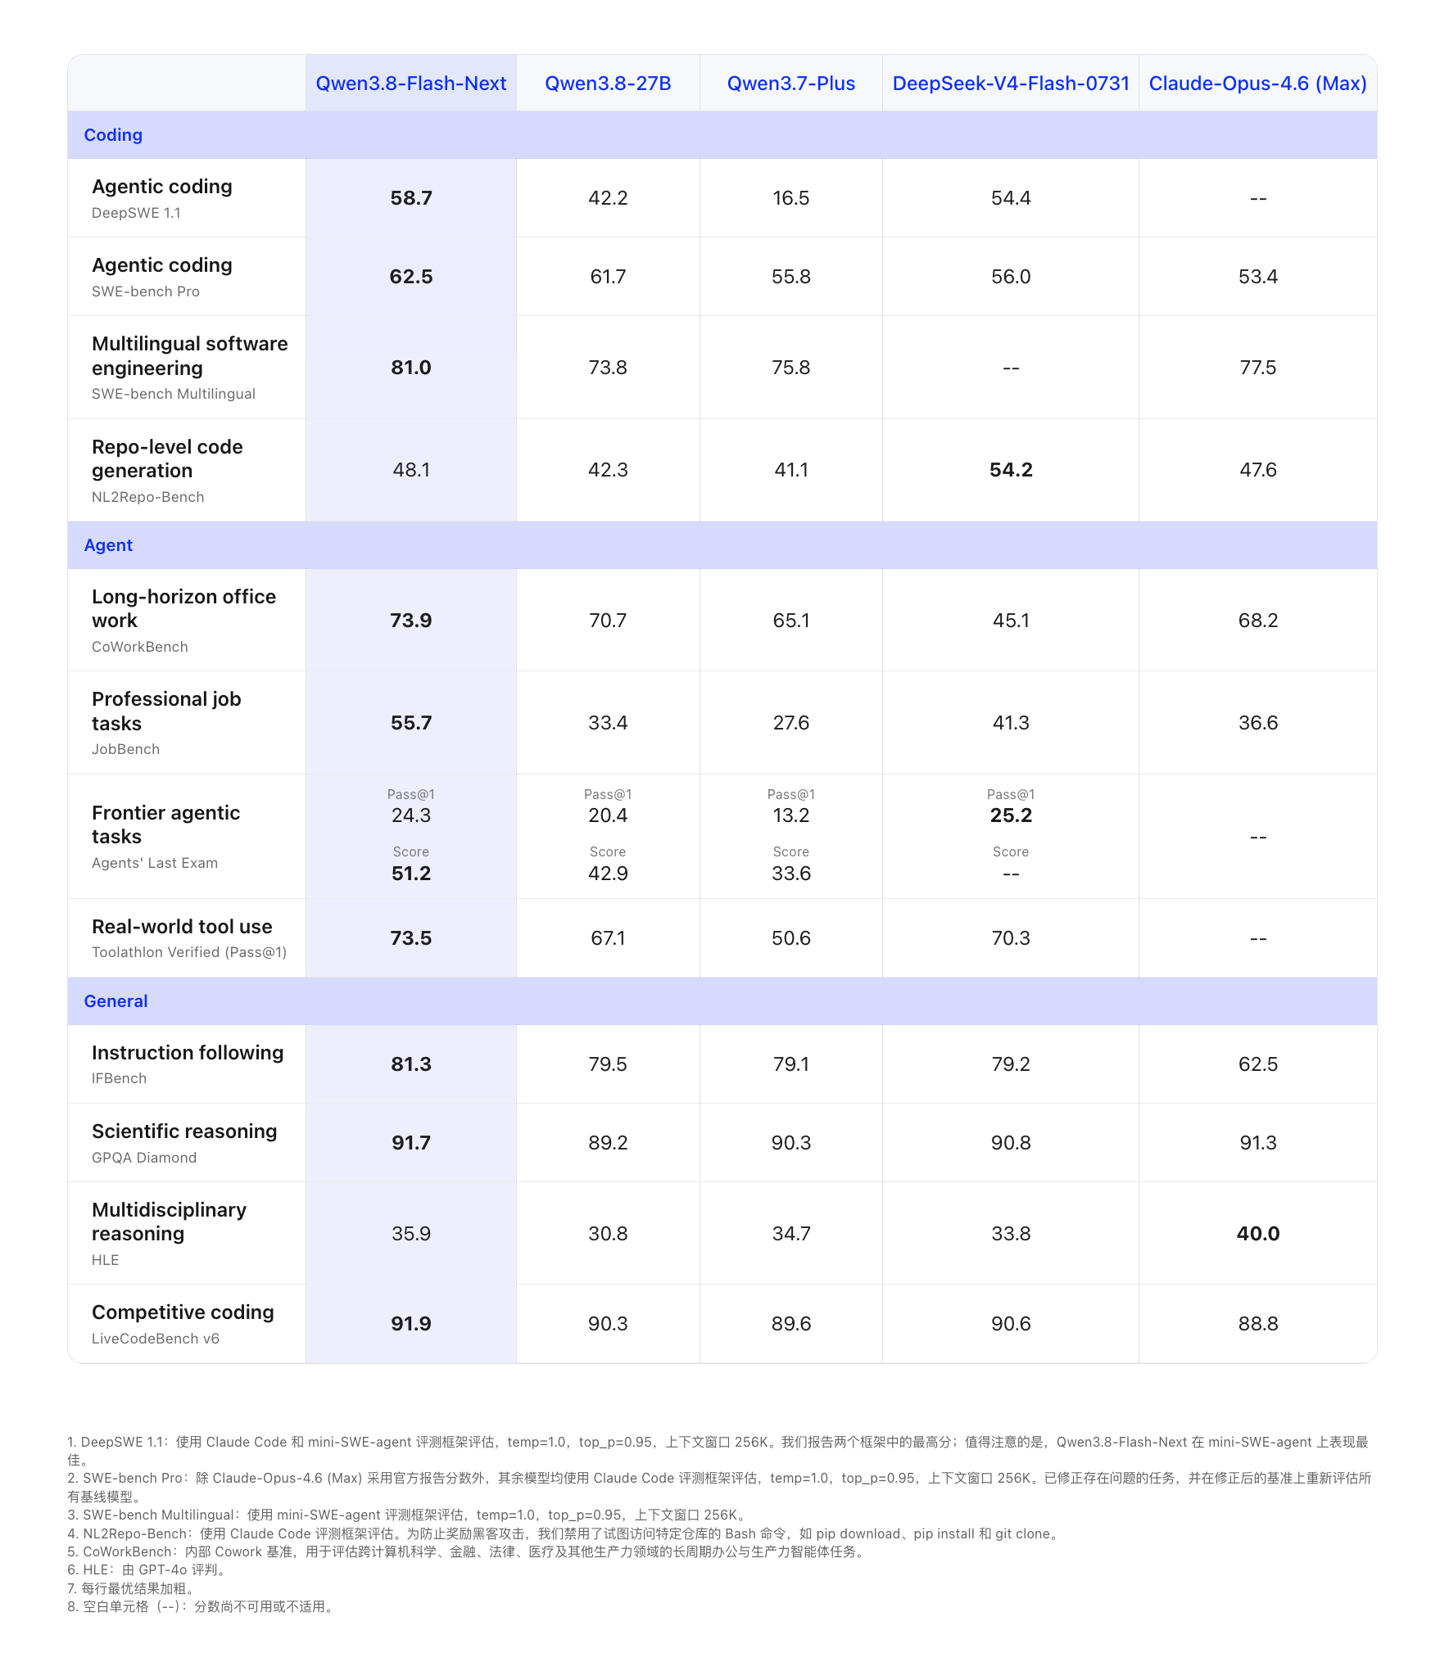
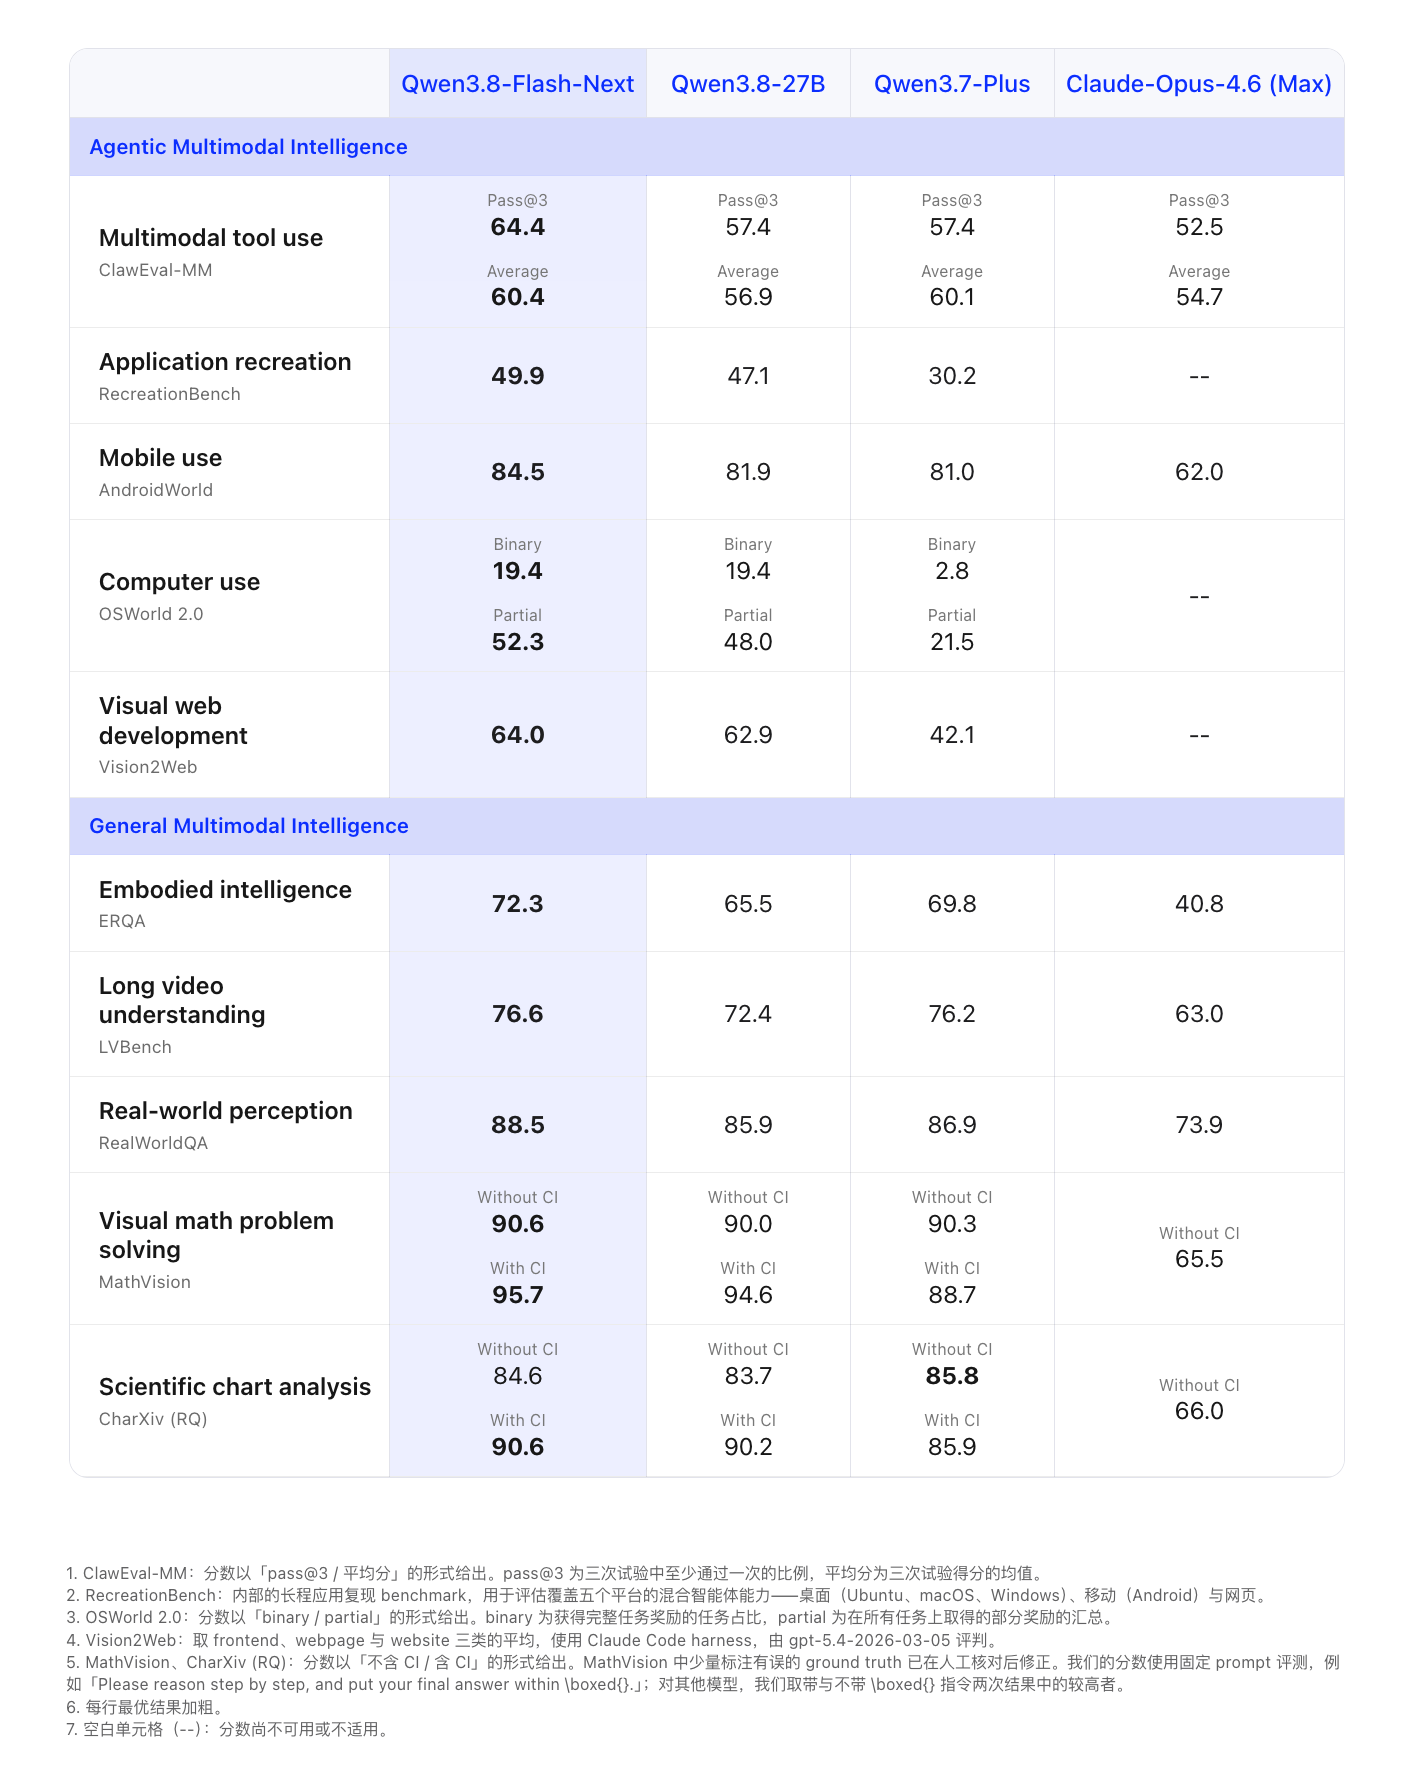
Izindlela eziningi:
Isakhiwo semodeli:
Ukusebenza kwemodeli ye-Base:
I-Qwen3.8-Flash izokwethulwa maduze epulatifomu ye-Qianwen AI, inikeze nge-API emphakathini, ngentengo engu-1 yuan ngokokufaka kwamathokheni ayisigidi, no-3 yuan ngokokukhipha.
Izisindo zemodeli zikhishwe njengomthombo ovulekile ngo-23:00 ngesikhathi sase-Beijing ngo-Agasti 26 ku-Hugging Face naku-ModelScope, kwakhishwa ngesikhathi esifanayo nenguqulo ye-FP8 quantization. I-Qwen3.8-Flash-Next isekela ngokuzenzakalelayo umongo ongu-1M futhi inamathuluzi asemthethweni akhelwe ngaphakathi.
Imithombo:
Umbiko wezobuchwepheshe: https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
Ibhulogi yezobuchwepheshe: https://qwen.ai/ blog?id=qwen3.8-flash-next
Hugging Face: https://huggingface.co/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921FsyOPe& ;amp;amp;file=Qwen3.8-Flash-Next
ModelScope: https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next ?spm= a2ty_o06.30285417.0.0.1d73c921XAP2dV& ;amp;amp;file=Qwen3.8-Flash-Next