

Yini i-DeepInfer-SM80?
DeepInfer-SM80 iqoqo lamamojuli e-Python, e-Triton, kanye ne-TileLang athuthukisiwe ukuze asebenzise i-DeepSeek-V4.1 kuma-GPU e-NVIDIA Ampere ngenjini ye-vLLM V1. Ithatha imibono eyisisekelo ku-DeepInfer ye-DeepSeek, egxile ku-NVIDIA Blackwell, bese ihlela kabusha indlela ebalulekile yokwenza umsebenzi ngokwamakhono wehadiwe ye-Ampere.
Esikhundleni sokuncika ezicini ezitholakala ku-Blackwell kuphela, njengemiyalelo ye-tcgen05 ye-warp-group, i-Tensor Memory, imiyalelo yehadiwe yesikali se-UE8M0, kanye no-228 KB wememori eyabiwe ku-streaming multiprocessor ngayinye, le phrojekthi isebenzisa ama-Tensor Core e-Ampere e-mma.sync.aligned.m16n8k16, ukuhlelwa komsebenzi okwazi i-SM, ukuqaqa i-UE8M0 nge-integer bitshift, kanye nokusetshenziswa kabusha kwe-YOCO shared-KV.
Le phrojekthi isekela ama-GPU e-SM80 ezikhungo zedatha afana ne-A100 ne-A800, kanye namadivayisi e-SM86 afaka i-RTX 3090, i-RTX 3090 Ti, i-RTX A6000, i-A40, i-A10, ne-A30. Ama-kernel ayo awasebenzisi ngaphezu kuka-48 KB wememori eyabiwe nge-CTA, okuwavumela ukuthi asebenze ngaphakathi kwemikhawulo ephansi yememori eyabiwe yamadivayisi e-SM86.
Kungani Uyisebenzise?
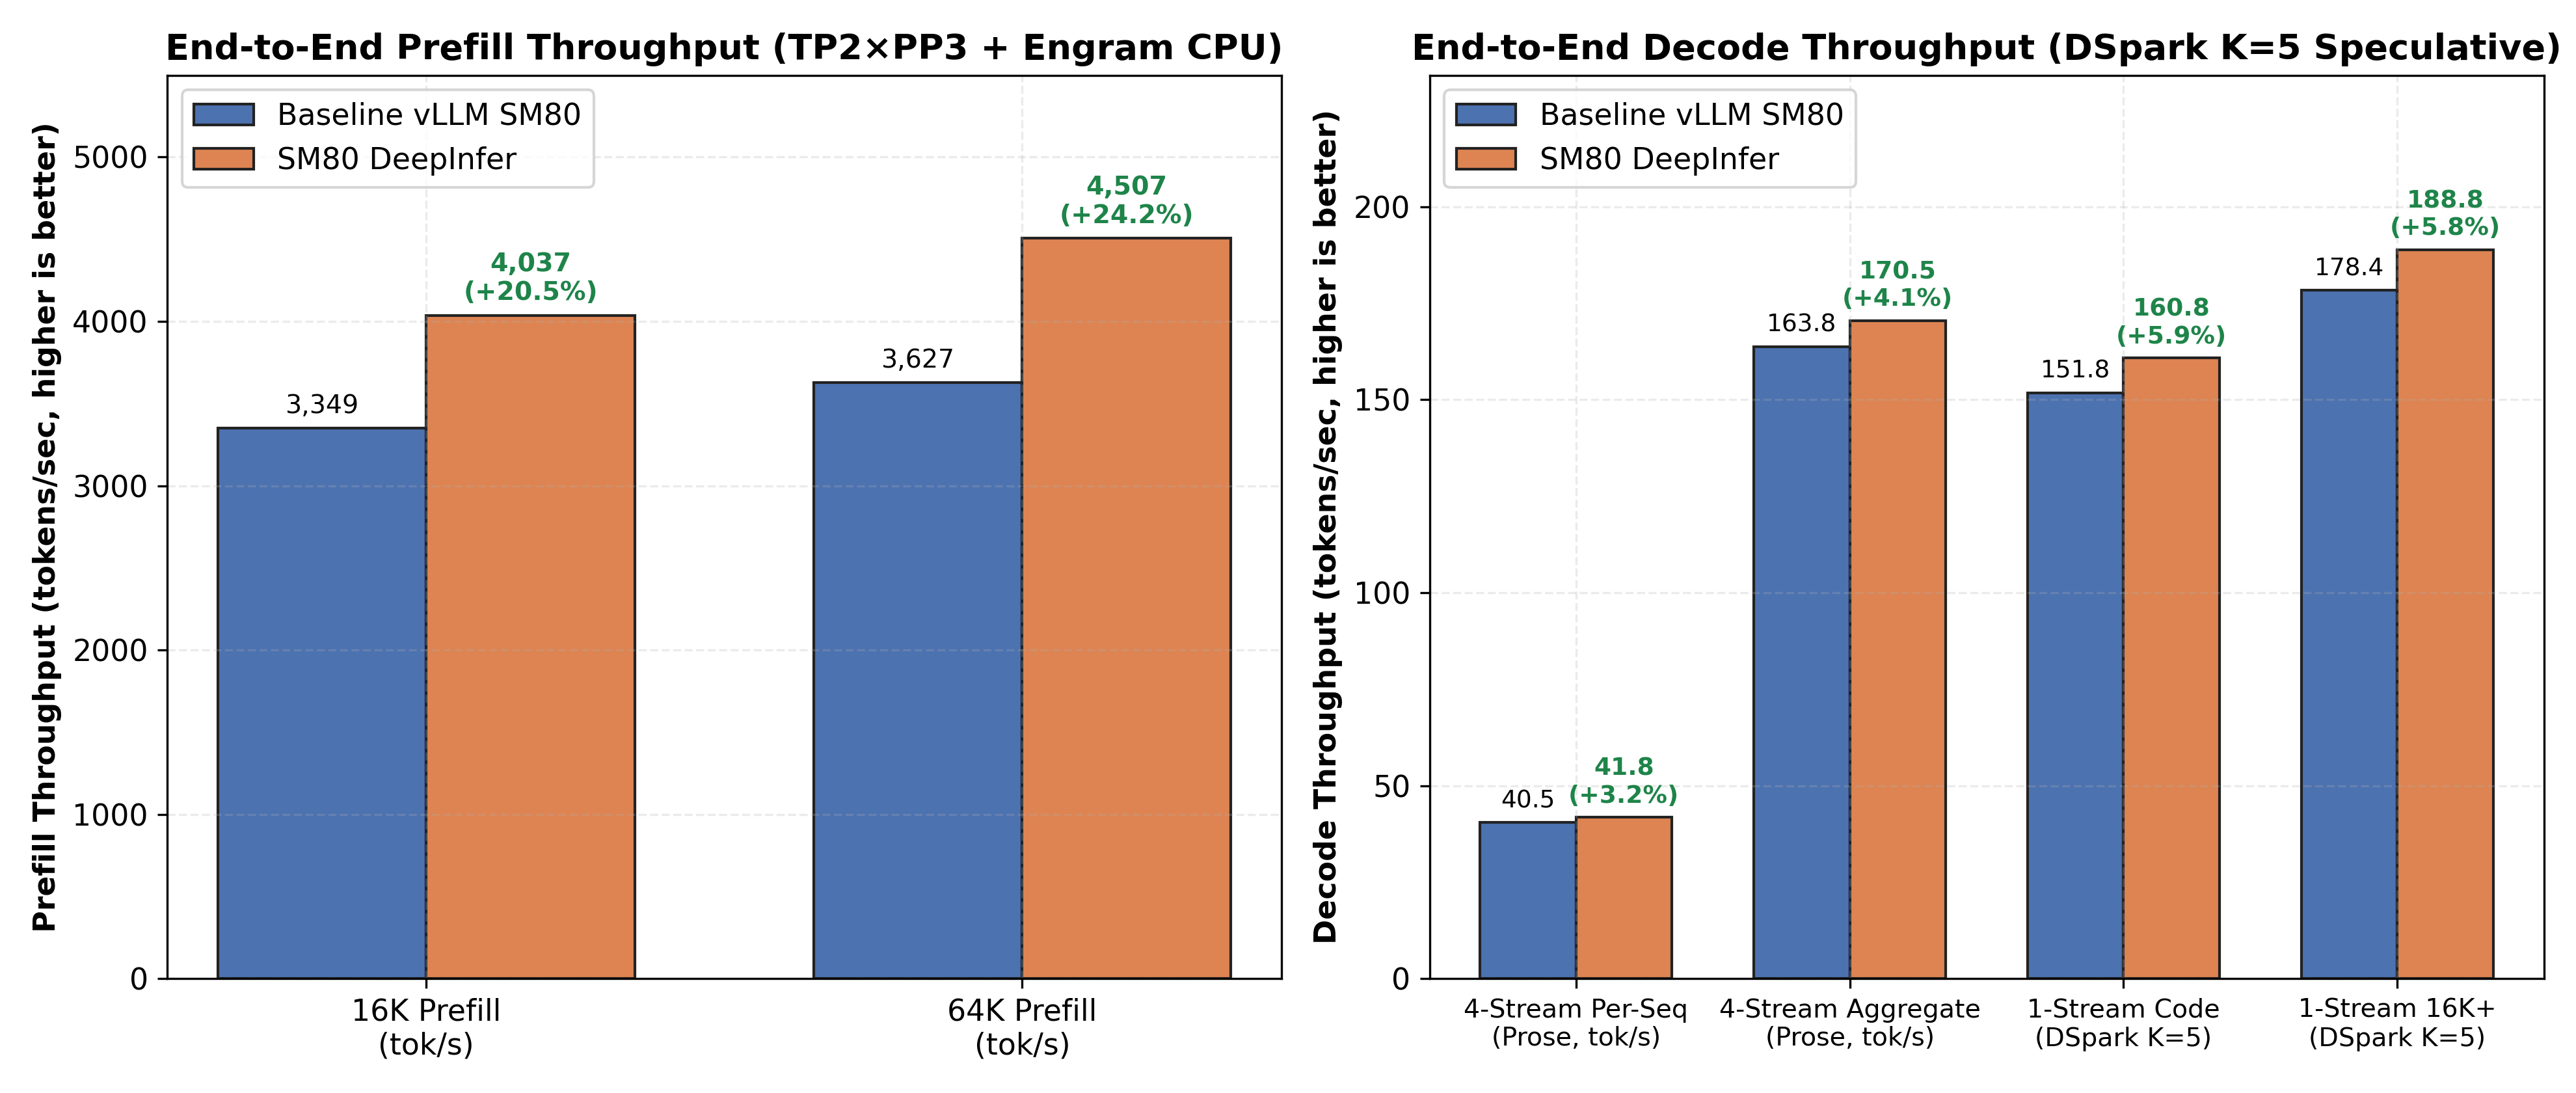
DeepInfer-SM80 igxile emisebenzini ebizayo ehilelekile ku-prefill ye-DeepSeek-V4.1, i-sparse attention, ukufinyelela ku-KV-cache, i-residual routing, kanye ne-inference yomongo omude. I-repository ibika imiphumela elandelayo evela ekucushweni kokukhiqiza okusebenzisa ama-GPU ayisithupha e-GA100 64 GB, TP2 × PP3, i-DSpark speculative decoding eno-K=5, kanye nobude obukhulu bomongo obungamathokheni angu-1,048,576:
- 16K cold prefill: amathokheni angu-4,037.0 ngomzuzwana, esuka kumathokheni angu-3,349.4 ngomzuzwana.
- 64K cold prefill: amathokheni angu-4,506.8 ngomzuzwana, esuka kumathokheni angu-3,627.3 ngomzuzwana.
- Isikhathi sokuqala sethokheni ku-64K: imizuzwana engu-10.7, sehla sisuka kumasekhondi angu-13.2.
- I-speculative decode yemifudlana emine: amathokheni ahlanganisiwe angu-170.5 ngomzuzwana, uma kuqhathaniswa namathokheni angu-163.8 ngomzuzwana.
- I-decode yomfudlana owodwa ngekhodi ye-Python: amathokheni angu-160.8 ngomzuzwana, uma kuqhathaniswa namathokheni angu-151.8 ngomzuzwana.
- Umthamo we-KV ohlala ku-GPU: amathokheni angu-4,648,480, ngaphandle kwezindleko ezengeziwe ze-VRAM uma kuqhathaniswa nesisekelo.
Lezi zilinganiso zichaza ihadiwe yokuhlola nokucushwa kwesevisi kwe-repository. Imiphumela kwamanye ama-GPU e-Ampere, ukucushwa kwamamodeli, imithwalo yomsebenzi, noma izindawo ze-vLLM ingahluka.
Ukuthuthukiswa Okubalulekile
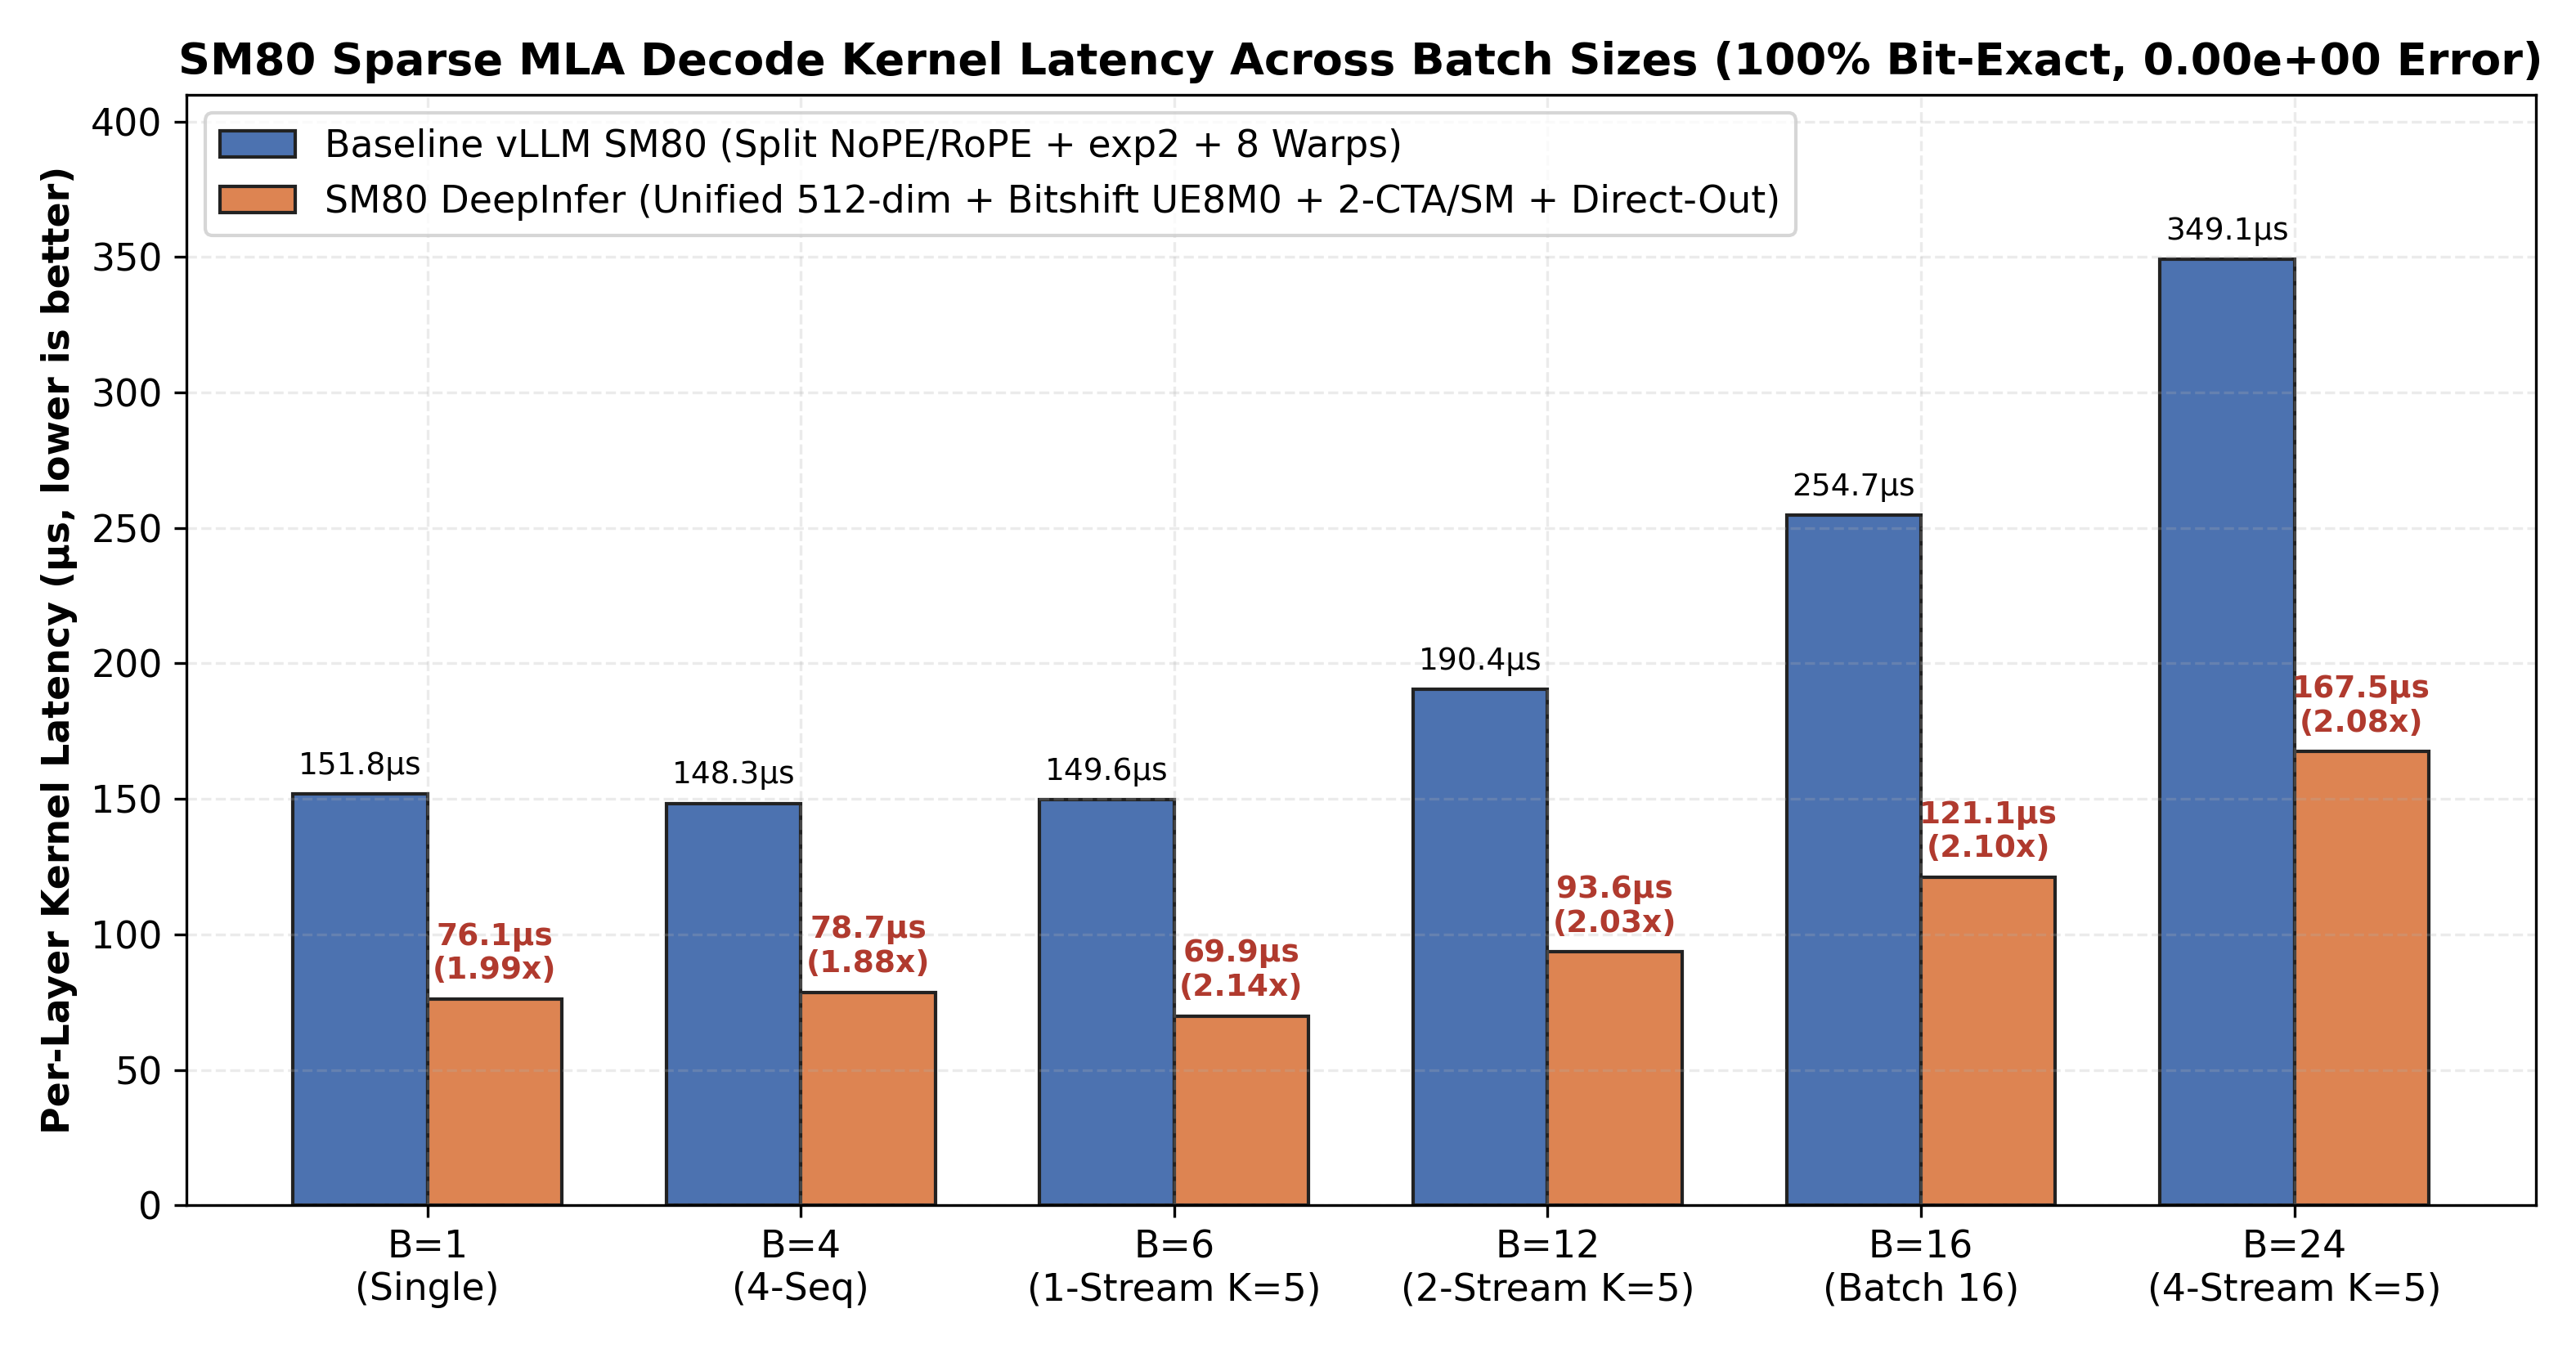
I-Sparse MLA Ehlanganisiwe Enobukhulu obungu-512
I-DeepSelect sparse attention ye-DeepSeek-V4.1 igcina i-NoPE latent enobukhulu obungu-448 ku-float8_e4m3fn, isebenzisa izikali zamabhulokhi ze-UE8M0 ezinamandla ka-two, kanye nesijobelelo se-BF16 RoPE esinobukhulu obungu-64. I-DeepInfer-SM80 ilayisha ithayela eliphelele elinobukhulu obungu-512 futhi ilicubungule ngendlela eyodwa ye-Tensor Core dot-product, esikhundleni sokuphatha izingxenye ze-NoPE ne-RoPE ngokwehlukana.
I-kernel ishintsha ukuguqulwa kwe-UE8M0 okusekelwe ku-exp2 ibe yi-integer bitshift ye-IEEE-754:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)Kuma-exponent e-UE8M0 avumelekile, lokhu kukhiqiza amanani esikali e-FP32 afana ncamashi ngamabhithi, kuyilapho kususwa umsebenzi kuma-transcendental operations uwuyise ku-integer pipeline.
Ukucushwa okulungiselelwe kusebenzisa i-BLOCK_N=64, num_warps=4, kanye ne-num_stages=2. Ukunciphisa ingcindezi yama-register kuvumela ama-CTA amabili ukuthi ahlale ku-streaming multiprocessor ngayinye ye-SM80. Uma i-num_kv_splits == 1, i-kernel ibhalela ngqo kokuphumayo kokugcina futhi igwema ukwethula isigaba sokunciphisa esihlukile.
I-Top-K ne-SWA Index Combination Kusetshenziswa i-CTA Eyodwa
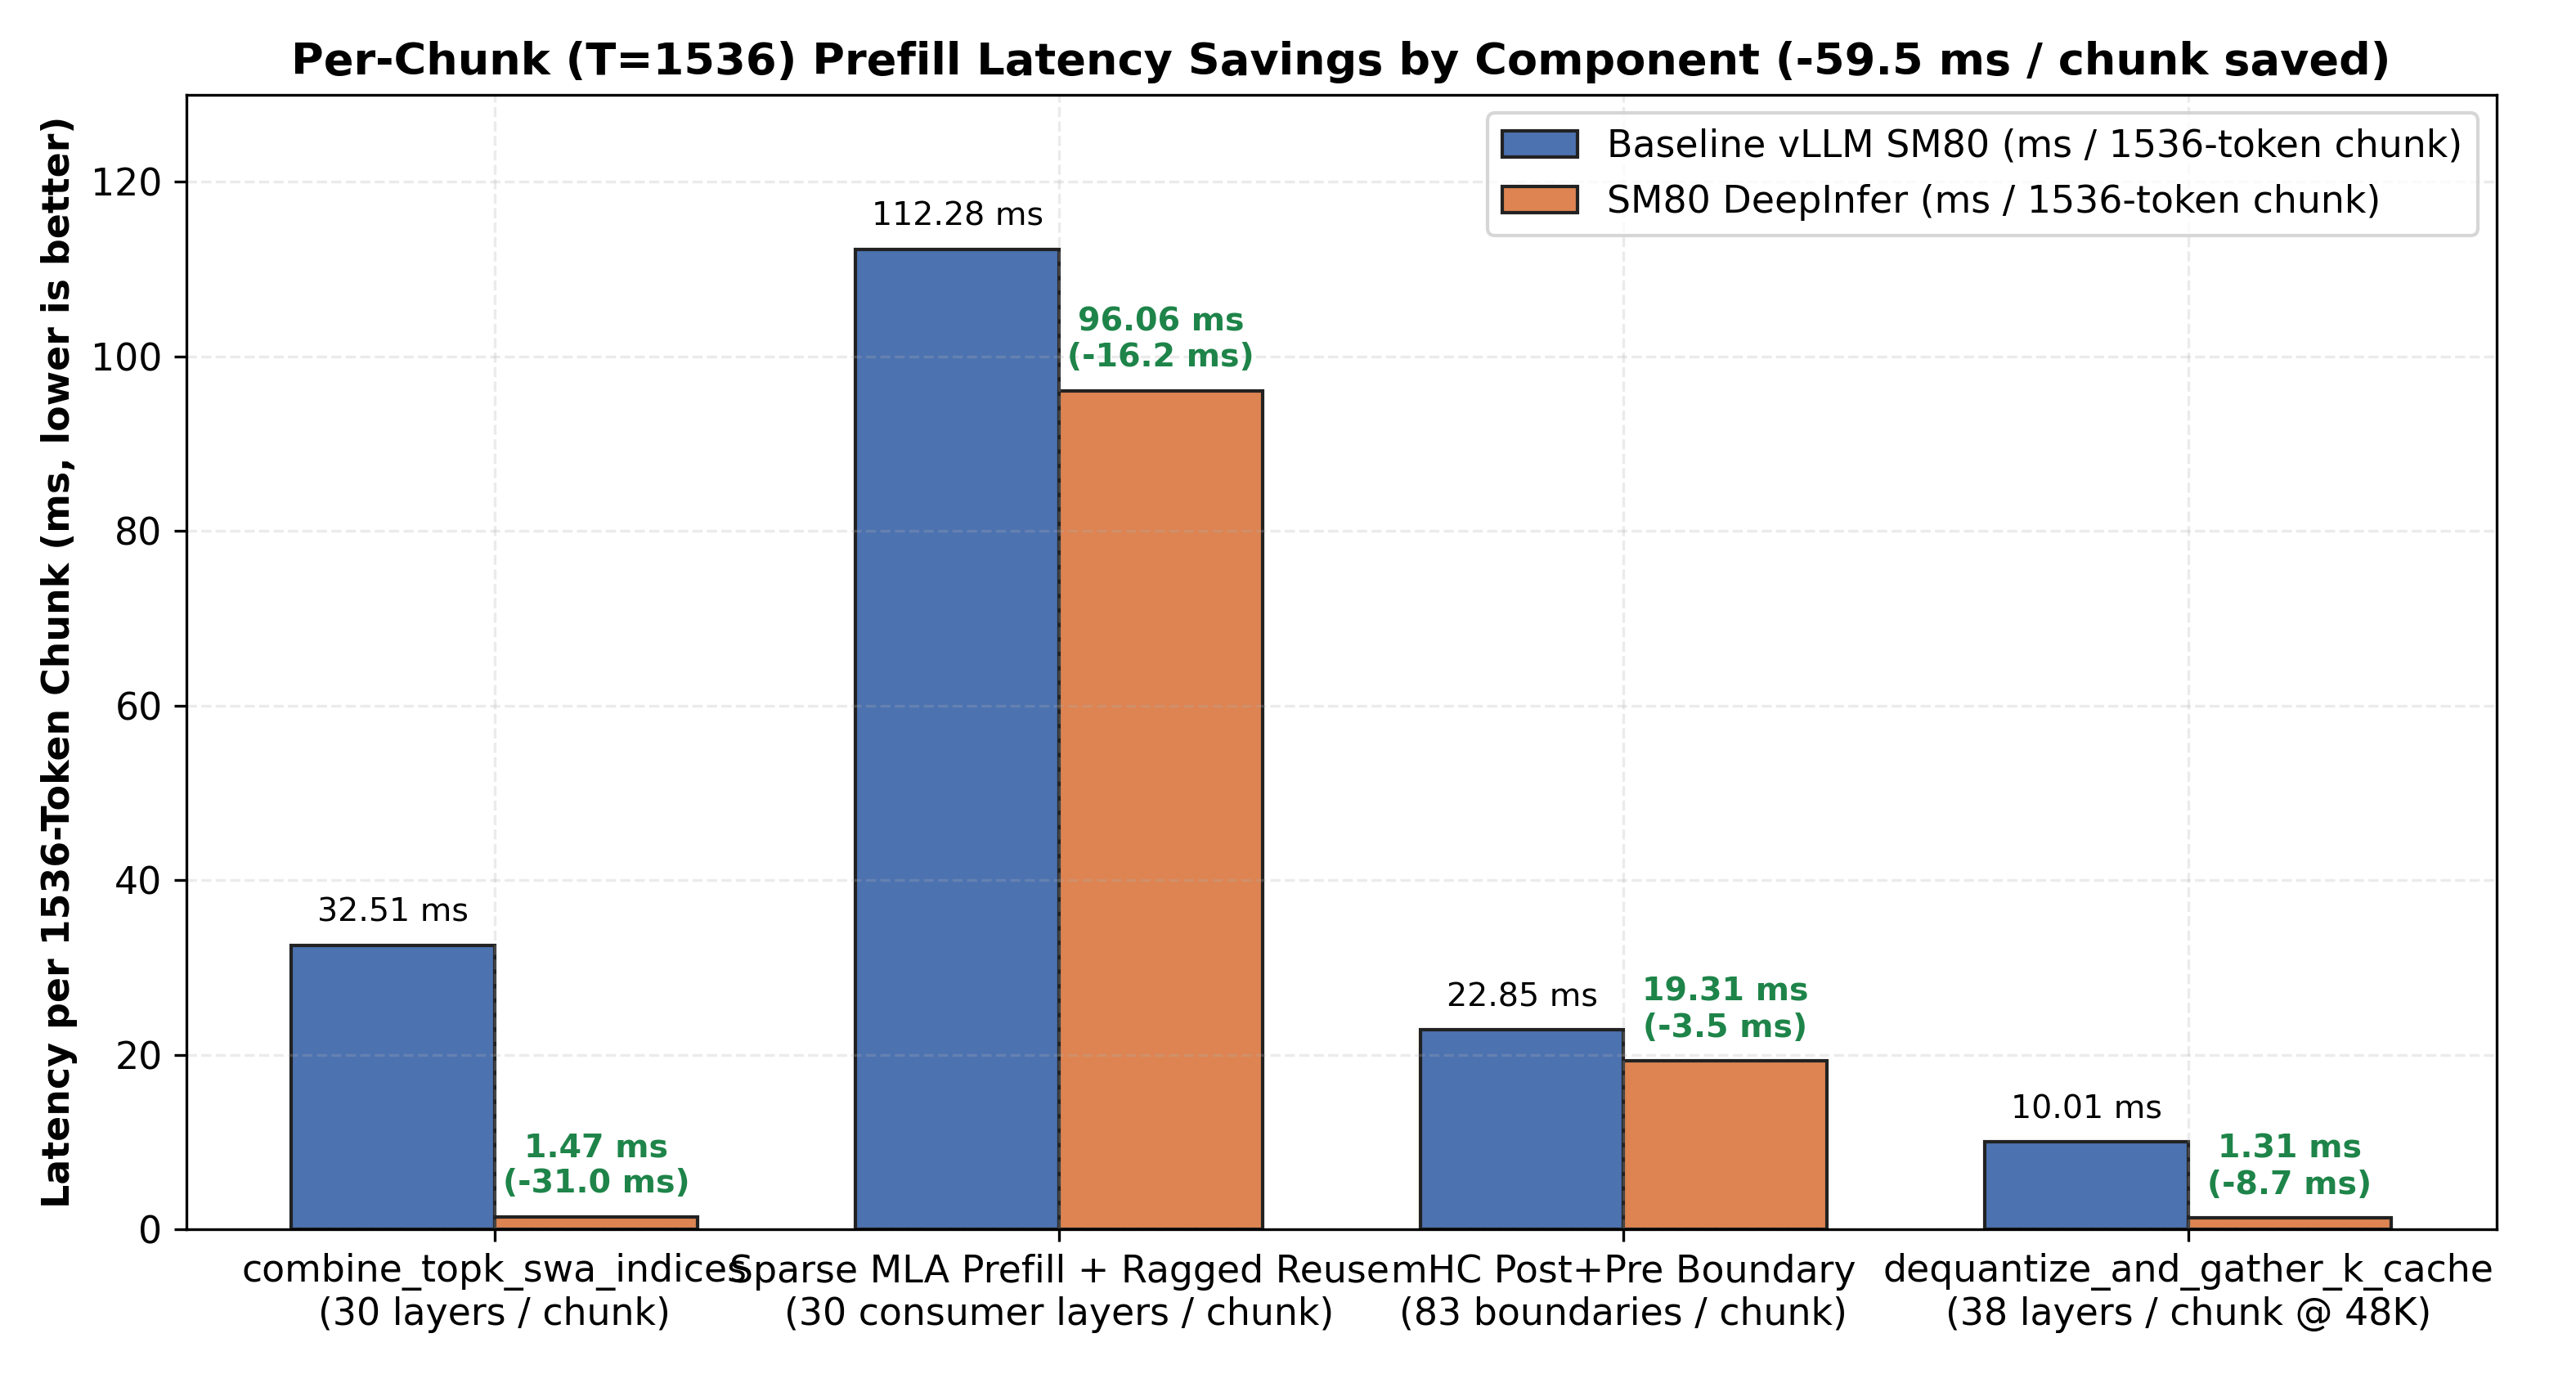
I-_combine_topk_swa_indices_kernel elungiselelwe ithatha indawo yochungechunge lokwabiwa nemisebenzi ye-PyTorch nge-kernel eyodwa ye-Triton esebenzisa i-CTA eyodwa ngethokheni yombuzo. Ku-T=1536, ukubambezeleka okulinganisiwe kwehla kusuka kuma-microsecond angu-1,083.72 kuya kuma-microsecond angu-48.88, okuwukusheshisa okungu-22.17×.
Ukuze kugwenywe ukungqubuzana kokubhala phakathi kwama-warp, umugqa ngamunye wokuphumayo uhlukaniswa ube yizifunda ezintathu ezingahlangani:
- Ama-index e-Top-K acindezelwe athatha
[0, topk_len). - Ama-index e-sliding-window attention athatha
[topk_len, topk_len + swa_len). - Amakholomu asele agcwaliswa ngo-
-1.
I-README ibika ukuphumayo okufana ncamashi ngamabhithi kubo bonke ubude bokulandelana namazinga okucindezela angu-0, 1, no-2 ahloliwe.
I-KV-Cache Dequantization nokuqoqa Okusheshayo
Indlela ye-dequantize_and_gather_k_cache isebenzisa ukuguqulwa kwe-UE8M0 okusekelwe ku-bitshift efanayo. Iphinde ibhale isebenzisa ama-destination stride anikezwe i-kernel ye-Triton, isuse ukwabiwa kwe-torch.empty okuphakathi kanye nemisebenzi elandelayo ye-.copy_().
Ukusheshisa okulinganisiwe kungu-4.02× kumongo ongu-16K kanye no-7.64× kumongo ongu-48K, ngokufana ncamashi kwamabhithi nezinkomba zokubhekisela ekuhlolweni okubikiwe.
I-mHC Residual Routing Elungiselelwe i-SM80
I-DeepSeek-V4.1 yenza i-four-stream manifold-constrained hyper-connection routing emingceleni engu-83 ngesikhathi sokudlula phambili ngakunye. I-DeepInfer-SM80 yengeza i-geometry ehlukaniswe ngo-(6, 8, 128) ehambisanayo ngosayizi ofihlekile wemodeli ongu-5,120. Ngasinye seziqephu eziyisishiyagalombili siqukethe izakhi ezingu-640, ezihlukaniseka ngo-128.
Le phrojekthi iphinde yehlise umkhawulo wama-matrix amancane ukusuka ku-32 uye ku-16 ukuze izibalo zamathokheni okungenani angu-16 zisebenzise indlela ye-Tensor Core T.gemm. I-mhc_fused_post_pre_delayed speedup ebikiwe ingu-2.89× ku-T=12 no-1.30× ku-T=6.
Ukusetshenziswa Kabusha Kwemethadatha ye-YOCO
Esakhiweni se-You-Only-Cache-Once se-DeepSeek-V4.1, izendlalelo 21 kuya ku-39 zifunda ku-KV cache enokulungiswa okuphelele yesendlalelo 20. Lezi zisebenzisi zabelana ngobude obufanayo obunwetshiwe bokulandelana, ithebula lamabhulokhi, kanye nesilinganiso sokucindezela.
I-DeepInfer-SM80 igcina imethadatha ye-K engalingani kumongo we-vLLM forward lapho icubungula isendlalelo 20. Ukuphinda kusetshenziswe le datha ezendlalelweni 21 kuya ku-39 kususa amaketanga e-GPU kernel angu-19 aphindaphindwayo okwakha imethadatha ku-chunk ngayinye ye-prefill.
Ngaphambi Kokufaka
Udinga indawo ye-vLLM V1 ezosebenzisa i-DeepSeek-V4.1 ku-NVIDIA Ampere GPU esekelwayo. Indawo yokugcina inikeza i-patch ehlanganisiwe namamojula ayisithupha ashintshwayo, kodwa i-README ayibeki izinombolo eziqondile zezinguqulo ze-CUDA, Python, Triton, TileLang, noma vLLM. Sebenzisa i-vLLM checkout ehambisana ne-patch kanye nokusetshenziswa kwakho kwamanje kwe-DeepSeek-V4.1.
Amaqembu e-hardware asekelwayo yilawa:
- Ama-GPU e-SM80 ezikhungo zedatha: A100 40 GB, A100 80 GB, GA100 64 GB, kanye ne-A800 40 GB noma 80 GB.
- Ama-GPU e-SM86 eziteshini zokusebenza nawabathengi: RTX 3090, RTX 3090 Ti, RTX A6000, A40, A10, kanye ne-A30.
Le software isatshalaliswa ngaphansi kwe-Apache License 2.0.
Indlela Yokufaka A: Sebenzisa I-Patch Ehlanganisiwe
Le ndlela isebenzisa wonke amafayela ayisithupha ashintshiwe ku-vLLM source checkout. Vula i-terminal kumkhombandlela oyimpande wale checkout bese usebenzisa:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patchFaka esikhundleni /path/to/Deepinfer-SM80 ngendawo yephrojekthi e-clone-ntiwe noma elandiwe. I-patch iqukethe izinguquko ze-sparse MLA, cache-gather, Top-K kanye ne-SWA, mHC, warmup, kanye nokusetshenziswa kabusha kwemethadatha ye-YOCO.
Indlela Yokufaka B: Faka Amamojula E-Drop-In
Uma ukushintsha amafayela ngokuqondile kulungele kakhulu indawo yakho, kopisha isihlahla samamojula e-vLLM sephrojekthi usibeke phezu kwephakheji ye-vLLM efakiwe:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm/Faka esikhundleni /path/to/site-packages/vllm/ ngomkhombandlela wangempela wephakheji ye-vLLM. Amafayela afanayo angaphinde afakwe njengezendlalelo eziboshelwe zokufunda kuphela ekusetshenzisweni kwe-Docker.
Isihlahla se-drop-in siguqula lezi zindawo zokusebenza:
model_executor/kernels/mhc/ukuze kusetshenziswe i-TileLang mHC kanye ne-warmup.models/deepseek_v4_1/amd/rocm.pyukuze kusetshenziswe i-Triton Top-K kanye ne-SWA combiner.models/deepseek_v4_1/common/ops/cache_utils.pyukuze kuqoqwe i-KV-cache.models/deepseek_v4_1/nvidia/model.pyukuze kuphinde kusetshenziswe imethadatha ye-YOCO.v1/attention/ops/rocm_aiter_mla_sparse.pyukuze kusetshenziswe ama-kernel e-sparse MLA ahlanganisiwe.
Yize amafayela amabili athuthukisiwe esagcina u-
rocmnoma u-amdezindleleni zawo, indawo yokugcina iwasebenzisa ngokusobala njengengxenye yokuhlanganiswa kwe-vLLM okuqondiswe ku-Ampere. Gcina isakhiwo somkhombandlela esinikeziwe lapho usebenzisa amafayela e-drop-in.
Ukusetshenziswa Okuyisisekelo: Qinisekisa Ama-Kernel
Ngemva kokufaka i-patch noma amamojula e-drop-in, sebenzisa ama-microbenchmark ahlukene anikeziwe ku-A100, A800, RTX 3090, RTX A6000, noma kwenye i-Ampere GPU esekelwayo:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
Amafayela e-benchmark ahlanganisa ama-kernel e-sparse MLA nawe-KV-gather, ama-kernel e-TileLang mHC, kanye ne-Top-K plus SWA combiner. Inhloso yawo ukukala ukubambezeleka kwe-kernel endaweni yangakini nokuqinisekisa imiphumela ethuthukisiwe uma iqhathaniswa nezinkomba eziyisisekelo.
Yakha amashadi e-benchmark wendawo yokugcina usebenzisa:
python3 benchmarks/generate_charts.pyIsethi ephelele yedatha ye-benchmark iyatholakala futhi ku-benchmarks/results/sm80_benchmark_summary.json.
Ukuqonda Ukuqinisekiswa Kwezinombolo
Izindlela eziningana ezithuthukisiwe kubikwa ukuthi zinemiphumela efana ncamashi nge-bit:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
Ezinye izindlela ze-Tensor Core zingahluka kancane ngenxa yokuthi ukuqoqwa kwe-BF16 noma ukuhleleka kokusetshenziswa kwe-MMA kuyashintsha. Umehluko omkhulu obikiwe ungaphansi kuka-1.9e-3 ekucushweni kwe-mHC ehlanganisiwe okulinganisiwe, futhi ungaphansi kuka-4.8e-3 ekucushweni kwe-sparse-attention prefill okulinganisiwe.
Imiphumela ye-prompt-logprob negative log-likelihood yahlala ngaphakathi kwezinga lomsindo elibikiwe phakathi kokugijima. Lapho uhlola ukusetshenziswa, hlola kokubili ukusebenza kanye nemiphumela yezinombolo, kunokuba ucabange ukuthi wonke ama-operator athuthukisiwe kufanele afane ncamashi nge-bit.
Amathiphu Okusetshenziswa Okuthuthukile
Sebenzisa i-TP2 × PP3 Esakhiweni Sokukhiqiza Esihloliwe Sama-GPU Ayisithupha
Kuma-Ampere GPU ayisithupha anomthamo ongu-64 GB noma 80 GB, indawo yokugcina incoma i-TP2 × PP3 enokwahlukaniswa kwezendlalelo okungu-14,14,12. Ekucushweni okuhloliwe, le nhlanganisela inikeze amathokheni angu-160.8 kuya ku-188.8 ngomzuzwana kumakhodi akhethiwe asebenzisa ukusakaza okukodwa kanye nemithwalo yokukhiqiza ende, amathokheni angu-4,506.8 ngomzuzwana ku-cold prefill engu-64K, kanye nomthamo wamathokheni e-KV ahlala ku-GPU ongaba yizigidi ezingu-4.65.
Lo mthamo uhambisana cishe nezimo ezingu-4.43 zomongo onamathokheni ayisigidi ngaphansi kokucushwa kwe-benchmark.
Qonda Ezinye Izinketho
- PP6: inikeza umthamo wamathokheni ongaba yizigidi ezingu-4.5 kuya ku-4.7, kodwa i-README ibika ukuthi i-single-stream decode ihamba kancane kakhulu ngoba i-tensor parallelism ingu-1 futhi izicelo zidlula ezigabeni eziyisithupha ze-pipeline.
- TP2 kanye ne-TP4 engalingani: yandisa umthamo olinganisiwe ube cishe amathokheni ayizigidi eziyisithupha, kodwa ukuhlukanisa usayizi we-MoE intermediate ongu-2,304 kube izingxenye ze-TP4 ezinobubanzi obungu-576 kunciphisa ukusebenza kahle kwamathayela e-Marlin.
Bheka docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md endaweni yokugcina ikhodi ngaphambi kokukhetha i-topology yokusetshenziswa kwamathokheni ayisigidi.
Hlola Umthwalo Wangempela Womsebenzi
Ukuthuthuka okukhulu kuvela kuma-operator asetshenziswa njalo, kodwa ukuthuthuka kokuphela kuya ekupheleni kuncike kubude be-prompt, ekusebenzeni kanyekanye, ekuqoqweni kokuqagela, ku-topology, nakumodeli ye-GPU. Qala ngokusebenzisa ama-benchmark ahlukanisiwe, bese uqhathanisa imithwalo ephelele yokunikeza usebenzisa ama-prompt afanayo, osayizi bomongo abafanayo, namazinga afanayo okusebenza kanyekanye nalawo asetshenziswa uhlelo lwakho lokukhiqiza.
Gcina Indlela Esheshayo Yokukhipha Ngokuqondile
Ukuthuthukiswa kwe-sparse MLA decode kweqa ukuqaliswa kwesibili kwe-reduction lapho num_kv_splits == 1. Uma ushintsha ukuhlela kwe-attention noma ukuziphatha kokuhlukanisa, linganisa kabusha i-kernel, ngoba indlela yokukhipha ngokuqondile iyingxenye ebalulekile yokuthuthuka kwe-decode okubikiwe.
Gcina Imethadatha ye-YOCO Ku-Forward Context
Inqolobane yemethadatha yesendlalelo 20 ibalulekile ngoba bonke abasebenzisi besendlalelo 21–39 babelana ngomthombo wayo we-KV. Izinguquko ekusebenzeni kwemodeli noma ekuphathweni kwe-forward context kufanele zigcine lokhu kusetshenziswa kabusha; ngaphandle kwalokho, injini ingakha kabusha imethadatha efanayo ye-ragged kusendlalelo ngasinye somsebenzisi.
Isiphetho
i-DeepInfer-SM80 inikeza indlela egxile ekusheshiseni i-DeepSeek-V4.1 ku-NVIDIA Ampere ngaphandle kokwengeza izindleko ze-KV-cache VRAM. Ukuthuthuka kwayo kuhlanganisa i-sparse attention ehambisana ne-Ampere, i-bitshift UE8M0 decoding, ukukhipha okuqondile kwe-KV-cache, i-Top-K ne-SWA combiner engenazimo zomjaho, i-mHC routing ehambisanayo, kanye nokusetshenziswa kabusha kwemethadatha ye-YOCO.
Qala ngokusebenzisa i-unified patch noma ufake amamojula ayisithupha afaka esikhundleni sawo. Sebenzisa wonke ama-microbenchmark suite amathathu ukuze uqinisekise i-latency nokuziphatha kwezinombolo ku-hardware yakho, bese uhlola indawo ye-vLLM ethuthukisiwe ngomthwalo wakho wangempela wokunikeza. Ekusetshenzisweni kwama-GPU ayisithupha okunomongo wamathokheni ayisigidi, sebenzisa ukucushwa okuhloliwe kwe-repository okuthi TP2 × PP3 njengendawo eyinhloko yokubhekisela.