

MACaQ هو مشروع تكميم مُعاير ومستقل عن النموذج، الهدف ديالو هو ينقص متطلبات الذاكرة والحساب ديال نماذج الذكاء الاصطناعي الحديثة. كيدعم سيرورات خدمة النصوص والصور والفيديو والصوت عبر llama.cpp وvLLM وDiffusers وPyTorch.
المشروع كيركّز على أوزان وتنشيطات منخفضة الدقة ومُعايرة، مع الحفاظ على توافق عملي مع الاستدلال. حسب ملف README، يقدر MACaQ يكمّم نموذج فيه 122 مليار مُعامِل فـ64 دقيقة باستعمال 32.5 GB من ذاكرة الجهاز. وكيسجّل حتى هو تعقيداً أقل من MR-GPTQ وDuQuant++ فبعض المقارنات، أو تعقيداً مشابهاً لـLlama-3-8B مع وقت تكميم أقل بزاف.
اختار الواجهة الخلفية المناسبة لـMACaQ
بدا باختيار الواجهة الخلفية اللي كتوافق النموذج والهدف ديال النشر. استعمل بيئة مستقلة لكل واجهة خلفية، مع Python 3.12.
- Diffusers: كمّم نماذج توليد الصور والفيديو والصوت إلى نقاط تحقق safetensors بصيغة W4A4.
- llama.cpp: كمّم نماذج النصوص إلى ملفات GGUF بـ2 أو 3 أو 4 بت، وشغّلها محلياً، حتى على CPU.
- vLLM: كمّم نماذج النصوص للتوليد أو لتقديم الخدمة عبر HTTP باستعمال صيغة W4A4 أو صيغ الأوزان فقط.
- PyTorch: كمّم نماذج توليد الكلام إلى نقاط تحقق W4A4 وولّد صوت WAV.
المستودع فيه تعليمات خاصة بكل واجهة خلفية للتثبيت والمعايرة والتكميم والتوليد. حلّ الدليل ديال الواجهة اللي اخترتي قبل ما تبدا:
- تثبيت Diffusers وسيرورات العمل
- تثبيت llama.cpp وسيرورات العمل
- تثبيت vLLM وتقديم الخدمة
- سيرورات الكلام باستعمال PyTorch
وجد البيئة ديالك
استعمل Python 3.12 وخلق بيئة معزولة للواجهة الخلفية اللي ناوي تستعمل. فصل البيئات كيساعد على تفادي تعارضات التبعيات بين llama.cpp وvLLM وDiffusers وPyTorch.
نسخ مستودع MACaQ ودخل للمجلد ديالو.
خلق بيئة افتراضية بـPython 3.12 للواجهة الخلفية المختارة.
تبع ملف README ديال الواجهة الخلفية باش تثبّت التبعيات ديالها وأي بيئة تشغيل مطلوبة.
وجد النموذج الأصلي وبيانات المعايرة ومجلد الإخراج المحددين فدليل الواجهة الخلفية.
أوامر التثبيت الدقيقة كتختلف حسب الواجهة الخلفية وعائلة النموذج، لذلك استعمل README المرتبط بلا ما تطبّق أمر تثبيت عام واحد على جميع سيرورات العمل.
كمّم النماذج التوليدية باستعمال Diffusers
الواجهة الخلفية ديال Diffusers كتتعامل مع محوّلات الانتشار وكتحفظ نقاط تحقق safetensors مكمّمة. وكتدعم توليد الصور والفيديو وتحويل الصورة إلى فيديو والصوت.
المستودع كيوفّر سيرورات عمل لنماذج من بينها black-forest-labs/FLUX.2-klein-4B وWan-AI/Wan2.2-TI2V-5B-Diffusers وylacombe/stable-audio-1.0. بالنسبة لنماذج تحويل الصورة إلى فيديو، تقدر المعايرة تستعمل صوراً توجيهية باش تعكس عملية التكميم نمط الإدخال المقصود.
حلّ دليل Diffusers واختار سيرورة الصور أو الفيديو أو الصوت.
ثبّت متطلبات الواجهة الخلفية فبيئة مخصصة بـPython 3.12.
نزّل النموذج الأصلي أو حدّدو، ووجد مدخلات المعايرة المطلوبة فالوصفة المختارة.
شغّل أمر التكميم الموثق باش تحفظ نقطة تحقق safetensors بصيغة W4A4.
استعمل أمر التوليد المقابل باش تنتج صورة أو فيديو أو صوت.
كمّم نماذج النصوص باستعمال llama.cpp
الواجهة الخلفية ديال llama.cpp كتنتج ملفات GGUF مدمجة لتوليد النصوص. وكتدعم صيغ GGUF بـ2 و3 و4 بت، وكتتضمن بيئة تشغيل لتوليد النصوص من النموذج الناتج.
المستودع كيوثّق نماذج كثيفة بحال Qwen/Qwen3-4B، ونماذج هجينة بحال Qwen/Qwen3.8-27B، ونماذج خليط الخبراء بحال Qwen/Qwen3-30B-A3B وQwen/Qwen3-Coder-30B-A3B-Instruct. وكيشمل حتى وصفات لـQwen3.6-35B-A3B وQwen3.8-Flash-Next.
سيرورة التكميم العادية
حلّ دليل llama.cpp واختار الوصفة اللي كتوافق معمارية النموذج ديالك.
ثبّت واجهة llama.cpp الخلفية والتبعيات ديالها فبيئة مخصصة بـPython 3.12.
وجد نموذج Hugging Face الأصلي ونص المعايرة الموصوفين فالوصفة المختارة.
شغّل سيرورة تكميم MACaQ الموثقة وحفظ إخراج GGUF.
استعمل بيئة التشغيل المرفقة أو تثبيتاً متوافقاً مع llama.cpp باش تولّد النصوص.
بالنسبة للتفاصيل الخاصة بكل موديل، تبع القسم ديال dense أو hybrid أو mixture-of-experts أو Flash-Next فـ README ديال backend. هاد الوصفات كتاخد بعين الاعتبار الاختلافات بين معماريات الموديلات.
شغّل موديل GGUF
منين كيتصاوب ملف GGUF، شغّلو باستعمال عميل سطر الأوامر ديال llama.cpp:
llama cli -m models/model-macaq-r.ggufوتقدر حتى تقدّم الموديل عبر llama.cpp:
llama serve -m models/model-macaq-r.ggufحسّن ملفات GGUF الموجودة باستعمال MACaQ-R
MACaQ-R كيحسّن أكواد الأوزان فملف GGUF مكمّم موجود، مع الحفاظ على الصيغ الأصلية ديالو ومقاييس البلوكات. الملف الناتج كيبقى متوافق مع تثبيت عادي ديال llama.cpp.
هاد الشي مفيد إلا كان عندك موديل مكمّم وبغيتي تحسّن الجودة ديالو أو تكيّفو مع واحد النوع ديال الخدمة بلا ما تبدّل صيغة GGUF. الـ README كيوفّر موديل Qwen3.6-35B-A3B MACaQ-R على Hugging Face وكيذكر KL divergence أقل من ملف Unsloth UD-Q4_K_XL اللي تقارن معاه وبنفس الحجم المذكور.
باش تحسّن GGUF مكمّم ديال MoE، خصك تعطي الموديل المكمّم، والموديل الأصلي المطابق ديالو من Hugging Face، وملف teacher بصيغة FP16، ونص المعايرة، ومسار الإخراج، ومجلد الخدمة:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
من بعد ما تكمل عملية التحسين، حمّل الناتج باستعمال llama.cpp العادي:
llama cli -m models/model-macaq-r.ggufبالنسبة للـ workflow الكامل ديال MACaQ، بما فيه تحويلات التفعيلات، استعمل الدليل المرفق ديال runtime.
كمّم الموديلات وقدّمها باستعمال vLLM
Backend ديال vLLM كينشئ checkpoints مدمجة لموديلات النص، للاستعمال فالتوليد أو التقديم عبر HTTP. W4A4 هي وضعية الاستدلال الافتراضية، والـ backend كيدعم حتى quantization ديال الأوزان فقط.
حلّ دليل vLLM واختار الـ workflow ديال موديل نصي hybrid أو موديل نصي mixture-of-experts.
ثبّت backend ديال vLLM فبيئة Python 3.12 خاصة به.
وجد الموديل الأصلي وبيانات المعايرة المطلوبة فالوصفة المختارة.
شغّل أمر quantization الموثّق باش تنشئ checkpoint مدمج.
حمّل الـ checkpoint للتوليد محلياً أو شغّل خادم HTTP الموثّق.
الـ README كيشير لمقارنة Qwen3.8-27B، فين MACaQ W4A4 وصل لـ perplexity ديال 2.8994 مقارنة مع 2.8463 ديال BF16، مع تسجيل قياسات أسرع للـ prefill والـ decode فإعداد الاختبار المذكور.
كمّم مولّدات الكلام باستعمال PyTorch
Backend ديال PyTorch موجّه لتوليد الكلام وكيحفظ checkpoints بصيغة W4A4. منين كيتحفظ checkpoint، تقدر تحمّلو بلا ما تعاود المعايرة.
الـ workflows الموثّقة كتشمل Qwen3-TTS وChatterbox Turbo.
حلّ دليل PyTorch واختار موديل الكلام.
ثبّت dependencies ديال PyTorch المطلوبة فبيئة Python 3.12 مستقلة.
شغّل المعايرة وquantization باستعمال التعليمات الخاصة بالموديل.
حفظ checkpoint ديال W4A4.
حمّل checkpoint المحفوظ وولّد صوت WAV بلا ما تعاود المعايرة.
استعمل MACaQ مع عتاد Ascend
كيردّي CANN-related pull requests متاحة kernels ديال MACaQ W4A4 لضرب المصفوفات الكثيفة والمجمّعة. الـ README كيشير لـ kernels ديال PTO-ISA فـ pull request 12568 ديال ops-nn وkernels ديال TileLang مع backend ديال CCE فـ pull request 44 ديال ops-tilelang.
تبع تعليمات البناء فهاد المشاريع بالنسبة للإصدارات المتوافقة ديال CANN وPyTorch وtorch_npu. تشغيل الموديل كامل كيتطلب الدمج مع runtime ديال الاستدلال ديال Ascend.
نصائح عملية لتحسين الـ workflows
- طابق الـ backend مع الهدف ديال النشر. اختار GGUF وllama.cpp للاستدلال المحلي على النصوص وبشكل قابل للنقل، وvLLM لتقديم النصوص، وDiffusers للتوليد المتعدد الوسائط، وPyTorch لموديلات الكلام.
- استعمل وصفات خاصة بكل موديل. الموديلات dense وhybrid وmixture-of-experts تقدر تحتاج خطوات مختلفة فالتحضير والـ quantization.
- خلي بيانات المعايرة متوافقة مع الاستعمال. مثلاً، الـ workflow ديال Diffusers من الصورة للفيديو كيستعمل صور conditioning أثناء المعايرة.
- فصل البيئات. الـ README كيوصي بشكل صريح ببيئة مستقلة لكل backend وبـ Python 3.12.
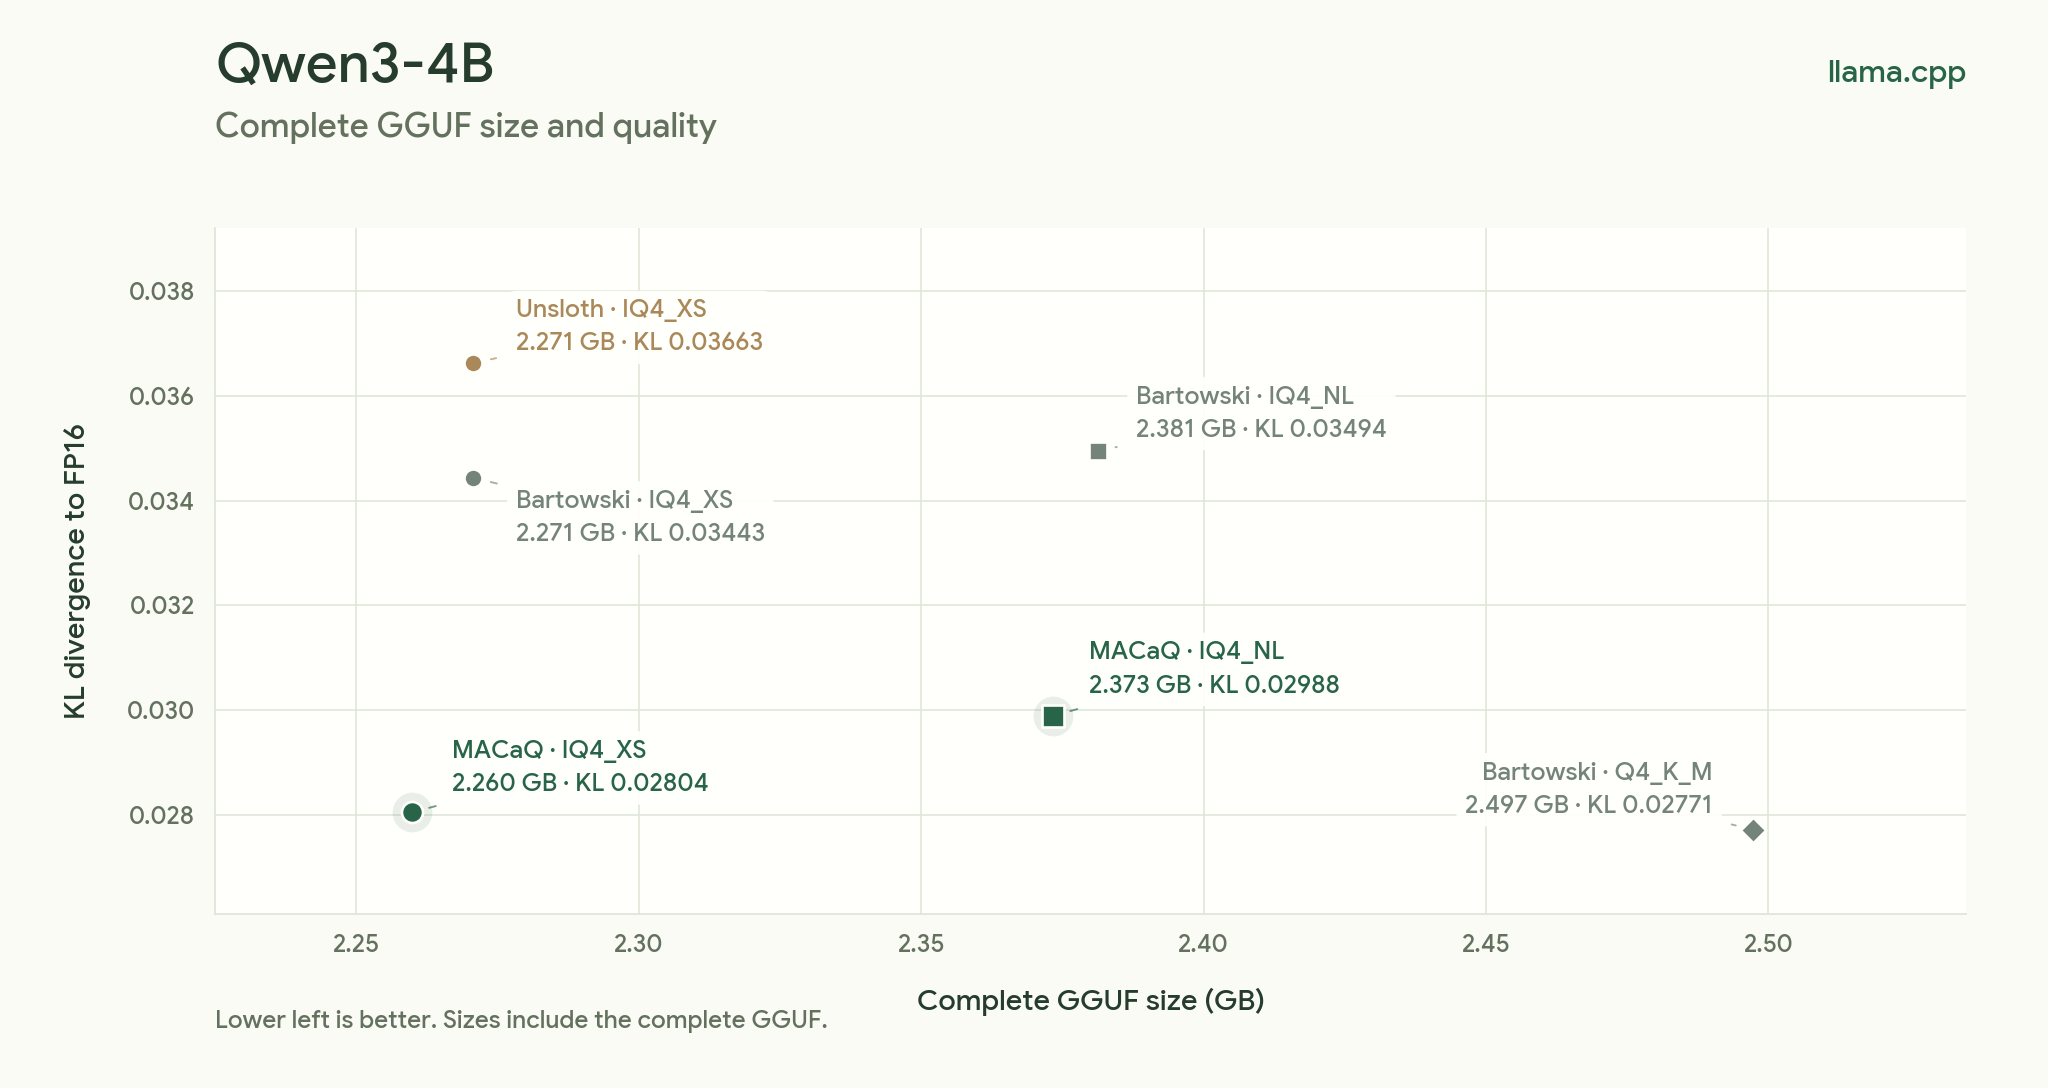
- قارن الجودة، ماشي غير حجم الملف. المشروع كيستعمل مقارنات perplexity وKL divergence لتقييم الموديلات المكمّمة مقابل FP16 أو طرق quantization أخرى.
- استعمل MACaQ-R إلا كان عندك GGUF من قبل. يقدر يحسّن ملف مكمّم موجود مع الحفاظ على التوافق العادي مع llama.cpp.
الخلاصة
MACaQ كيوفّر طريقة وحدة للتكميم عبر بزاف ديال أحمال العمل ديال الذكاء الاصطناعي، من نماذج النصوص GGUF لنماذج الصور والفيديو والصوت ديال Diffusers، وcheckpoints ديال الخدمة عبر vLLM، ومولّدات الكلام ديال PyTorch. بْدا بالـ README الخاص بالـ backend، واستعمل Python 3.12 فبيئة معزولة، وتّبع وصفة النموذج للمعايرة، ومن بعد تحقّق من checkpoint الناتج باستعمال runtime اللي ناوي تستعملو.
للبحث أو التوثيق التقني، شوف ورقة MACaQ. المشروع مرخّص بموجب رخصة Apache 2.0.