
টুল, সংবাদ ও টিউটোরিয়াল খুঁজুন
প্রকাশিত সব AI কনটেন্ট এক জায়গায় ঘুরে দেখুন।
“AI”এই শ্রেণিতে 922টি ফলাফল
AI টুলসমূহ
922 অ্যানিমেশন তৈরিWan-Animate-2 – 万相团队开源的新一代角色动画模型Wan-Animate-2 হলো 万相 টিমের ওপেন-সোর্স করা নতুন প্রজন্মের চরিত্র অ্যানিমেশন মডেল। Wan-Animate-এর একটি বড় আর্কিটেকচারাল আপগ্রেড হিসেবে এটি end-to-end দ্বৈত-শাখা DiT ব্যবহার করে এবং স্পষ্ট পোজ কঙ্কালের প্রয়োজন ছাড়াই রেফারেন্স ভিডিও থেকে মোশন prior ধারণ করতে পারে। এটি ড্রাইভিং ভিডিও থেকে চরিত্র অ্যানিমেশন, পরিচয় ও চেহারা সংরক্ষণ এবং টেক্সট-চালিত ভিউ নিয়ন্ত্রণ সমর্থন করে। এতে Base উচ্চমানের এবং Distillation কম-ধাপের দুটি ইনফারেন্স মোড রয়েছে। রিয়েল-টাইম স্ট্রিমিং চরিত্র অ্যানিমেশনের জন্য Lite ভ্যারিয়েন্টও প্রকাশ করা হয়েছে। মডেলটি ভার্চুয়াল অ্যাঙ্কর, শর্ট-ভিডিও নির্মাণ ও ডিজিটাল মানবসহ বিভিন্ন ক্ষেত্রে উপযোগী; এর লক্ষ্য একসঙ্গে মোশনের বিশ্বস্ততা ও পরিচয়ের সামঞ্জস্য বাড়ানো এবং জেনারেশন লেটেন্সি কমানো।
 এআই ভিডিও জেনারেশনHOMIEHOMIE হলো হংকং ইউনিভার্সিটি অব সায়েন্স অ্যান্ড টেকনোলজি ওপেন-সোর্স করা ডিজিটাল হিউম্যান ভিডিও জেনারেশন ফ্রেমওয়ার্ক, যা Wan2.1-T2V-14B ব্যাকবোন নেটওয়ার্কের ওপর ভিত্তি করে তৈরি এবং Qwen3-VL মাল্টিমোডাল বড় ভাষা মডেল সমন্বিত। ফ্রেমওয়ার্কটি ডিজিটাল হিউম্যান+পণ্য+Logo+টেক্সট—এই চারটি উপাদান একসঙ্গে প্রক্রিয়া করতে পারে, ...
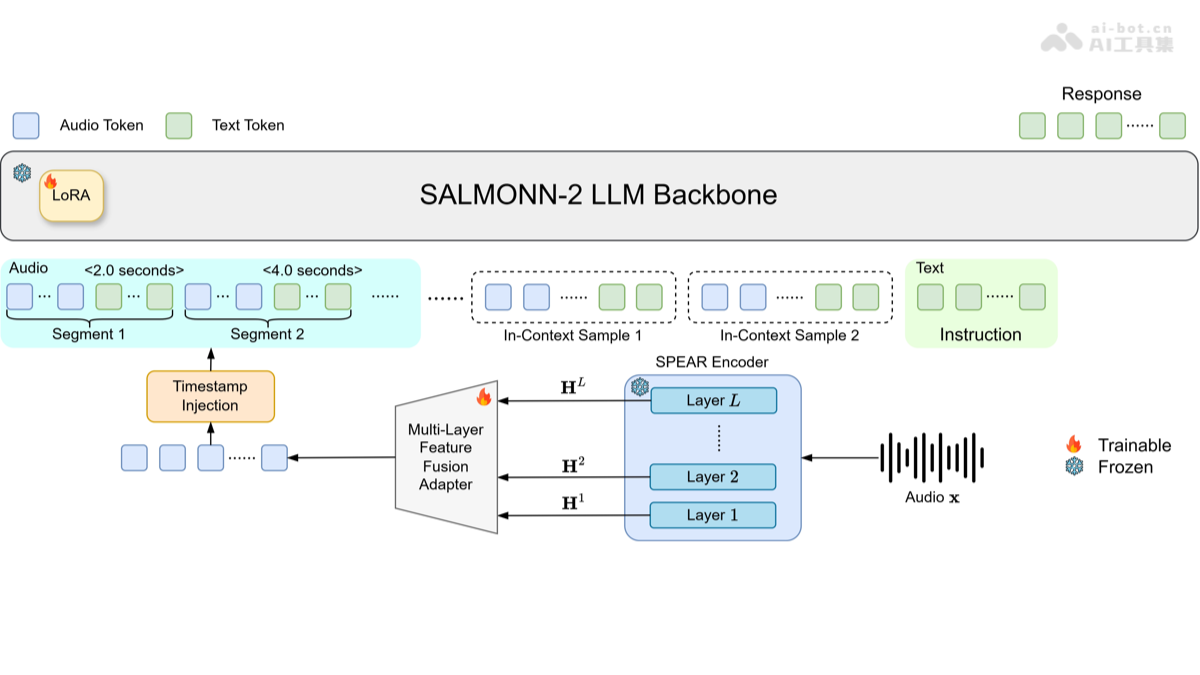 এআই প্রোগ্রামিংSALMONN-2 – ছিংহুয়া প্রভৃতি প্রতিষ্ঠানের উন্মুক্ত সাধারণ অডিও বৃহৎ ভাষা মডেলSALMONN-2 – ছিংহুয়া প্রভৃতি প্রতিষ্ঠানের উন্মুক্ত সাধারণ অডিও বৃহৎ ভাষা মডেল হলো বাইটড্যান্সের SPEAR একীভূত স্ব-তত্ত্বাবধানভিত্তিক অডিও এনকোডার ও বহুপদী বৈশিষ্ট্য-সমন্বয় অ্যাডাপ্টারের ওপর নির্মিত, Qwen3-কে টেক্সট ভিত্তি হিসেবে ব্যবহার করা একটি সাধারণ অডিও বৃহৎ ভাষা মডেল। এটি বক্তৃতা শনাক্তকরণ, অডিও বর্ণনা, সংগীত অনুধাবন, আবেগ শনাক্তকরণ, বক্তা যাচাইকরণসহ বিভিন্ন ক্ষেত্রের কাজ সমর্থন করে। পাশাপাশি, সাধারণ ALLM-এ প্রথমবারের মতো শব্দ-ঘটনা শনাক্তকরণ, অডিও জালিয়াতি শনাক্তকরণ, বক্তৃতার গুণমান মূল্যায়ন এবং বহুমাত্রিক প্রাসঙ্গিক বক্তৃতা শনাক্তকরণের মতো উন্নত সক্ষমতা পদ্ধতিগতভাবে বাস্তবায়ন করেছে। মডেলটি প্রচলিত দ্বৈত এনকোডার পদ্ধতির পরিবর্তে একটি একক SPEAR এনকোডার ব্যবহার করে এবং MLF অ্যাডাপ্টারের মাধ্যমে বহুস্তরের ধ্বনিতাত্ত্বিক বৈশিষ্ট্য একত্র করে, ফলে বিভিন্ন ক্ষেত্রে আরও ভারসাম্যপূর্ণ কর্মদক্ষতা অর্জন করে। মাত্র প্রায় 1.8万 ঘণ্টা তত্ত্বাবধানভিত্তিক ডেটায় দক্ষ প্রশিক্ষণের মাধ্যমে SALMONN-2 MMAU-Pro, MMAR ও MMSU—এই তিনটি সামগ্রিক বেঞ্চমার্কে একই আকারের উন্মুক্ত মডেলগুলোর মধ্যে সেরা ফল করেছে। এটি স্মার্ট মিটিং সহকারী, অডিও কনটেন্ট পর্যালোচনা এবং বক্তৃতার গুণমান পর্যবেক্ষণের মতো কাজে ব্যবহারযোগ্য।
 এআই ভয়েস সিন্থেসিসIndexTTS-2.5IndexTTS-2.5 হলো Bilibili-এর ওপেন-সোর্স করা শিল্পমানের জিরো-শট ভয়েস ক্লোনিং মডেল। এতে মাত্র 0.8B প্যারামিটার রয়েছে এবং চীনা, ইংরেজি, জাপানি, স্প্যানিশ ও আরবি ভাষায় আন্তভাষিক স্থানান্তর সমর্থন করে।