
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-10-08
01VoxMem কী
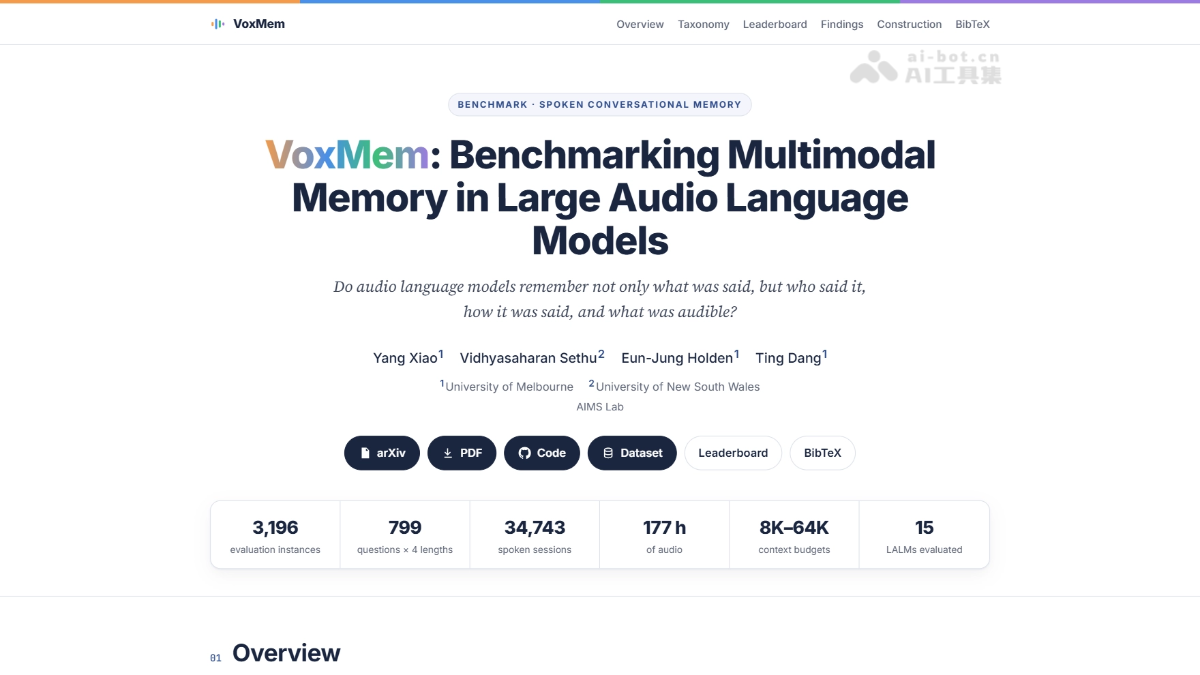
VoxMem হলো মেলবোর্ন বিশ্ববিদ্যালয় ও নিউ সাউথ ওয়েলস বিশ্ববিদ্যালয়ের দলের তৈরি অডিও বড় মডেলের মেমরি বেঞ্চমার্ক। এতে প্রথমবারের মতো ৪ ধরনের অ্যাকোস্টিক প্রমাণ—সেমান্টিক, বক্তা, স্বরভঙ্গি ও পরিবেশের শব্দ—× ৪ ধরনের মেমরি অপারেশন, অর্থাৎ নিষ্কাশন, সেশনজুড়ে যুক্তি, সময়ক্রমিক ট্র্যাকিং ও উত্তর দিতে অস্বীকৃতি—নিয়ে দ্বিমাত্রিক মূল্যায়ন কাঠামো তৈরি করা হয়েছে। এতে 8K থেকে 64K token পর্যন্ত বহু-সেশন ইতিহাস রয়েছে। ১৫টি মডেলের পরীক্ষায় দেখা গেছে, 32K-তে কোনো মডেলের সামগ্রিক নির্ভুলতা 40% ছাড়ায়নি। মডেল কী বলা হয়েছে তা মনে রাখতে পারলেও কে বলেছে বা কীভাবে বলা হয়েছে তা মনে রাখতে অসুবিধা হয়; শুধু অডিও কনটেক্সট বাড়ালেই দীর্ঘস্থায়ী ভয়েস ইন্টার্যাকশন সম্ভব হয় না।
02VoxMem-এর প্রধান বৈশিষ্ট্য
বহু-সেশন ভয়েস মেমরি মূল্যায়ন: বহু-সেশন ও বিভিন্ন দৈর্ঘ্যের ভয়েস ইতিহাসে বড় অডিও-ল্যাঙ্গুয়েজ মডেল আগের কথোপকথনের বিষয়বস্তু মনে রাখতে ও পুনরুদ্ধার করতে পারে কি না, তা পদ্ধতিগতভাবে পরীক্ষা করে।
চার ধরনের অ্যাকোস্টিক প্রমাণ: একই সঙ্গে ভয়েসের সেমান্টিক অর্থ, বক্তার পরিচয়, প্যারালিঙ্গুইস্টিক সংকেত ও পরিবেশের শব্দ মূল্যায়ন করে। শেষের তিন ধরনের তথ্য ট্রান্সক্রিপশন থেকে পুনরুদ্ধার করা যায় না এবং এগুলো “অডিও-নেটিভ” তথ্য।
চার ধরনের মেমরি অপারেশন: তথ্য নিষ্কাশন, বহু-সেশন যুক্তি, সময়ক্রমিক পরিবর্তন ট্র্যাকিং এবং পর্যাপ্ত প্রমাণ না থাকলে উত্তর দিতে অস্বীকৃতি—এই চারটি অপারেশন অন্তর্ভুক্ত। এগুলোর জোড়ায় ১৫টি কার্যকর মূল্যায়ন সেল তৈরি হয়।
নিয়ন্ত্রিত ইতিহাসের দৈর্ঘ্য: একই প্রশ্নে 8K/16K/32K/64K token-এর চার ধরনের ইতিহাস দৈর্ঘ্যে প্রমাণ সম্পূর্ণ অপরিবর্তিত থাকে; শুধু বিভ্রান্তিকর সেশন যোগ করা হয়। ফলে মেমরিতে দৈর্ঘ্যের প্রভাব আলাদাভাবে পরিমাপ করা যায়।
উন্মুক্ত মূল্যায়ন ব্যবস্থা: কোড ও ডেটা সম্পূর্ণ ওপেন সোর্স। মানসম্মত রান, স্কোরিং স্ক্রিপ্ট ও Leaderboard দেওয়া হয়েছে এবং API মডেল ও স্থানীয় মডেল উভয়ের পুনরুৎপাদন সমর্থিত।
03VoxMem-এর প্রযুক্তিগত নীতি
WeChat-এ “开源” লিখে রিপ্লাই করুন এবং AI ওপেন সোর্স প্রকল্পের আলোচনা গ্রুপে যোগ দিন
দ্বিমাত্রিক শ্রেণিবিন্যাস কাঠামো: VoxMem-এর মূল নকশা হলো অ্যাকোস্টিক প্রমাণ × মেমরি অপারেশনের একটি দ্বিমাত্রিক শ্রেণিবিন্যাস সারণি। অ্যাকোস্টিক প্রমাণ নির্ধারণ করে কী মনে রাখতে হবে; ভয়েস তথ্যকে সেমান্টিক, বক্তা, প্যারালিঙ্গুইস্টিক ও পরিবেশের শব্দ—এই চার ভাগে ভাগ করা হয়। মেমরি অপারেশন নির্ধারণ করে কীভাবে তা ব্যবহার করতে হবে: একক সেশন থেকে তথ্য পুনরুদ্ধার (IE), একাধিক সেশনজুড়ে প্রমাণ একত্র করা (MSR), সময়ের ক্রমে অবস্থার পরিবর্তন ট্র্যাক করা (TET), এবং পর্যাপ্ত প্রমাণ না থাকলে উত্তর দিতে অস্বীকৃতি (AR)। সেমান্টিক×IE সমন্বয়টি নিছক টেক্সট রিট্রিভ্যালে পরিণত হওয়ায় ইচ্ছাকৃতভাবে বাদ দেওয়া হয়েছে। বাকি ১৫টি সেল পূর্ণাঙ্গ মূল্যায়ন ক্ষেত্র তৈরি করে, যাতে অ্যাকোস্টিক মেমরি সক্ষমতা বিচ্ছিন্নভাবে নয়, পদ্ধতিগতভাবে পরীক্ষা করা যায়।
তিন ধাপে ডেটা নির্মাণ: ডেটা তৈরির পাইপলাইন হলো “পরিকল্পনা—কথোপকথন লেখা—ভয়েস সংশ্লেষণ”। প্রথমে প্রতিটি প্রশ্নের জন্য একটি কাঠামোবদ্ধ পরিকল্পনা তৈরি করা হয়, যেখানে প্রশ্ন, উত্তর, প্রমাণের বণ্টন ও বৈধতার শর্ত নির্ধারিত থাকে (; এরপর ব্যবহারকারী ও সহকারীর কথোপকথনের লেখা আলাদাভাবে তৈরি করা হয়। উভয় পক্ষই বক্তা, স্বরভঙ্গি বা পটভূমির শব্দ উল্লেখ করে না, যাতে উত্তর টেক্সট থেকে ফাঁস না হয়; সবশেষে TTS দিয়ে ভয়েস সংশ্লেষণ করা হয়। প্রতিটি ব্যবহারকারীর জন্য নির্দিষ্ট কণ্ঠস্বর রাখা হয়, স্টাইল নিয়ন্ত্রণের মাধ্যমে স্বরভঙ্গির সংকেত যোগ করা হয়, 10dB সিগন্যাল-টু-নয়েজ অনুপাতে পরিবেশের শব্দ মেশানো হয়, এবং সংকেতযুক্ত প্রতিটি টার্নের সংকেত-অপসারিত জোড়া সংস্করণ মান যাচাইয়ের জন্য সংরক্ষণ করা হয়।
বিভ্রান্তিকর সেশন ও দৈর্ঘ্য নিয়ন্ত্রণ: প্রতিটি ইতিহাসে প্রমাণ সেশন, বিভ্রান্তিকর সেশন ও পূরণকারী সেশন থাকে। বিভ্রান্তিকর সেশনগুলোর বিষয় প্রমাণ সেশনের কাছাকাছি হলেও মান আলাদা। টেক্সট-ভিত্তিক একটি শ্রেণিবিন্যাসকারী দিয়ে যাচাই করা হয়, যার নির্ভুলতা মাত্র 51–56%, যাতে মডেল শুধু পৃষ্ঠতলের বিষয় মিলিয়ে উত্তর খুঁজে না পায়। দৈর্ঘ্য নিয়ন্ত্রণে চারটি ইতিহাস স্তর কঠোরভাবে নেস্টেড থাকে; কেবল অপ্রাসঙ্গিক পূরণকারী সেশন যোগ করে ইতিহাস দীর্ঘ করা হয়। ফলে চার স্তরেই প্রশ্ন, উত্তর ও প্রমাণ সম্পূর্ণ একই থাকে এবং নির্ভুলতার পরিবর্তন কেবল ইতিহাস দীর্ঘ হওয়ার কারণে ঘটে; প্রশ্নের কঠিনতার মিশ্র প্রভাব বাদ পড়ে।
04VoxMem কীভাবে ব্যবহার করবেন
রিপোজিটরি ক্লোন করুন: GitHub থেকে কোড ডাউনলোড করে `git clone https://github.com/swagshaw/voxmem` চালান এবং প্রকল্প ডিরেক্টরিতে প্রবেশ করুন।
নির্ভরতা ইনস্টল করুন: `pip install -r requirements.txt` চালান। চাইলে `pip install "datasets"` ইনস্টল করলে অডিও স্বয়ংক্রিয়ভাবে অ্যারেতে ডিকোড হবে।
API কী কনফিগার করুন: API মডেল মূল্যায়ন করতে সংশ্লিষ্ট SDK ইনস্টল করে কী সেট করুন, যেমন `pip install openai`-এর পর `export OPENAI_API_KEY=`।
স্মোক টেস্ট চালান: প্রথমে `python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl` চালিয়ে প্রক্রিয়াটি যাচাই করুন। এরপর `score_voxmembench.py --judge exact-match` দিয়ে স্কোর করুন এবং নিশ্চিত করুন যে অস্বীকৃতি স্তরটি অস্বীকৃতির প্রশ্নে 1.0 ও উত্তরযোগ্য প্রশ্নে 0.0 পায়।
আনুষ্ঠানিক মূল্যায়ন: কনফিগারেশন, যেমন 32k পূর্ণ সেট বা 32k_speaker_information সাবসেট, এবং লক্ষ্য মডেল নির্বাচন করে চালান। উদাহরণ: `python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl`; স্থানীয় মডেলের জন্য `--adapter` দিয়ে কাস্টম অ্যাডাপ্টার ফাংশন এবং `--model-dir` দিয়ে ওজনের ডিরেক্টরি নির্দিষ্ট করতে হবে।
LLM বিচারকের স্কোরিং: `python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json` চালান। বিচারক শুধু প্রশ্ন, মানক উত্তর ও প্রদত্ত উত্তর দেখে উন্মুক্ত উত্তরের সমতুল্যতা নির্ধারণ করেন।
05VoxMem-এর মূল সুবিধা
অডিও-নেটিভ মেমরির প্রথম পদ্ধতিগত কভারেজ: বিদ্যমান বেঞ্চমার্কের শুধু শব্দগত বিষয়বস্তু পরীক্ষার সীমাবদ্ধতা অতিক্রম করে, কে বলেছে, কীভাবে বলেছে এবং কী শোনা গেছে—এ ধরনের অ-পাঠ্য অ্যাকোস্টিক তথ্যকে প্রথমবারের মতো একই মূল্যায়ন কাঠামোয় অন্তর্ভুক্ত করে।
দ্বিমাত্রিক শ্রেণিবিন্যাসের কঠোর নকশা: ৪ ধরনের অ্যাকোস্টিক প্রমাণ × ৪ ধরনের মেমরি অপারেশনের ১৫টি কার্যকর সেল ব্যবহার করে বিচ্ছিন্ন প্রশ্নের পরিবর্তে ভয়েস মেমরি সক্ষমতাকে পূর্ণাঙ্গ ও স্বাধীনভাবে বিশ্লেষণ করা হয়।
বহু-সেশন সেটআপ বাস্তব পরিস্থিতির কাছাকাছি: মানুষ ও মেশিনের ভয়েস ইন্টার্যাকশনে সময়জুড়ে হওয়া একাধিক সেশন অনুকরণ করে। এটি একটানা দীর্ঘ মনোলগ নয়; বরং বারবার উপস্থিত বক্তা ও অবস্থার পরিবর্তন সম্পর্কে মডেলের দীর্ঘমেয়াদি মেমরি পরীক্ষা করে।
দৈর্ঘ্যের প্রভাব সম্পূর্ণ আলাদা করা: একই প্রশ্নে 8K থেকে 64K পর্যন্ত চার ধরনের ইতিহাস দৈর্ঘ্যে প্রমাণ কঠোরভাবে নেস্টেড ও অপরিবর্তিত থাকে। প্রথমবারের মতো “ইতিহাস দীর্ঘ হওয়ার” প্রভাবকে প্রশ্নের কঠিনতা ও প্রমাণের ধরন থেকে cleanly আলাদা করা হয়েছে।
ফাঁস প্রতিরোধী নির্মাণ ও দ্বৈত মান যাচাই: কথোপকথনের কোনো পক্ষই অ্যাকোস্টিক সংকেত উল্লেখ করে না, জোড়া সংস্করণে তুলনা করা হয় এবং দুই ধাপের মান যাচাইয়ে ট্রান্সক্রিপশন পড়েই সমাধানযোগ্য প্রশ্ন বাদ দেওয়া হয়। ফলে প্রশ্নের উত্তর দিতে সত্যিই “শুনতে” হয়, শুধু “পড়লেই” চলে না।
বিভ্রান্তিকর নকশায় শর্টকাট কঠিন: কাছাকাছি বিষয় কিন্তু ভিন্ন মানের বিভ্রান্তিকর সেশন ব্যবহার করা হয় এবং মাত্র 51–56% নির্ভুলতার টেক্সট শ্রেণিবিন্যাসকারী দিয়ে যাচাই করা হয়, ফলে কীওয়ার্ড মিলিয়ে উত্তর খোঁজার শর্টকাট বন্ধ হয়।
06VoxMem-এর প্রকল্পের ঠিকানা
প্রকল্পের ওয়েবসাইট: https://swagshaw.github.io/voxmem/
GitHub রিপোজিটরি: https://github.com/swagshaw/voxmem
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/datasets/AudioMemory/voxmembench
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2609.32607
07VoxMem-এর প্রয়োগের ক্ষেত্র
ভয়েস অ্যাসিস্ট্যান্ট/স্মার্ট স্পিকারের দীর্ঘমেয়াদি মেমরি সক্ষমতা নির্বাচন: নির্মাতারা VoxMem ব্যবহার করে প্রার্থী মডেল ব্যবহারকারীর পছন্দ, পরিবারের সদস্যদের কণ্ঠস্বর ও আগের প্রতিশ্রুতি সেশনজুড়ে মনে রাখতে পারে কি না, তা একীভূতভাবে পরীক্ষা করতে পারবেন। এতে সিস্টেম চালুর পর “গত সপ্তাহে বলা কথাও সঙ্গে সঙ্গে ভুলে যাওয়ার” সমস্যা এড়ানো যায়।
গাড়ি ও পরিধানযোগ্য ডিভাইসের ভয়েস ইন্টার্যাকশন মূল্যায়ন: গাড়ির ভেতরের পরিবেশের শব্দ বেশি এবং ব্যবহারকারীর স্বরভঙ্গি পরিবর্তনশীল। VoxMem-এর পরিবেশের শব্দ ও প্যারালিঙ্গুইস্টিক সংকেতের মাত্রা বাস্তব শব্দদূষণপূর্ণ পরিস্থিতিতে মডেলের মেমরির নির্ভরযোগ্যতা পরীক্ষা করতে পারে।
বহু-বক্তার কাস্টমার সার্ভিস ও মিটিং সিস্টেমের মান যাচাই: কাস্টমার সার্ভিস সেন্টার ও মিটিং মিনিটসের মতো পরিস্থিতিতে কোন কথা কে বলেছেন তা সঠিকভাবে যুক্ত করতে হয়। VoxMem-এর বক্তা-সংযুক্তি ও ভুল অ্যাট্রিবিউশনের মূল্যায়ন এই ধরনের সিস্টেমের “ভুল ব্যক্তির নামে কথা বসিয়ে দেওয়া” সমস্যা নির্ণয়ে সরাসরি ব্যবহার করা যায়।
সঙ্গী রোবট ও প্রবীণ-সহায়তা পণ্যে আবেগের মেমরি যাচাই: গত সপ্তাহে কোনো প্রবীণ দীর্ঘশ্বাস ফেলে যে কথা বলেছেন বা কণ্ঠে যে ক্লান্তি প্রকাশ পেয়েছে, তা কেবল প্যারালিঙ্গুইস্টিক সংকেত বহন করতে পারে। VoxMem-এর সময়ক্রমিক ট্র্যাকিং মাত্রা পরীক্ষা করতে পারে পণ্যটি সময়ের সঙ্গে অবস্থার পরিবর্তন বুঝতে পারছে কি না।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0