
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-09-24
01Qwen-Audio-3.1 কী
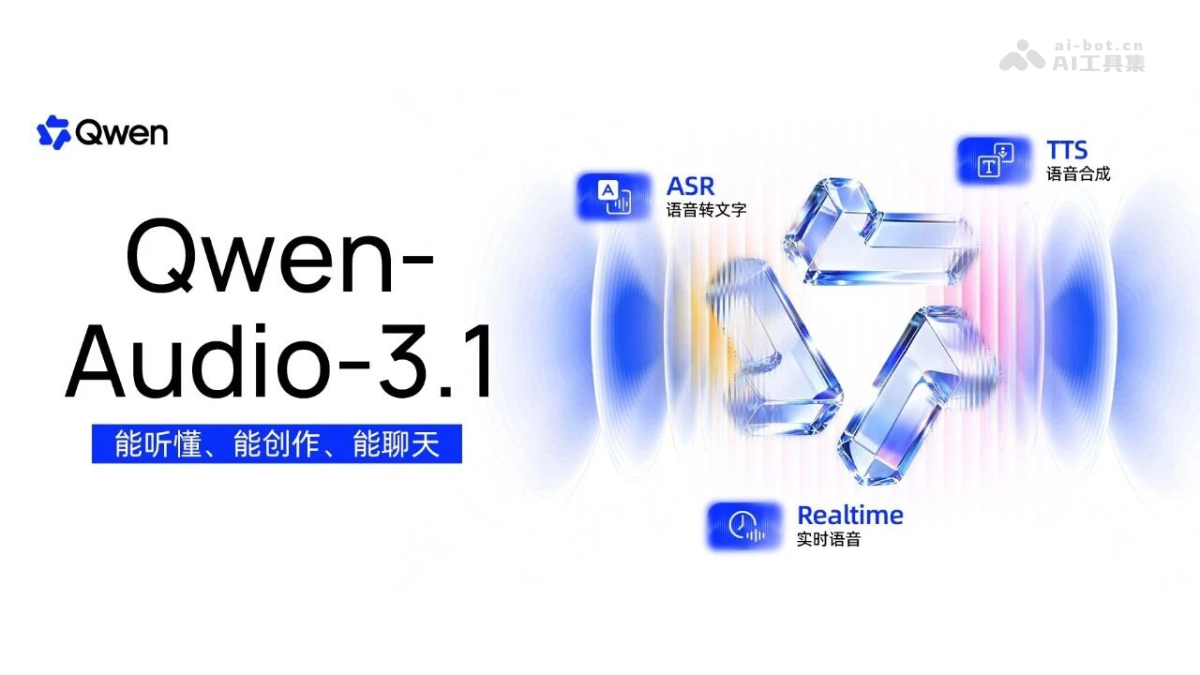
Qwen-Audio-3.1 হলো টংই শিয়েনের প্রকাশিত স্পিচ ফাউন্ডেশন মডেল সিরিজ, যাতে পাঁচটি মডেল রয়েছে: ASR স্পিচ রিকগনিশন, ASR-Next অডিও বোঝাপড়া, TTS স্পিচ সংশ্লেষণ, TTS-Next অডিও তৈরি এবং Realtime রিয়েল-টাইম ইন্টারঅ্যাকশন। এটি বোঝাপড়া-উৎপাদন-ইন্টারঅ্যাকশন-সৃষ্টির সম্পূর্ণ ধারাকে কভার করে। Qwen-Audio-3.1 30টি ভাষা ও 16টি উপভাষা সমর্থন করে, বক্তাভিত্তিক ট্রান্সক্রিপশন, আবেগ শনাক্তকরণ ও ফুল-ডুপ্লেক্স রিয়েল-টাইম কথোপকথন চালাতে পারে এবং কাজ সম্পন্ন করতে টুল ব্যবহার করতে পারে।
02Qwen-Audio-3.1-এর প্রধান বৈশিষ্ট্য
ASR স্পিচ রিকগনিশন: 30টি ভাষা ও 16টি চীনা উপভাষায় বক্তাভিত্তিক ট্রান্সক্রিপশন সমর্থন করে, যেখানে বক্তার লেবেল ও টাইমস্ট্যাম্প থাকে এবং টেক্সট স্বয়ংক্রিয়ভাবে পরিমার্জন করা যায়।
ASR-Next অডিও বোঝাপড়া: ট্রান্সক্রাইব করা লেখা থেকে এগিয়ে মানুষের আবেগ, পরিবেশের শব্দ ও যান্ত্রিক শব্দ বোঝে; শব্দের বর্ণনা, ঘটনা শনাক্তকরণ এবং অডিও প্রশ্নোত্তর সমর্থন করে।
TTS স্পিচ সংশ্লেষণ: বহুভাষিক ও বহুউপভাষিক সংশ্লেষণ সমর্থন করে, একই কণ্ঠস্বরকে বিভিন্ন ভাষায় স্বাভাবিকভাবে রূপান্তর করতে পারে এবং নির্দেশের মাধ্যমে আবেগ ও বলার গতি নিয়ন্ত্রণ করা যায়।
TTS-Next অডিও তৈরি: একবারে কণ্ঠ, সাউন্ড ইফেক্ট ও পরিবেশের শব্দ মিলিয়ে সম্পূর্ণ অডিও তৈরি করে; পডকাস্ট, অডিওবুক, চলচ্চিত্র, গেম ও বিজ্ঞাপনের জন্য উপযোগী।
Realtime রিয়েল-টাইম ইন্টারঅ্যাকশন: ফুল-ডুপ্লেক্সে একইসঙ্গে শোনা ও বলা, আবেগ ও অভিপ্রায় বোঝা, বহুভাষা পরিবর্তন এবং কথোপকথনের মধ্যে টুল ব্যবহার করে কাজ সম্পন্ন করা সমর্থন করে।
03Qwen-Audio-3.1-এর প্রযুক্তিগত নীতি
এন্ড-টু-এন্ড যৌথ মডেলিং (ASR): Qwen-Audio-3.1-ASR এন্ড-টু-এন্ড পদ্ধতি ব্যবহার করে বক্তার লেবেল, টাইমস্ট্যাম্প ও ট্রান্সক্রিপশন একসঙ্গে আউটপুট দেয়; প্রচলিত ক্যাসকেড সিস্টেমের ধাপে ধাপে প্রক্রিয়ার পরিবর্তে এটি ছোট বিরতি ও একসঙ্গে উচ্চারিত শব্দ ধরে রাখতে পারে। মডেলটিতে ফিলার শব্দ অপসারণ, পুনরাবৃত্তি দূর করা, স্বয়ং-সংশোধন ও অর্থগত পুনর্গঠনের ক্ষমতাও রয়েছে, ফলে ট্রান্সক্রিপশন সরাসরি সভার নোট ও কথোপকথন বিশ্লেষণে ব্যবহারযোগ্য হয়।
পরবর্তী প্রজন্মের অডিও বোঝাপড়ার আর্কিটেকচার (ASR-Next): ASR-Next পরবর্তী প্রজন্মের আর্কিটেকচারের ওপর ভিত্তি করে তৈরি। এটি প্রক্রিয়াকরণের বিষয়কে “কথনের ভেতরের শব্দ” থেকে সম্পূর্ণ অডিও সিগন্যালে বিস্তৃত করে। শব্দের আবেগ, পরিবেশের শব্দ ও যান্ত্রিক শব্দ বোঝার মাধ্যমে এটি শব্দঘটনা শনাক্ত, বর্ণনা ও বিশ্লেষণ করে; এর ফলে ASR ট্রান্সক্রিপশন টুল থেকে সাধারণ অডিও বোঝাপড়ার মডেলে উন্নীত হয়েছে।
কণ্ঠস্বর স্থানান্তর ও প্রকাশভঙ্গি নিয়ন্ত্রণ (TTS): TTS মডেল কেবল শব্দের উচ্চারণ সঠিক রাখার প্রচলিত সংশ্লেষণ পদ্ধতির সীমা অতিক্রম করেছে। একই কণ্ঠস্বরকে বিভিন্ন ভাষা ও উপভাষায় স্বাভাবিকভাবে স্থানান্তর করার পাশাপাশি নির্দেশের মাধ্যমে আবেগ, বলার গতি ও প্রকাশভঙ্গি মডেল করে, যাতে সংশ্লেষিত কণ্ঠ বিষয়বস্তু ও পরিস্থিতির সঙ্গে সামঞ্জস্যপূর্ণ হয়।
ঐক্যবদ্ধ অডিও তৈরি (TTS-Next): TTS-Next টেক্সট, টাইমস্ট্যাম্প ও রেফারেন্স অডিও—এই তিন ধরনের ইনপুটের ভিত্তিতে কণ্ঠ, সাউন্ড ইফেক্ট ও পরিবেশের শব্দ একসঙ্গে তৈরি করে। বহু-পর্বের কথোপকথনে বিভিন্ন চরিত্রের কণ্ঠস্বর ও আবেগের সামঞ্জস্য বজায় রাখে এবং প্রাকৃতিক ভাষার মাধ্যমে তৈরির প্রক্রিয়া নিয়ন্ত্রণ করে। এটি সূক্ষ্ম টাইমস্ট্যাম্প নিয়ন্ত্রণ, কণ্ঠস্বর পুনর্নির্মাণ এবং 48kHz উচ্চমানের আউটপুট সমর্থন করে।
বহু-শিক্ষক ডিস্টিলেশনভিত্তিক ফুল-ডুপ্লেক্স আর্কিটেকচার (Realtime): Realtime বহু-শিক্ষক ডিস্টিলেশন আর্কিটেকচার ব্যবহার করে। কম লেটেন্সি বজায় রেখেও এটি বোঝাপড়া, যুক্তি, প্রকাশ ও নিরাপত্তার সক্ষমতা বাড়ায় এবং ফুল-ডুপ্লেক্স ইন্টারঅ্যাকশন প্রদান করে, যেখানে একইসঙ্গে বলা ও শোনা যায় এবং যেকোনো সময় কথা থামিয়ে দেওয়া যায়। মডেলটি টুল কলিং ক্ষমতা একীভূত করেছে, তাই চলমান কথোপকথনে পরিবর্তিত প্রয়োজন বুঝে বাহ্যিক API, জ্ঞানভান্ডার ও ব্যবসায়িক সিস্টেমের সঙ্গে সংযোগ করে কাজ সম্পন্ন করতে পারে।
04Qwen-Audio-3.1 কীভাবে ব্যবহার করবেন
Qwen AI প্ল্যাটফর্ম খুলুন: https://www.qianwenai.com/ ঠিকানায় গিয়ে অ্যাকাউন্টে লগইন করুন এবং মডেল স্কোয়ারে প্রবেশ করুন।
প্রয়োজনীয় মডেল বেছে নিন: চাহিদা অনুযায়ী ASR (ট্রান্সক্রিপশন), TTS (সংশ্লেষণ), TTS-Next (সৃষ্টি) অথবা Realtime (রিয়েল-টাইম ইন্টারঅ্যাকশন) নির্বাচন করে বিস্তারিত পৃষ্ঠায় প্রবেশ করুন।
API Key সংগ্রহ করুন: কনসোলে মডেল পরিষেবা চালু করে একটি API Key তৈরি করুন, যা API প্রমাণীকরণে ব্যবহৃত হবে।
API কল করুন: সংশ্লিষ্ট মডেলের বিস্তারিত পৃষ্ঠার API ডকুমেন্টেশন অনুসরণ করে HTTP অনুরোধের মাধ্যমে অডিও বা টেক্সট প্যারামিটার পাঠান (ASR-Next API এখনও চালু হয়নি, উন্মুক্ত হওয়ার জন্য অপেক্ষা করতে হবে)।
অ্যাপ্লিকেশনে সংযুক্ত করুন: API-টি নিজের অ্যাপ্লিকেশন, Agent অথবা স্মার্ট হার্ডওয়্যারে সংযুক্ত করলে অনলাইনে স্পিচ-সংক্রান্ত কাজ সম্পন্ন করা যাবে।
05Qwen-Audio-3.1-এর মূল সুবিধা
বহুভাষা ও উপভাষায় শক্তিশালী: একটি মডেল 30টি ভাষা ও 16টি চীনা উপভাষা সমর্থন করে; ওয়েনঝৌ উপভাষার মতো কঠিন উপভাষা শনাক্তকরণে বিশেষ উন্নতি দেখা যায়।
বুদ্ধিমান ট্রান্সক্রিপশন পরিমার্জন: ASR স্বয়ংক্রিয়ভাবে ফিলার শব্দ ও পুনরাবৃত্তি সরিয়ে অর্থগত পুনর্গঠন করে, ফলে আরও সাবলীল, যৌক্তিক ও কাঠামোবদ্ধ টেক্সট পাওয়া যায়।
বক্তাভিত্তিক উচ্চনির্ভুল ট্রান্সক্রিপশন: এন্ড-টু-এন্ড পদ্ধতিতে বক্তার লেবেল, টাইমস্ট্যাম্প ও টেক্সট আউটপুট দেয়, যা Fun-ASR ক্যাসকেড সিস্টেমের তুলনায় সামগ্রিকভাবে উন্নত।
উন্নত অডিও বোঝাপড়া: ASR-Next আবেগ, পরিবেশের শব্দ ও যান্ত্রিক শব্দ বুঝতে পারে; এটি “ট্রান্সক্রাইব করা লেখা” থেকে “সম্পূর্ণ অডিও বোঝার” পর্যায়ে উন্নীত হয়েছে।
সমন্বিত সৃষ্টিশীলতা: TTS-Next একবারে কণ্ঠ, সাউন্ড ইফেক্ট ও পরিবেশের শব্দ তৈরি করে এবং বহু চরিত্রের কণ্ঠস্বর ও আবেগের সামঞ্জস্য বজায় রাখে, ফলে আলাদা আলাদা পোস্ট-প্রোডাকশন কাজের প্রয়োজন কমে।
মানবসদৃশ রিয়েল-টাইম ইন্টারঅ্যাকশন: ফুল-ডুপ্লেক্সে শোনা ও বলা একসঙ্গে হয়, কথা থামিয়ে দেওয়া যায়, আবেগ বোঝা যায় এবং টুল ব্যবহার করে কাজ সম্পন্ন করা যায়।
কম লেটেন্সি ও উচ্চ কর্মক্ষমতা: স্ট্রিমিং রিকগনিশনে প্রথম অক্ষরের প্রতিক্রিয়া প্রায় 160 মিলিসেকেন্ডে আসে; Realtime বহু-শিক্ষক ডিস্টিলেশনের মাধ্যমে কম লেটেন্সি ও যুক্তি করার ক্ষমতার ভারসাম্য বজায় রাখে।
06Qwen-Audio-3.1-এর প্রকল্পের ঠিকানা
অনলাইন ডেমো: Qwen-Audio-3.1-ASR:https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS:https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next:https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime:https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07Qwen-Audio-3.1-এর ব্যবহারক্ষেত্র
সভা-সারাংশ ও সাক্ষাৎকারের রেকর্ড: ASR-এর বক্তাভিত্তিক ট্রান্সক্রিপশন ও টাইমস্ট্যাম্প ব্যবহার করে স্বয়ংক্রিয়ভাবে “কে কখন কী বলেছে” ধরনের কাঠামোবদ্ধ রেকর্ড তৈরি করা যায়। কথ্য ভাষার অপ্রয়োজনীয় অংশ স্বয়ংক্রিয়ভাবে পরিমার্জিত হওয়ায় সভার দক্ষতা উল্লেখযোগ্যভাবে বাড়ে।
পডকাস্ট ও অডিওবুক তৈরি: TTS-Next ব্যবহার করে একবারে বহুজনের সংলাপ, সাউন্ড ইফেক্ট ও পরিবেশের শব্দসহ সম্পূর্ণ অডিও তৈরি করা যায়। বহু চরিত্রের কণ্ঠস্বর ও আবেগের সামঞ্জস্য বজায় থাকে, ফলে উপস্থাপক, সাউন্ড ইঞ্জিনিয়ার ও মিক্সিং ইঞ্জিনিয়ারের আলাদা সমন্বয় প্রয়োজন হয় না।
রিয়েল-টাইম ভয়েস কাস্টমার সার্ভিস/স্মার্ট অ্যাসিস্ট্যান্ট: Realtime-এর ফুল-ডুপ্লেক্স ইন্টারঅ্যাকশন ও আবেগ শনাক্তকরণ ক্ষমতার ভিত্তিতে এমন ভয়েস কাস্টমার সার্ভিস তৈরি করা যায়, যাকে থামানো যায় এবং যা সহানুভূতিশীলভাবে সাড়া দেয়। এটি কথোপকথনের মধ্যেই ব্যবসায়িক সিস্টেম ব্যবহার করে অনুসন্ধান, অর্ডারসহ বিভিন্ন কাজ সম্পন্ন করতে পারে।
আন্তঃসীমান্ত ভ্রমণ ও বহুভাষিক যোগাযোগ: 30টি ভাষায় রিয়েল-টাইম পরিবর্তন এবং একই কণ্ঠস্বরকে বিভিন্ন ভাষায় সংশ্লেষণের ক্ষমতা ব্যবহার করে ভ্রমণ পরিকল্পনা, আন্তঃসীমান্ত ই-কমার্স ও আন্তর্জাতিক সভায় স্বাভাবিক ও সাবলীল ভয়েস অনুবাদ এবং যোগাযোগের অভিজ্ঞতা দেওয়া যায়।
AI স্মার্ট হার্ডওয়্যার: QwenNote, Qwen AI চশমার মতো হার্ডওয়্যারের সঙ্গে যুক্ত হয়ে ব্যবহারকারী কম্পিউটার বা ফোন না খুলেই সরাসরি ভয়েসে কাজ শুরু, শর্ত যোগ ও অগ্রগতি অনুসরণ করতে পারেন; ফলে ভয়েস AI হার্ডওয়্যারের স্বাভাবিক প্রবেশপথে পরিণত হয়।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0