
- মাসিক ভিজিট
- 0
- মূল্য
- সেট করা হয়নি
- তালিকাভুক্ত
- —
- আপডেট করা হয়েছে
- 2026-09-14
01Xiaomi-CocktailASR-1 কী
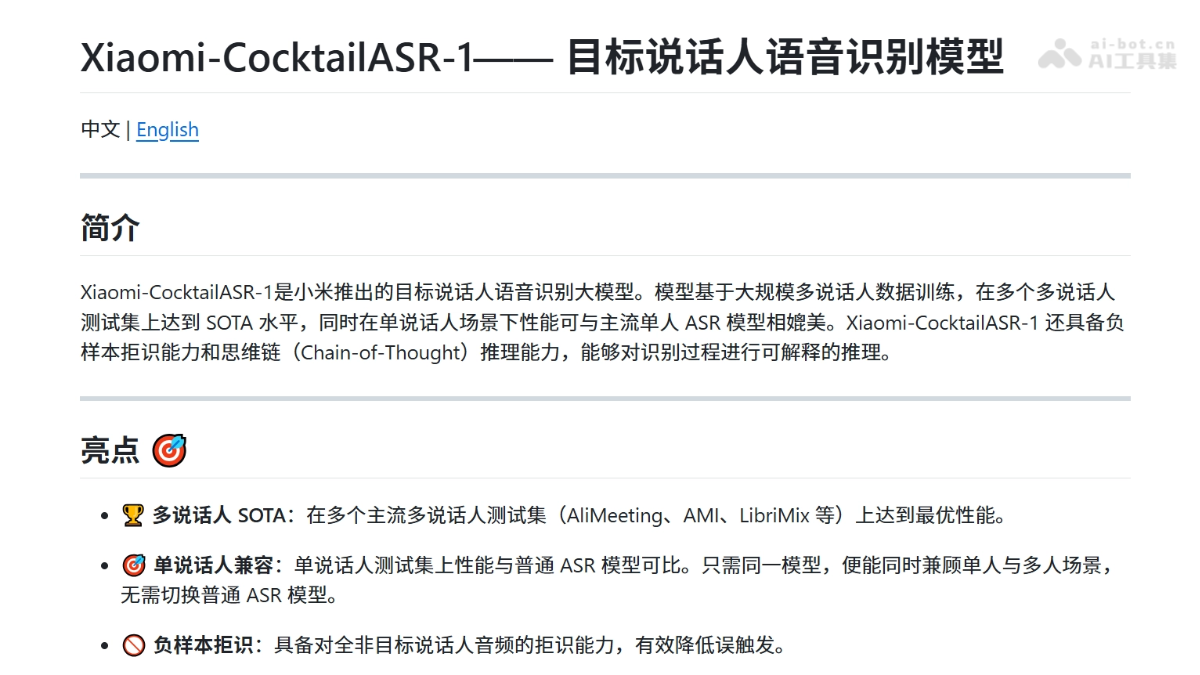
Xiaomi-CocktailASR-1 হলো Xiaomi-এর ওপেন-সোর্স করা টার্গেট স্পিকার স্পিচ রিকগনিশনের একটি বড় মডেল। LLM এন্ড-টু-এন্ড আর্কিটেকচারের ওপর ভিত্তি করে এটি রেফারেন্স স্পিচকে স্পিকার-ভয়েসপ্রিন্ট প্রম্পট হিসেবে ব্যবহার করে। স্পিচ সেপারেশন ছাড়াই একাধিক ব্যক্তির মিশ্রিত অডিও থেকে নির্দিষ্ট বক্তার কথা নির্ভুলভাবে ট্রান্সক্রাইব করতে পারে। একাধিক বক্তার বেঞ্চমার্কে মডেলটি SOTA পর্যায়ে পৌঁছেছে এবং একক বক্তার ক্ষেত্রেও সামঞ্জস্যপূর্ণ। এতে নেগেটিভ স্যাম্পল প্রত্যাখ্যান এবং চেইন-অব-থট ব্যাখ্যাযোগ্য রিজনিং ক্ষমতা রয়েছে। এটি Apache 2.0 লাইসেন্সে ওপেন-সোর্স করা হয়েছে।
02Xiaomi-CocktailASR-1-এর প্রধান বৈশিষ্ট্য
টার্গেট স্পিকার স্পিচ রিকগনিশন: একটি রেফারেন্স অডিও এবং একাধিক বক্তার মিশ্রিত অডিও দিলে স্পিচ সেপারেশন ছাড়াই সরাসরি নির্দিষ্ট বক্তার কথা ট্রান্সক্রাইব করে।
একক বক্তার সঙ্গে সামঞ্জস্য: একই মডেল একক বক্তার পরিস্থিতিও পরিচালনা করতে পারে এবং মডেল পরিবর্তন ছাড়াই প্রচলিত একক-বক্তা ASR-এর কাছাকাছি কর্মক্ষমতা দেয়।
নেগেটিভ স্যাম্পল প্রত্যাখ্যান: অডিওতে টার্গেট স্পিকার না থাকলে খালি টেক্সট আউটপুট দেয়, ফলে ভুল ট্রিগার কার্যকরভাবে কমে।
চেইন-অব-থট রিজনিং: CoT মোডে বক্তার সংখ্যা, লিঙ্গ, ভয়েসপ্রিন্টের সাদৃশ্যসহ রিজনিং প্রক্রিয়া আউটপুট দেয়, যা ব্যাখ্যাযোগ্যতা ও শনাক্তকরণের নির্ভুলতার সমন্বয় ঘটায়।
03Xiaomi-CocktailASR-1-এর প্রযুক্তিগত নীতি
এন্ড-টু-এন্ড একীভূত আর্কিটেকচার: মডেলটি তিনটি অংশ নিয়ে গঠিত: Data2Vec2-এর উন্নত সংস্করণভিত্তিক 0.6B অডিও এনকোডার, একটি হালকা Linear Adapter এবং Qwen3-8B বড় ভাষা মডেল ব্যাকবোন। ইনপুট «রেফারেন্স স্পিচ + 1 সেকেন্ড নীরবতা + মিশ্রিত স্পিচ» ক্রমে সংযুক্ত করা হয়। এনকোডার ফ্রেম-স্তরের বৈশিষ্ট্য বের করার পর Adapter সেগুলোকে LLM-এর হিডেন স্পেসের সঙ্গে সামঞ্জস্য করে এবং টেক্সট Prompt-এর সঙ্গে LLM-এ পাঠিয়ে টার্গেট স্পিকারের ট্রান্সক্রিপশন তৈরি করে।
রেফারেন্স স্পিচ কন্ডিশনাল প্রম্পট হিসেবে: এনকোডারটি Data2Vec2-এর স্ব-তত্ত্বাবধানে মাস্কড প্রেডিকশন পদ্ধতি ব্যবহার করে একটি একক নেটওয়ার্কে অর্থবোধক তথ্য ও বক্তার তথ্য একত্রিত করে; আলাদা ভয়েসপ্রিন্ট এনকোডারের প্রয়োজন হয় না। রেফারেন্স স্পিচকে কন্ডিশনাল Prompt হিসেবে বিবেচনা করা হয়, ফলে বৈশিষ্ট্য আহরণের পর্যায়েই এনকোডার স্বয়ংক্রিয়ভাবে টার্গেট স্পিকারের ওপর মনোযোগ কেন্দ্রীভূত করে এবং বিঘ্নকারী স্পিচ দমন করে। এতে প্রচলিত «সেপারেশন+রিকগনিশন» ক্যাসকেড সিস্টেমের ত্রুটি সঞ্চয় শুরু থেকেই এড়ানো যায়।
বহু সক্ষমতার ভারসাম্যপূর্ণ বহু-পর্যায়ের প্রশিক্ষণ: প্রায় এক মিলিয়ন ঘণ্টার ডেটা অনুপাতে প্রশিক্ষণের মাধ্যমে চারটি সক্ষমতা একীভূত করা হয়: প্রায় 40万 ঘণ্টা একাধিক বক্তার ডেটা দিয়ে টার্গেট এক্সট্রাকশন প্রশিক্ষণ, প্রায় 60万 ঘণ্টা একই বক্তার রেফারেন্স-টার্গেট জোড়া দিয়ে একক-পরিস্থিতিতে অতিরিক্ত দমন রোধ, প্রায় 1万 ঘণ্টা ভুলভাবে মেলানো রেফারেন্সের নেগেটিভ স্যাম্পল দিয়ে প্রত্যাখ্যান ক্ষমতা অভ্যন্তরীণকরণ, যাতে ইনফারেন্সে থ্রেশহোল্ডের প্রয়োজন না হয়; পাশাপাশি CoT ডেটার মাধ্যমে মডেলকে আগে রিজনিং চেইন এবং পরে উত্তর দিতে শেখানো হয়।
দ্বৈত-মোড Prompt ও প্রত্যাখ্যান ব্যবস্থা: স্ট্যান্ডার্ড মোডে একক বক্তা শনাক্তকরণ, একাধিক বক্তার মধ্যে টার্গেট শনাক্তকরণ এবং নেগেটিভ স্যাম্পল প্রত্যাখ্যান, এই তিন ধরনের কাজ একই Prompt দিয়ে পরিচালিত হয়। টার্গেট অনুপস্থিত থাকলে মডেল স্বাভাবিকভাবে খালি টেক্সট আউটপুট দেয়। CoT মোডে আলাদা Prompt দিয়ে রিজনিং লেবেল সক্রিয় করা হয়; বক্তার সংখ্যা, লিঙ্গ ও ভয়েসপ্রিন্টের সাদৃশ্যের মতো মধ্যবর্তী ধাপ আউটপুট দেওয়ার পর চূড়ান্ত ট্রান্সক্রিপশন প্রদান করে। এতে ব্যাখ্যাযোগ্যতা বাড়ে এবং WER সামান্য কমে।
04Xiaomi-CocktailASR-1 কীভাবে ব্যবহার করবেন
নির্ভরতা ইনস্টল করুন: প্রয়োজনীয় পরিবেশ ইনস্টল করতে pip install torch torchaudio transformers soundfile চালান।
মডেল ডাউনলোড করুন: HuggingFace (Ease3/Xiaomi-CocktailASR-1) থেকে মডেলের ওজন ফাইল ডাউনলোড করুন।
মডেল লোড করুন: AutoModel.from_pretrained("Ease3/Xiaomi-CocktailASR-1", trust_remote_code=True, torch_dtype="bfloat16").cuda().eval() ব্যবহার করে মডেল লোড করুন।
অডিও প্রস্তুত করুন: 16k সিঙ্গেল-চ্যানেল রেফারেন্স স্পিচ (টার্গেট স্পিকারের ভয়েসপ্রিন্ট) এবং শনাক্তকরণের জন্য একটি একক/একাধিক বক্তার অডিও প্রস্তুত করুন (16k না হলে স্বয়ংক্রিয়ভাবে রিস্যাম্পল করা হবে)।
একক ইনফারেন্স: model("target.wav", "ref_speaker.wav") কল করলে টার্গেট স্পিকারের ট্রান্সক্রাইব করা টেক্সট ফেরত আসবে (নেগেটিভ স্যাম্পলে স্বয়ংক্রিয়ভাবে খালি টেক্সট আউটপুট হবে, অতিরিক্ত প্যারামিটারের প্রয়োজন নেই)।
চেইন-অব-থট ইনফারেন্স: cot=True প্যারামিটার যোগ করলে মডেল -এ রিজনিং প্রক্রিয়া এবং -এ চূড়ান্ত ফলাফল আউটপুট করবে।
ব্যাচ ইনফারেন্স: ডেটাকে 5-কলামের TSV (utt_id, wav, text, ref_wav, ref_id) হিসেবে সাজিয়ে tools/test_batch_scp.py চালান এবং মডেলের পাথ, ইনপুট TSV ও আউটপুট ফাইল নির্দিষ্ট করলে ব্যাচ ট্রান্সক্রিপশন করা যাবে।
05Xiaomi-CocktailASR-1-এর মূল সুবিধা
একাধিক বক্তার SOTA কর্মক্ষমতা: AliMeeting, AMI, LibriMix-সহ একাধিক প্রধান একাধিক-বক্তা বেঞ্চমার্কে সর্বোচ্চ শনাক্তকরণ মান অর্জন করেছে (যেমন AliMeeting Far WER 20.63%, আগের SOTA ছিল 27.5%)।
একক ও একাধিক বক্তার জন্য একীভূত মডেল: একই মডেল একক-বক্তা পরিস্থিতিতেও প্রচলিত ASR-এর কাছাকাছি কর্মক্ষমতা দেয়, বক্তার সংখ্যা অনুযায়ী মডেল পরিবর্তনের প্রয়োজন হয় না।
নেগেটিভ স্যাম্পল প্রত্যাখ্যান: টার্গেট স্পিকার অনুপস্থিত থাকলে খালি টেক্সট আউটপুট দেয়; প্রত্যাখ্যানের হার 68%-80%, যেখানে Qwen3-ASR ও StepAudio-এর মতো মডেলগুলোর প্রত্যাখ্যানের হার 0।
চেইন-অব-থট ব্যাখ্যাযোগ্য রিজনিং: CoT মোডে বক্তার সংখ্যা, লিঙ্গ ও ভয়েসপ্রিন্টের সাদৃশ্যসহ রিজনিং প্রক্রিয়া আউটপুট দেয়, যা ব্যাখ্যাযোগ্যতা বাড়ানোর পাশাপাশি WER সামান্য কমায়।
সহজ এন্ড-টু-এন্ড আর্কিটেকচার: রেফারেন্স স্পিচ সরাসরি ভয়েসপ্রিন্ট Prompt হিসেবে ব্যবহৃত হয়, ফলে প্রচলিত স্পিচ সেপারেশন মডিউলের প্রয়োজন হয় না এবং ক্যাসকেড সিস্টেমের ত্রুটি সঞ্চয় এড়ানো যায়।
ব্যবহারের বাধা কম: এক লাইনের কোডে কল করা যায়, স্বয়ংক্রিয় রিস্যাম্পলিং ও ব্যাচ ইনফারেন্স সমর্থন করে এবং পজিটিভ-নেগেটিভ স্যাম্পল Demo প্রদান করে, তাই ইনস্টল করেই ব্যবহার করা যায়।
06Xiaomi-CocktailASR-1-এর প্রকল্পের ঠিকানা
GitHub রিপোজিটরি: https://github.com/xiaomi-research/xiaomi-cocktailasr-1
HuggingFace মডেল রিপোজিটরি: https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
arXiv প্রযুক্তিগত গবেষণাপত্র: https://arxiv.org/pdf/2609.11274
07Xiaomi-CocktailASR-1-এর প্রয়োগক্ষেত্র
স্মার্ট মিটিংয়ে নির্দিষ্ট বক্তার ট্রান্সক্রিপশন: একাধিক বক্তার মিটিংয়ে শুধু নির্দিষ্ট বক্তার কথা শোনা ও ট্রান্সক্রাইব করা, অন্য অংশগ্রহণকারীদের বাধা ও আলোচনা স্বয়ংক্রিয়ভাবে বাদ দেওয়া।
ভয়েস অ্যাসিস্ট্যান্টে মালিকের কমান্ড শনাক্তকরণ: ফোন, স্পিকার বা গাড়ির পরিবেশে শুধু মালিকের কণ্ঠে সাড়া দেয়, ফলে পটভূমির অন্য মানুষের কণ্ঠে ভুলভাবে কমান্ড সক্রিয় হয় না।
গ্রাহকসেবা ও মাননিয়ন্ত্রণের কল রেকর্ড বিশ্লেষণ: একাধিক ব্যক্তির কথোপকথনের রেকর্ড থেকে নির্দিষ্ট পক্ষের সম্পূর্ণ বক্তব্য নির্ভুলভাবে বের করে কমপ্লায়েন্স যাচাই ও সেবা মূল্যায়নে ব্যবহার করা।
স্মার্ট হোম ভয়েস কন্ট্রোল: টেলিভিশনের শব্দ ও একাধিক মানুষের কথাবার্তায় ভরা ঘরেও রিমোট হাতে থাকা ব্যক্তির ভয়েস কমান্ড নির্ভুলভাবে শনাক্ত করে ভুল操作 এড়ানো।
অ্যাক্সেসিবল শ্রবণ ও রেকর্ডিং ডিভাইস: শ্রবণপ্রতিবন্ধী ব্যক্তি বা রেকর্ডকারীর জন্য নির্দিষ্ট বক্তার কণ্ঠ আলাদাভাবে বের করে রিয়েল-টাইমে টেক্সটে রূপান্তর করা, যাতে কোলাহলপূর্ণ সামাজিক পরিবেশেও কাঙ্ক্ষিত ব্যক্তির কথা স্পষ্টভাবে শোনা যায়।
© দাবিত্যাগ: সময়ের সঙ্গে ডোমেইন ও লিংক করা কনটেন্ট পরিবর্তিত হতে পারে। AIEZZ তৃতীয় পক্ষের ওয়েবসাইট নিয়ন্ত্রণ করে না। বাহ্যিক কনটেন্ট ও ঝুঁকি স্বাধীনভাবে পর্যালোচনা করুন।
ব্যবহারকারীর রিভিউ0