
ツール、ニュース、チュートリアルを探す
公開済みのAIコンテンツをまとめて探せます。
“AI”このカテゴリーの検索結果:926件
AIツール
926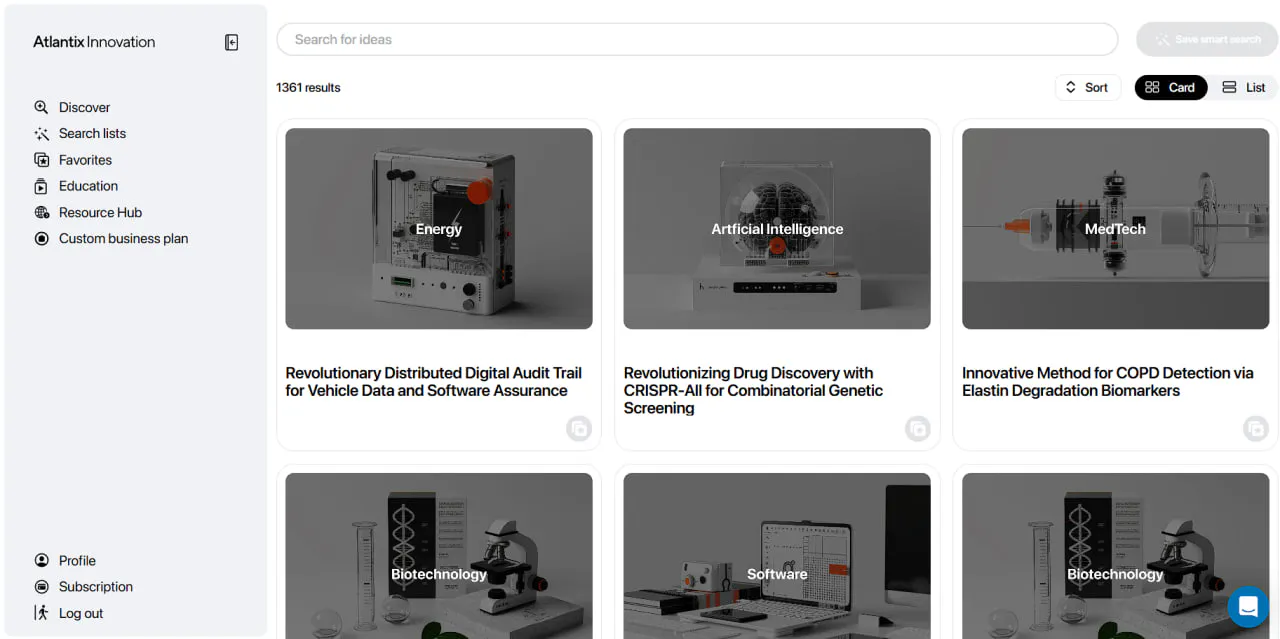 開発プラットフォームAtlantixAtlantixは、イノベーションの発見、開発、商業化を支援するプラットフォームです。第一線の科学者や大学による革新的な成果を、市場投入可能なソリューションへと転換します。ユーザーは厳選されたデータベースから技術を選び、AIを活用して事業計画を策定し、専門家、投資家、メンターとつながることができます。これらすべての機能が1つのプラットフォームに統合されています。開発プラットフォームGLM-5.3-FlashXGLM-5.3-FlashXは智譜が提供する高速推論モデルで、出力速度は最大200 tokens/s。GLM-5.3-Flashと比べて速度は5倍、価格は2.5倍で、APIはすでに公開されています。モデルは10万枚の中国製チップによる計...
 開発プラットフォームDeepSeek V4.1 FlashDeepSeek V4 Flashは深度求索が提供する軽量な大規模言語モデルで、2025年7月31日にAPI経由で一般公開ベータが開始されました。モデルは速さと低コストを重視し、推論速度は数百tokens/秒に達し、アイドル時間帯のキャッシュヒット入力は...3DデザインKageKageはデザイナーのMeng Toがオープンソースで公開している没入型3Dインタラクティブ体験プロジェクトです。単一のHTMLファイルのみを使用し、Three.jsによるリアルタイムレンダリングにGPT Image 2で生成したシーン素材を重ね、架空の京都の山...
 営業リード獲得評価 8.5ApolloApolloは、営業、セールス開発、マーケティング、収益オペレーションチーム向けの統合営業プラットフォームです。公式サイトでは、コンタクトデータベース、データ補完、アウトリーチ、ダイヤラー、顧客関係管理、商談管理などの機能を1つの製品に集約し、Webサイト、Chrome拡張機能、APIアクセスも提供しています。チームが複数の営業ツールを切り替える負担を軽減します。
 アニメ制作Wan-Animate-2 – Wanxiangチームがオープンソース化した次世代キャラクターアニメーションモデルWan-Animate-2は、Wanxiangチームがオープンソース化した次世代キャラクターアニメーションモデルです。Wan-Animateの大幅なアーキテクチャアップグレードとして、エンドツーエンドのデュアルブランチDiTを採用し、明示的なポーズ骨格を必要とせず、参照動画からモーションの事前情報を捉えます。駆動動画からキャラクターアニメーションへの変換、アイデンティティと外観の保持、テキストによる視点制御に対応し、高品質なBaseモードと少ないステップ数で推論するDistillationモードを提供します。また、リアルタイムのストリーミングキャラクターアニメーションに向けてLiteバリエーションも展開されています。バーチャル配信者、ショート動画制作、デジタルヒューマンなどの用途に適しており、モーションの忠実度とアイデンティティの一貫性を同時に高め、生成遅延を低減することを目指しています。
 3DデザインHunyuan3D-Buffalo 1.0 – テンセント混元が提供する3DマルチモーダルフレームワークHunyuan3D-Buffalo 1.0 – テンセント混元が提供する3Dマルチモーダルフレームワークは、共有のHunyuan3D-VLMバックボーンにより、3D質問応答、空間位置特定、テキストからの3D生成、指示ベースの編集、パーツ生成を単一のワークフローに統合する統合3Dマルチモーダルフレームワークです。自然言語による3Dモデル構造の理解、パーツの特定、指示に基づく局所ジオメトリの変更、セマンティックなパーツの抽出に対応し、3D理解・生成・編集の循環をつなぐことで、ゲーム、アニメーション、工業デザイン向けに組み合わせ可能な3Dアセット制作ソリューションを提供します。主な機能は3D理解、テキストからの3D生成、指示ベースの編集、パーツ生成で、4種類のタスクが同じ3Dセマンティック表現と処理パイプラインを共有します。ゲーム開発者、アニメーション制作者、工業デザイナー、3Dコンテンツクリエイターに適しており、自然言語による対話で専門知識の壁を下げ、アセットの再利用と反復効率を高めます。
 画像編集InstructAV2AV – 智源と北京大学が共同オープンソース化した音声・映像統合編集モデルInstructAV2AV – 智源と北京大学が共同オープンソース化した音声・映像統合編集モデルは、北京智源人工知能研究院と北京大学が共同で開発・公開した音声・映像統合編集モデルです。ユーザーは自然言語による一文の指示だけで、エンドツーエンドの生成過程において映像と対応する音声を同時に編集でき、手動マスクや段階的な処理は必要ありません。モデルは台詞の変更、人物の置き換え、オブジェクトの追加・削除に対応し、背景や環境音を維持しながら、映像と音声の時間的な同期を保ちます。主な機能には、人物の同一性を維持した音声編集、音声・映像インスタンスの置き換え、インスタンスの追加・除去、属性の組み合わせ編集があり、映画・映像のポストプロダクション、ショート動画制作、バーチャルヒューマン運用、広告クリエイティブ、インタラクティブコンテンツ制作などに活用できます。