
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-13
01QwenGyreとは
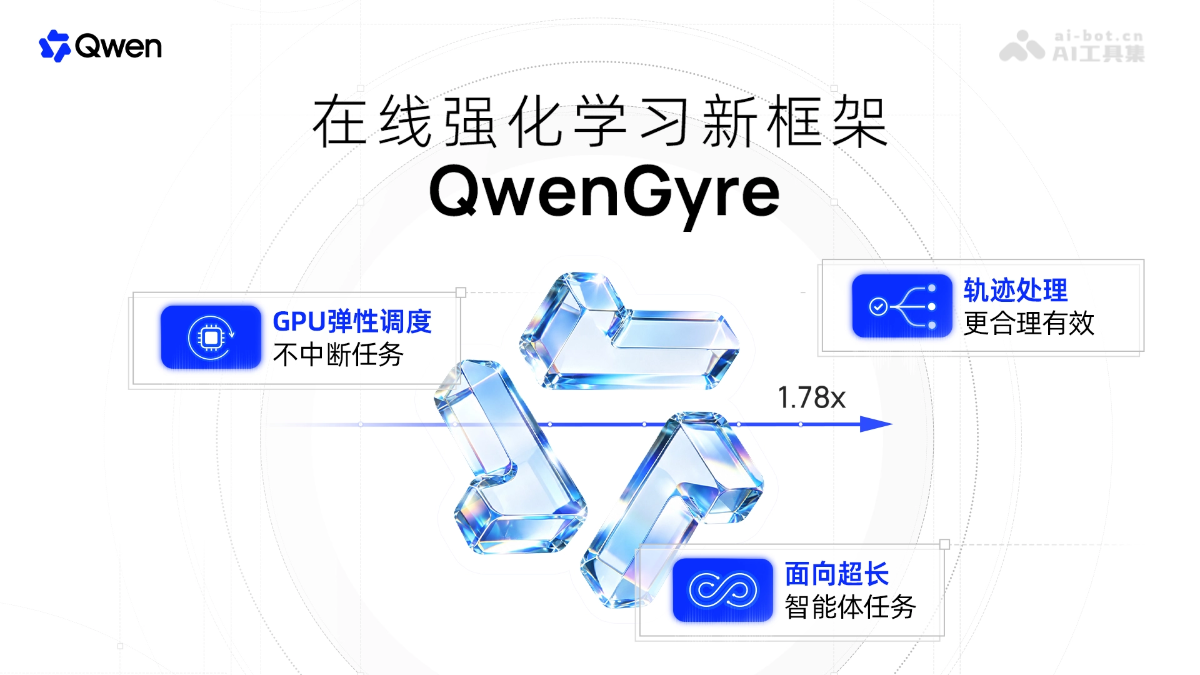
QwenGyreはアリババのQwenが開発した超長期エージェント向けオンライン強化学習フレームワークで、1回あたり約70万token、数時間にわたるタスクを対象とします。QwenGyreは弾力的なスケジューリングにより、タスクを中断することなくアイドル状態のGPUをサンプリングと訓練の間で切り替えます。軌跡処理によって実際のコンテキストを保持し、成果の一部を評価し、共有プレフィックスを重複排除してコストを抑制します。Qwen3.8-2.4Tでは48ステップでNL2RepoBenchの合格率を52.48%から58.54%に引き上げ、Asyncと比べてエンドツーエンドで1.78倍高速化しました。
02QwenGyreの主な機能
超長期エージェント向けオンライン強化学習:1回の実行が数時間に及び、累計約100万tokenとなるタスクに対して、直接RL訓練を行います。
弾力的なGPUスケジューリング:タスクを中断せず、アイドル状態のGPUをサンプリングと訓練の間で動的に切り替えます。
リクエストの再ルーティングとKV cache移行:GPUの役割切り替え時もエージェントは動作を継続し、ワークスペースとツールの状態を保持します。RDMAでKV cacheを移行し、重複計算を削減します。
ストリーミング訓練と新ノードの途中参加:コアcellが権威パラメータを保存し、サテライトcellはいつでもスナップショットを取得して進行中のバッチに参加し、進捗に応じてマイクロバッチを受け取ります。
軌跡ツリーと実コンテキストの保持:Token-in Token-outで各呼び出しの正確な入出力を記録し、共有プレフィックスに基づいて軌跡ツリーを構成します。出力は常に生成時のコンテキストに対応します。
部分スコアリング(Partial Scoring):タイムアウトして未完了のタスクでも、検証可能な成果があればタスクのルールに従って採点し、訓練に利用します。
軌跡予算と損失の均衡化:各実行で保持する軌跡を最大Jmax件に制限し、共有プレフィックスの損失は1回だけ計上することで、分岐の多いタスクに過大な重みが付くのを防ぎます。
03QwenGyreの技術原理
弾力的なスケジューラ(Elastic Scheduler):GPUを複数の同種計算ユニットに分割し、各cellがSGLangによるサンプリングサービスと、Megatronによる完全な訓練レプリカの両方を担えるようにします。スケジューラは未完了タスク量である「水位」を追跡し、残りのサンプリング容量が実行中のタスクを支えるのに十分で、かつ訓練データの供給も十分であれば、cellを順番に訓練へ切り替えます。切り替え時にはプロキシがモデルリクエストを新しい推論エンジンへリダイレクトし、未完了リクエストを再試行します。バックエンドプロセスと通信グループを再構築する必要はありません。コアcellは権威重みとオプティマイザ状態を保持し、サテライトcellはRDMAでパラメータスナップショットを取得して現在のバッチの勾配累積に参加します。最後にコアが統合して更新することで、データの準備に応じた段階的な訓練拡張と、サンプリングと訓練の高度な重複実行を実現します。
軌跡プロセッサ(Trajectory Processor):QwenGyreはプロキシを通じて、各モデル呼び出しの正確な入力・出力token IDと行動方策の対数確率を記録します。共有プレフィックスを再利用し、分岐箇所に分岐を作成して軌跡ツリーを構成することで、各出力が常に生成時の元のコンテキストに対応するようにします。訓練参加判定の段階では、役割の優先度に基づいて各実行からJmax件以下の軌跡を選択します。方策モデルが生成したtokenだけを損失計算に参加させ、共有ターゲットは1回だけ計上します。損失はまず実行内で選択されたtokenについて平均し、その後実行単位で平均することで、実行の重みを分岐数から切り離します。さらにPartial Scoringでタイムアウトしたタスクの完了部分を評価・採点し、超長期実行における希少で高コストな有効シグナルを最大限に活用します。
04QwenGyreの使い方
現在、QwenGyreは論文として公開されており、アリババはコードとインストールパッケージをまだ公開していません。
05QwenGyreの主な優位性
フラッグシップモデルによる超長期オンラインRLを初めて実現:Qwen3.8-2.4Tで1回あたり約70万tokenのタスクに対するオンライン強化学習を実施し、48ステップでNL2RepoBenchの合格率を52.48%から58.54%に向上させました。
訓練効率を大幅に向上:同じGPU予算で、エンドツーエンドの高速化はAsync比で最大1.78倍、Colocate比で1.85倍に達しました。48ステップの訓練時間は134.55時間から75.42時間に短縮されました。
タスクを一切中断しない弾力的なスケジューリング:GPUをサンプリングと訓練の間で動的に切り替えても、エージェントの実行、ワークスペース、ツールの状態は完全に保持されます。切り替えに要する時間はわずか数秒で、数時間に及ぶ実行時間と比べれば無視できます。
GPU利用率を最大化:きめ細かなcell単位のリソース割り当てにより、Colocate方式のロングテールによる待機・アイドルと、Async方式の固定分割による硬直性を解消します。訓練をサンプリングによって完全に隠蔽できます。
実コンテキストに忠実な訓練:TITO機構により、各出力が生成時の元のコンテキストに対応することを保証します。履歴の圧縮やサブエージェントのコンテキスト結合によって生じる「偽のコンテキスト」に基づく訓練シグナルを回避します。
06QwenGyreのプロジェクトURL
arXiv技術論文:https://arxiv.org/pdf/2609.33848
07QwenGyreの利用シーン
自然言語から完全なコードリポジトリを生成:自然言語の仕様に基づき、ゼロからマルチパッケージのソフトウェアリポジトリを構築します。1回の実行は約70万token、数時間に及びます。
既存リポジトリでの長期ソフトウェアエンジニアリング:既存のコードベースで機能開発、バグ修正、複数ファイルにまたがる改修などの複雑なタスクを完了します。
マルチターンの端末自動化:エージェントがコマンドライン環境で数百回のツール呼び出しを連続して実行し、システム設定や運用保守タスクを完了します。
大規模コードベースのリファクタリングと移行:リポジトリをまたぐ技術スタックのアップグレードや全面的なリファクタリングなど、数時間にわたる継続的な計画と実行を必要とするエンジニアリングタスクに対応します。
マルチエージェント協調タスク:メインエージェントがサブエージェントへ委任する階層的な実行シナリオで、軌跡処理により分岐構造を活用してサブタスクの訓練コストを抑制できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0