
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-28
01Unlimited OCR 2とは
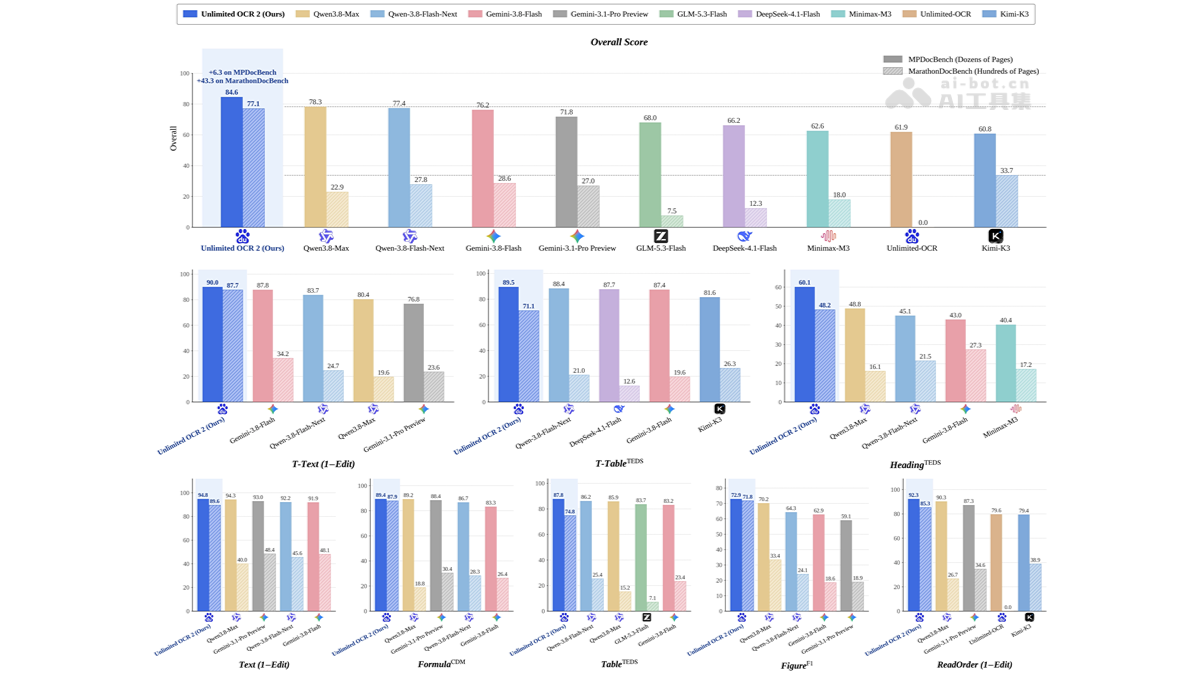
Unlimited OCR 2は、百度の文心がオープンソースで公開するエンドツーエンド文書解析モデルです。ページ数に制限なく長文書を解析でき、数千ページの書籍も一度に処理しながら精度と効率を維持します。Unlimited OCR 2は、疎参照スライディングウィンドウアテンション機構と無限デコード機構を採用し、長文書の計算量とGPUメモリ使用量を削減します。MPDocBench、MarathonDocBenchなどのベンチマークでSOTAを達成し、OCRを3.0時代へと前進させます。
02Unlimited OCR 2の主な機能
ページ数に制限のない解析:従来のページ数上限を突破し、数千ページ規模の長文書を一度に処理できます。
長文書の高精度な理解:文書が大幅に長くなっても、高い解析精度と処理効率を維持します。
ページ間の情報関連付け:前の内容を振り返り、ページをまたぐ内容を照合できるため、複数ページの結合によるコンテキストの分断を軽減します。
オープンソースで利用可能:コードとモデルの重みが公開され、百度インテリジェントクラウドおよび百度AIオープンプラットフォームでも提供されています。
03Unlimited OCR 2の技術原理
WeChatで「オープンソース」と返信し、AIオープンソースプロジェクトの交流グループに参加
SR-SWA 疎参照スライディングウィンドウアテンション:人間が本を書き写す際の「現在のページに集中し、必要に応じて前の内容を振り返る」方法を参考にしています。Page Gateにより、各クエリの視覚的な参照範囲を文書全体から関連ページへ縮小し、ページ間の位置関係をモデル化します。さらに、スコアの高いVisual Token Bucketsを導入して長距離の視覚依存関係を捉え、文書全体のトークンに対するFull Attentionの冗長な計算を回避します。
Unlimited-Horizon Decoding 無限デコード機構:超長文書解析における計算量とGPUメモリのボトルネックに対してデコード処理を最適化し、より多くのページを処理する際にもコンテキスト長によるハードな制限を受けないようにすることで、「ページ数に制限のない」解析目標を支えます。
エンドツーエンドの長文書モデリング:従来のOCRのようにページ単位で認識してから結合する方式とも、前世代のR-SWAのように連続した数十ページまで拡張する方式とも異なります。Unlimited OCR 2は、ページ間の選択、参照による振り返り、現在ページの理解を統一されたエンドツーエンドフレームワークに組み込み、長文書解析の一貫性と完全性を高めます。
効率とコストの制御:SR-SWAの1ステップデコード速度はFull Attentionと比べて7倍、前世代のR-SWAと比べて5.6倍向上しています。主な効果は、グローバルな全量アテンションを疎な参照に置き換えたことによるものです。
04Unlimited OCR 2の使い方
入口を選択:GitHubまたはHugging Faceからコードと重みをダウンロードし、ローカル環境にデプロイします。
文書を準備:PDF、スキャン文書、長文書を整理し、ページが完全で鮮明かつ正しい向きになっていることを確認します。
アップロードまたは読み込み:オンライン入口では文書を直接アップロードし、ローカル環境では必要な環境を設定してUnlimited OCR 2のモデル重みを読み込みます。
タスクを設定:ページ単位またはAPIパラメータで、出力形式、解析範囲、表やレイアウトの認識などのオプションを選択します。
解析を実行:タスクを送信し、モデルがページ間の理解、コンテンツ抽出、構造化生成を完了するまで待ちます。
結果を確認:ページをまたぐ見出し、表、数式、ページ番号、引用、段落の連続性を重点的に確認します。
エクスポートと統合:テキスト、Markdown、JSONとして出力するか、API経由でバッチ処理や業務システムに接続します。
05Unlimited OCR 2の主な優位性
ページ数に制限のない解析:従来のOCRのページ数上限を突破し、数千ページ規模の長文書を処理できます。
長文書でも安定した精度:ページ数が大幅に増えても、高い解析精度と効率を維持します。
強化されたページ間理解:前の内容を振り返り、ページをまたぐ情報を関連付けることで、結合によるコンテキストの分断を軽減します。
高い計算効率:SR-SWAは全量アテンションを疎な参照に置き換え、冗長な計算を大幅に削減します。
低いGPUメモリ使用量:無限デコード機構と組み合わせることで、超長文書解析におけるGPUメモリの負荷を軽減します。
ベンチマークでの先進的な性能:本文によると、MPDocBench、MarathonDocBenchなどの長文書ベンチマークでSOTAを達成しています。
06Unlimited OCR 2のプロジェクトURL
GitHubリポジトリ:https://github.com/baidu/Unlimited-OCR
Hugging Faceモデルページ:https://huggingface.co/spaces/baidu/Unlimited-OCR-2
07Unlimited OCR 2の利用シーン
長編書籍・文献の解析:小説、教科書、古典などを丸ごと迅速にデジタル化し、ページ間のコンテキストを保持します。
調査レポート・財務報告書の分析:数百ページの調査レポートや年次報告書を一度に読み込み、見解、指標、リスク要因を抽出します。
法律・コンプライアンス審査:法令集、契約書類、訴訟記録を処理し、ページをまたぐ条項の関連付けをサポートします。
アーカイブ・伝票のデジタル化:スキャンした記録、診療記録、歴史資料を一括で構造化テキストに変換してデータベースに登録します。
RAG・ナレッジベース構築:超長文PDFを検索可能なコンテンツに変換し、質問応答、検索、AIエージェントからの呼び出しに活用します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0