
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-21
01WebCraftBenchとは
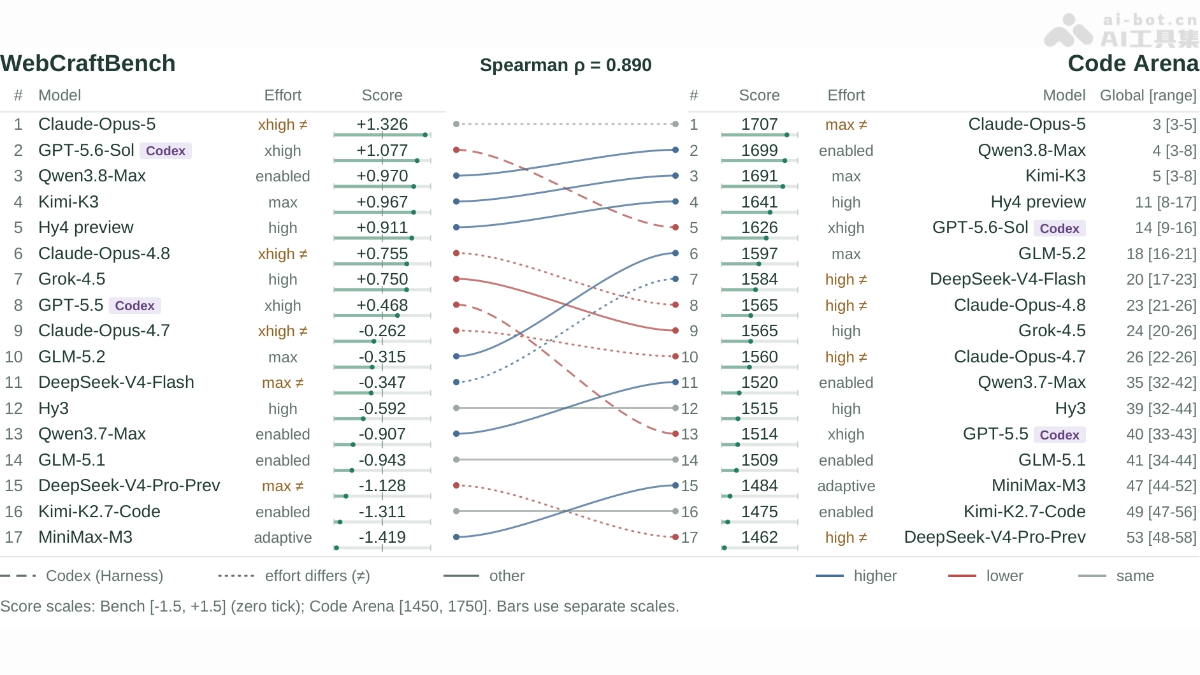
WebCraftBenchは、Tencent Hunyuanが清華大学、北京大学と共同で開発したAIウェブ生成評価ベンチマークです。WebCraftBenchはまず生成アプリに自動計測を組み込み、エージェントがPlaywrightを通じて実際にウェブページを操作して機能を探索し、コードカバレッジを用いて見落としを確認します。次に、インタラクションの記録を状態グラフとして抽象化し、外観、使いやすさ、要件適合度の3つの観点から個別に評価します。ベンチマークには、実際の要件369件と、人手で検証された受け入れ基準5,088件が含まれ、最先端モデル17種類の6,273個のアプリを対象としています。人間の嗜好との一致率は85.3%に達します。
02WebCraftBenchの主な機能
実際の要件による評価セット:実際の利用トラフィックから収集したユーザー要件369件を含み、機能、コンテンツ、ビジュアルの3種類の要求に対応する、人手で検証された受け入れ基準5,088件を備えています。
インタラクティブな自動探索:エージェントがPlaywright MCPを通じてテスターのようにクリック、入力、ページ切り替えを行い、機能を自ら発見して境界条件をテストします。
コードカバレッジによる誘導:Istanbulをベースに自動計測を行い、カバレッジをリアルタイムで監視します。探索が不十分な場合は、補助モデルが未到達のコード領域を提示します。
状態の抽象化と整理:冗長な操作記録を重複排除・正規化し、状態遷移グラフに統合して、評価に使う主要な実行証拠を抽出します。
3次元の独立評価:外観、使いやすさ、要件適合度を個別に評価し、標準化された総合スコアに統合します。
人間の嗜好による検証:独立した検証セットで、再確認済みの人手投票と比較します。ペア判定の一致率は85.3%に達し、評価の信頼性を検証しています。
03WebCraftBenchの技術原理
自動計測による実行証拠の収集:システムはアプリケーションコードにカウンターを挿入し、静的HTML、Vite、Next、CRA、Astroなどのフレームワークに対応します。アプリ起動後は、インタラクションのたびにコードカバレッジと増分を返し、「どのコードが実行されたか」を可視化します。
カバレッジに導かれたエージェント探索:探索エージェントはソースコードも受け入れチェックリストも見ず、GUIテストの手順に従ってウェブページを操作します。3回連続で新たなカバレッジが得られない場合、システムは別のモデルに未実行コードを分析させ、その提案を自然言語に変換して探索エージェントに渡し、探索を続行させます。
状態の抽象化によるインタラクション軌跡の圧縮:ページ構造を正規化し、同一ページを1つの状態に統合して、操作を状態遷移グラフとして接続します。重複するスクリーンショットによる評価モデルのコンテキスト圧迫を避け、障害経路を明確にします。
探索と評価を分離した多次元スコアリング:探索段階で証拠を収集する際は受け入れチェックリストを見ず、評価段階で初めて各基準と照合して証拠を検索します。外観と使いやすさは、「長所を探す、欠点を指摘する、審判が採点する」という3段階の審議で評価します。要件適合度は各判定で実行証拠を引用し、達成割合に基づいて採点します。3つの次元はそれぞれ総合スコアの3分の1を占めます。
04WebCraftBenchの使用方法
生成アプリの準備:評価対象のモデルに要件に基づくウェブアプリを生成させ、実行可能な状態でデプロイします。
自動計測:WebCraftBenchの計測ツールを実行し、アプリケーションコードにカバレッジカウンターを注入して、各インタラクションでコード実行情報を返せるようにします。
インタラクション探索:探索エージェントを起動し、Playwright MCPでウェブページを操作します。クリック、入力、ページ切り替えなどを実行し、機能を自ら発見して境界条件をテストします。
カバレッジによる見落とし確認:3回連続で新たなカバレッジが得られない場合、システムは補助モデルに未実行コードを分析させ、自然言語の提案を生成して探索エージェントに渡します(最大100ステップ)。
実行証拠の整理:システムはページ構造を自動的に状態として抽象化し、操作記録の重複を排除・統合して状態遷移グラフにまとめます。スクリーンショットとインタラクション軌跡は保持されます。
3次元評価:評価エージェントが外観と使いやすさを個別に評価し、受け入れ基準と1件ずつ照合して要件適合度を確認します。各判定では実行証拠を引用する必要があります。
結果の出力:3つの次元の標準化スコアと総合スコアを取得できます。モデルプールのランキングと比較でき、スコア差が大きいほど結果の信頼性が高くなります。
05WebCraftBenchの主な強み
実測重視:エージェントにウェブページを実際に操作させて評価するため、コードやスクリーンショットだけを見る評価では見落とされる「入口ボタンが壊れている」「トップページが開かない」といった問題を発見できます。
カバレッジによる探索誘導:コードカバレッジを「見落としを確認する手がかり」として利用し、テストエージェントが機能を見つけられない場合はバックエンドモデルが方向性を提示するため、探索の失敗を製品の欠陥と誤判定する可能性を減らします。
探索と評価の分離:受け入れチェックリストは評価段階でのみ使用します。要件による制約を維持しながら、チェックリスト外のインタラクションも観察でき、評価範囲を広げます。
多次元の独立評価:外観、使いやすさ、要件適合度を分けて採点するため、「見た目は良いが使うとすぐ壊れる」モデルの弱点が単一の総合スコアに隠れることを防ぎます。
人間の嗜好との高い一致:再確認済みの人手による比較197組で、判定一致率は85.3%に達しました。スコア差が大きい場合(≥0.75)は一致率が98%まで上昇し、結果の信頼性が高くなります。
高い評価安定性:評価審判モデルを変更してもランキング相関係数は0.980に達し、上位4位の順序は変わりません。結論は単一の審判に依存しません。
06WebCraftBenchのプロジェクトURL
arXiv技術論文:https://arxiv.org/pdf/2609.15387
07WebCraftBenchの利用シーン
AIコーディングツールのモデル選定:チームがウェブアプリの生成にどの大規模モデルを使うか選ぶ際、WebCraftBenchの3次元スコアで客観的に比較し、デモの見た目だけで判断することを避けます。
AIウェブ生成製品の受け入れテスト:WebCraftBenchの「実測プロセス」を製品提供の工程に組み込み、ページごとの手動確認に代えて、入口の無効化や到達不能な機能などの問題を自動的に発見します。
コード生成モデルの反復回帰テスト:モデルをアップデートするたびにベンチマークを実行し、外観、使いやすさ、要件適合度の変化を比較して、新バージョンが改善したのか低下したのかを定量化します。
生成品質の段階別診断:次元別の分解と低カバレッジの手がかりを利用して、問題が設計にあるのか、インタラクションのバグなのか、それとも要件理解のずれなのかを特定し、対象を絞った改善につなげます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0