
- 月間訪問数
- 0
- 料金
- 無料、有料
- 掲載日
- 2026-08-12
- 更新済み
- 2026-08-12
01PAST-Benchとは
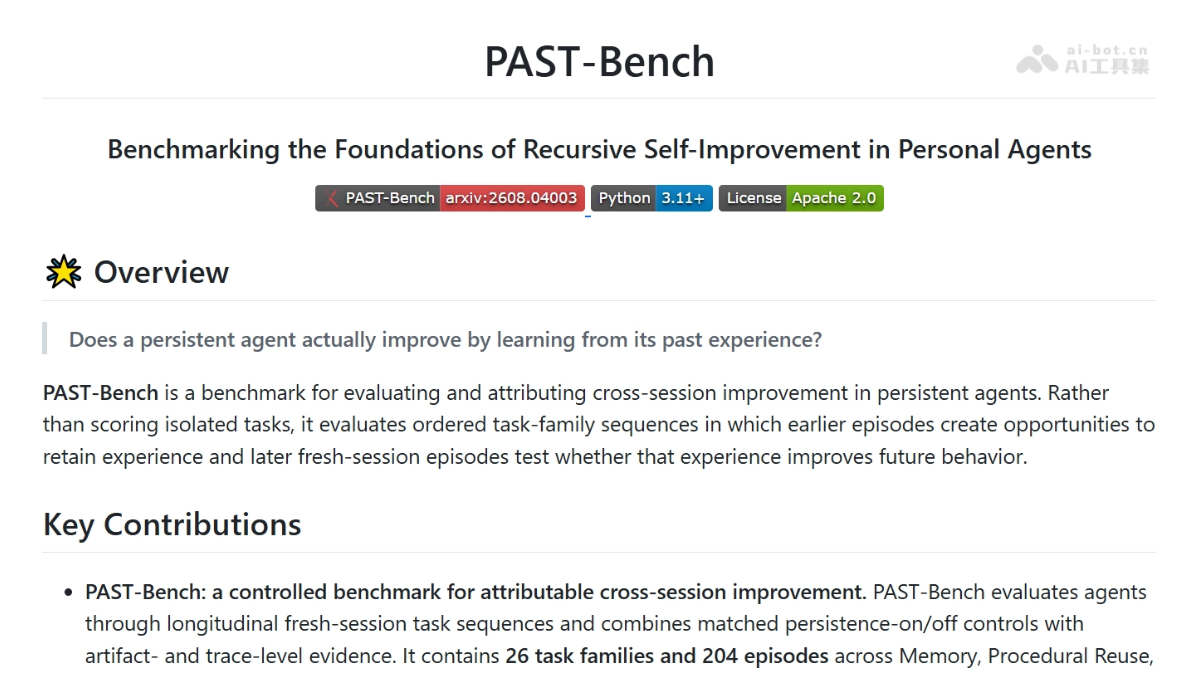
PAST-Benchは、プリンストン大学の王夢迪チームが開発したベンチマークテストで、個人AIエージェントの再帰的な自己改善能力を検証します。PAST-Benchは、記憶がある場合とない場合のタスク実行結果を比較し、エージェントが保存したセッション間の経験によって、その後の行動が実際に改善されたかを判断します。PAST-Benchは、記憶、ワークフローの再利用、情報収集、状態更新の4種類の能力を対象とし、計26のシナリオと204のタスクラウンドで構成されています。
02PAST-Benchの主な機能
再帰的な自己改善の評価:個人AIエージェントが保存したセッション間の経験(記憶、スキル、タスク履歴)によって、その後の行動が実際に改善されたかを検証します。
経験蓄積の効果を分離:スコア向上が「経験の蓄積」によるものか、それとも「基盤モデルの性能向上/プロンプトの変化/タスク難易度」など、その他の要因によるものかを区別します。
4次元の能力診断:記憶、ワークフローの再利用、情報収集、状態更新の4つの次元を対象とし、エージェントのどの能力に具体的な欠陥があるかを特定します。
メカニズムの要因分析:最終スコアだけでなく、「保存→検索→適用」の完全な経路も追跡し、改善を裏付ける実際の経路が存在するかを判断します。
03PAST-Benchの技術原理
タスクファミリーのシーケンス設計:エージェントは同じタスクファミリーを複数回のセッションにわたって順番に実行します。初期セッションでは経験を保存する機会を作り、後期セッションではその経験が正しく利用されているかを検証します。
マッチド・コントロール実験:後期セッションごとに、永続化機能を無効にし、それ以外の条件を完全に一致させた対照版を設計します。「記憶ありのスコア-記憶なしのスコア」により、自己進化の差分Δを求めます。
メカニズムの証拠追跡:実行時に、記憶への書き込み、スキル呼び出し、セッション検索、状態更新などのテレメトリーデータを記録し、Mechanism-Evidence Scoreを算出して、改善が想定された経路に従っているかを検証します。
永続化成果物の監査:エージェントが実際に保存した内容(記憶エントリ、スキルファイル、セッションインデックス)を確認し、その構造、適時性、再利用性を分析します。
04PAST-Benchの使い方
環境準備:GitHubからPAST-Benchリポジトリをクローンし、コア依存関係とエージェントアダプターをインストールします。
モデル設定:環境変数に使用するモデルのAPI Keyを設定します。
サンドボックス構築:past-bench build-image --kind sandboxを実行し、評価に必要なDockerサンドボックスイメージを構築します。
クイック検証:past-bench evolveを使って単一のタスクファミリーを実行し、--compare-no-persistenceパラメーターを追加してスモークテストを行います。
完全評価:全26のタスクファミリーを順に実行して評価します。各タスクファミリーでは、「永続化あり」と「永続化なし」の2つの対照実験が自動的に実行されます。
結果分析:--trace-dirディレクトリにあるsequence_comparison.jsonを確認し、Δ値とメカニズム証拠スコアを取得します。
カスタム接続:独自のエージェントを評価する場合は、agents/ディレクトリにアダプターを実装し、--compare-no-persistenceスイッチに対応させます。
05PAST-Benchの主な利点
真の要因分析能力:PAST-Benchは、改善が経験の蓄積によるものか、モデル自体の性能向上/プロンプトの変化/タスクの簡略化によるものかを正確に区別できます。
マッチド・コントロール実験の設計:各タスクファミリーに永続化機能を無効にした対照版が用意され、その他の条件を完全に一致させることで、記憶ありと記憶なしを直接因果比較できます。
メカニズムレベルの診断:Mechanism-Evidence Scoreを導入し、エージェントが正解したかどうかだけでなく、「保存→検索→適用」の完全な経路も追跡します。これにより、「偶然正解した」場合と「実際に経験を再利用した」場合の違いを特定できます。
4次元の能力分解:曖昧な自己改善を、記憶、ワークフローの再利用、情報収集、状態更新という4種類の具体的な能力に分解し、弱点を正確に特定します。
診断に基づく改善:ベンチマークで明らかになった実行時の障害をもとに、Hermes+フレームワークが直接生み出されました。これは、PAST-Benchが単なる評価ツールではなく、エージェントアーキテクチャ最適化の診断エンジンでもあることを示しています。
06PAST-BenchのプロジェクトURL
GitHubリポジトリ:https://github.com/Gen-Verse/PAST-Bench
arXiv技術論文:https://arxiv.org/pdf/2608.04003
07PAST-Benchの活用シーン
学術研究:エージェントの再帰的な自己改善に向けた、標準化された再現可能な定量評価環境を提供し、異なるアーキテクチャを客観的に比較できます。
フレームワーク開発:4次元の能力分解によってエージェントフレームワークの弱点を正確に特定し、アーキテクチャの最適化(Hermes+の誕生など)を支援します。
モデル選定:固定されたフレームワーク上で、異なる基盤モデルのセッション間経験の再利用性能を比較し、各モデルの能力傾向を把握します。
永続化の検証:異なる記憶構造や検索戦略の実際の効果をテストし、「保存したが見つからない」「保存したが使われない」といった無効な永続化を防ぎます。
製品の反復改善:新バージョンのスコア向上が「セッション間の経験蓄積」によるものか、「基盤モデルの性能向上」によるものかを区別し、永続化機能が実際に価値を生み出していることを確保します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0