
オープンソース
AIEZZのツールタグ
「オープンソース」タグのAI製品を閲覧中。29件の検索結果があります。
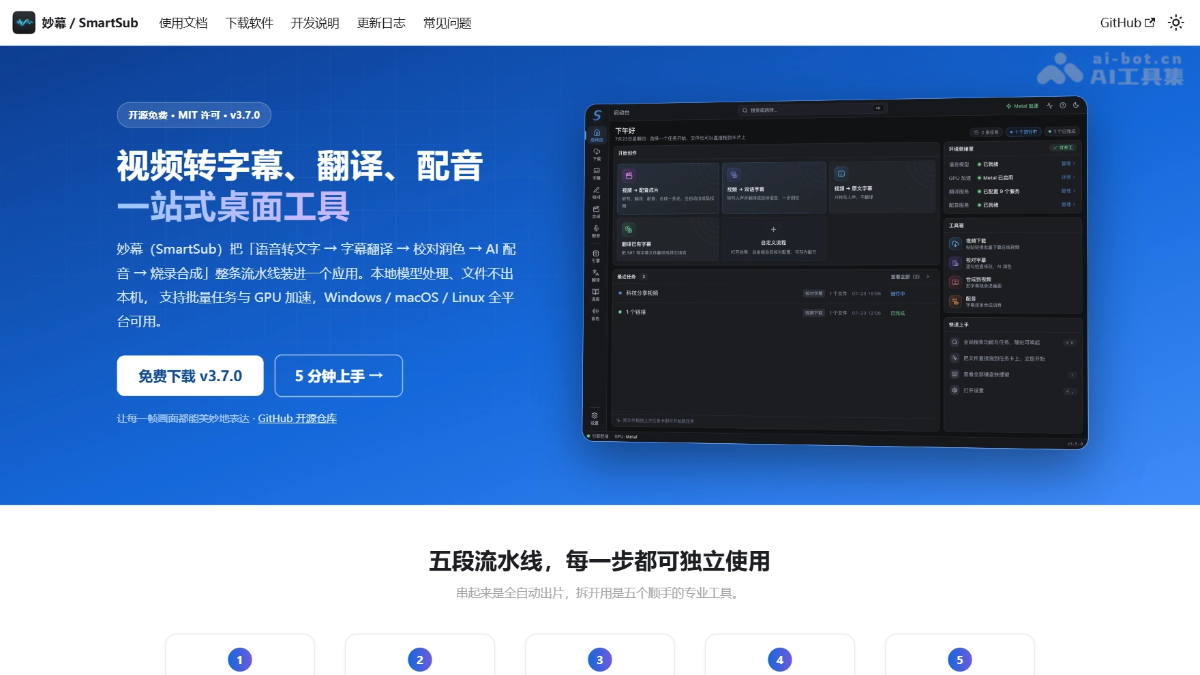 SmartSub – オープンソースのオールインワン音声・動画字幕処理デスクトップツールAI音声認識SmartSub(妙幕)は、オープンソースのオールインワン音声・動画字幕処理デスクトップツールです。音声・動画処理の全工程を1つのアプリに統合し、Whisper、FunASR、Qwen3-ASRなどのローカルモデルによるオフライン音声認識に対応。20種類以上の翻訳サービスと、複数話者によるAI音声合成を利用できます。オンライン動画ダウンローダーを内蔵し、Bilibili、YouTubeなどのプラットフォームに対応。NVIDIA CUDA、Apple Core MLなどのハードウェアアクセラレーションをサポートし、Windows、macOS、Linuxの3つのプラットフォームでローカル実行できます。00
 InstructAV2AV – 智源と北京大学が共同オープンソース化した音声・映像統合編集モデル画像編集InstructAV2AV – 智源と北京大学が共同オープンソース化した音声・映像統合編集モデルは、北京智源人工知能研究院と北京大学が共同で開発・公開した音声・映像統合編集モデルです。ユーザーは自然言語による一文の指示だけで、エンドツーエンドの生成過程において映像と対応する音声を同時に編集でき、手動マスクや段階的な処理は必要ありません。モデルは台詞の変更、人物の置き換え、オブジェクトの追加・削除に対応し、背景や環境音を維持しながら、映像と音声の時間的な同期を保ちます。主な機能には、人物の同一性を維持した音声編集、音声・映像インスタンスの置き換え、インスタンスの追加・除去、属性の組み合わせ編集があり、映画・映像のポストプロダクション、ショート動画制作、バーチャルヒューマン運用、広告クリエイティブ、インタラクティブコンテンツ制作などに活用できます。00
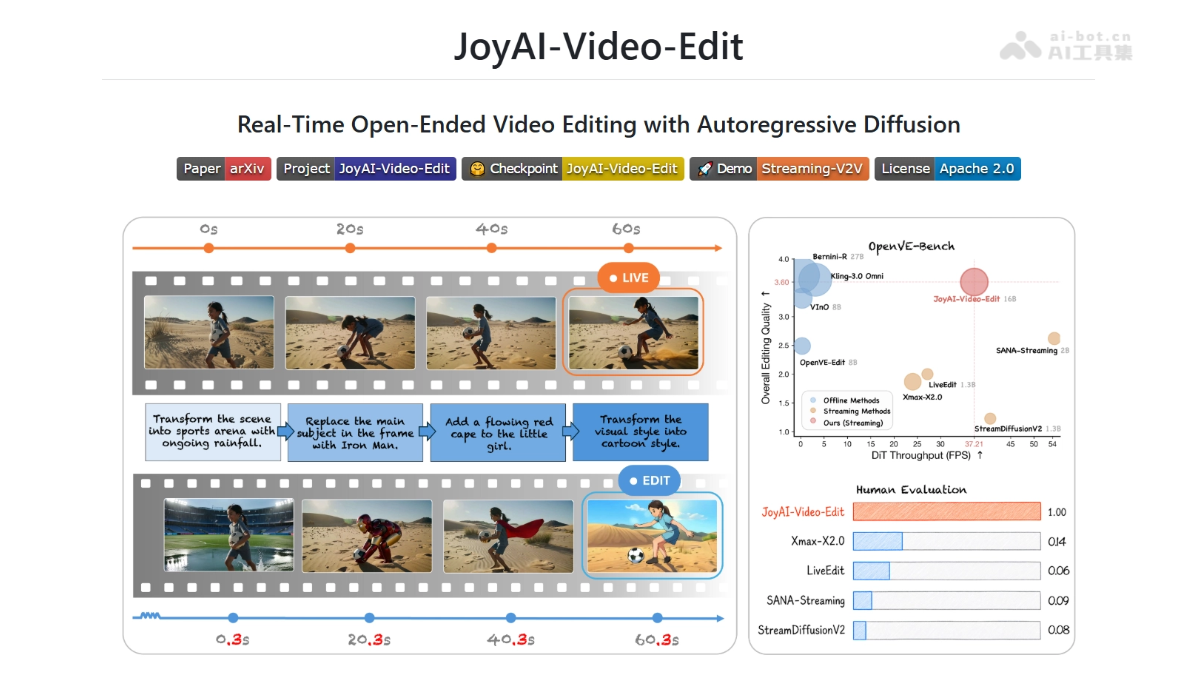 JoyAI-Video-EditAI動画編集JoyAI-Video-Edit – 京東がオープンソース化したリアルタイムストリーミング動画編集モデルは、京東が独自開発しオープンソース化したリアルタイムストリーミング動画編集モデルです。16Bパラメータの自己回帰拡散アーキテクチャを基盤とし、720P解像度で30FPSの推論速度を実現し、任意の長さの動画を安定してストリーミング編集できます。ユーザーは自然言語の指示により、動画の再生中に人物、シーン、スタイル、物体をリアルタイムで変更でき、動画全体の生成を待つ必要がありません。OpenVE-Benchの評価では、すべてのストリーミング編集手法を上回り、各指標で全面的に優れた結果を達成しています。また、具身知能向けの大規模なデータ合成手段も提供します。00
 Orchard – Microsoft Researchがオープンソースで公開するAgentic AIモデリングフレームワークAIエージェントOrchard – Microsoft Researchがオープンソースで公開するAgentic AIモデリングフレームワーク。KubernetesベースのOrchard Env環境サービスを中核とし、ドメインをまたいだサンドボックスの再利用によるデータ蒸留、強化学習のロールアウト、評価をサポートします。ソフトウェアエンジニアリング、ブラウザナビゲーション、パーソナルアシスタントの3分野をカバーし、完全なSFT + RLトレーニングレシピ、107K件のSWE軌跡、3,070件のGUIマルチモーダル・ロールアウトデータを提供します。さらに、CodexやOpenClawなどの実際のハーネス上で、エンドツーエンドのトレーニングを直接実行できます。Agent開発に取り組む学術・産業チームを対象に、Orchardは計算資源とホスティングのコストを削減しながら、ハーネスをまたいだ汎化能力によって、より小さなモデルで最先端の性能に近づくことを可能にします。00
 Alpamayo 2 Super – NVIDIAがオープンソースで公開する自動運転AI推論モデルAIプログラミングAlpamayo 2 Superは、NVIDIAがオープンソースで公開する自動運転AI推論モデルです。NVIDIA Cosmos 3 Super Reasonerを基盤に構築され、360°環境認識、高度な運転判断、自動推論ラベル生成に対応します。LingoQA自動運転推論ベンチマークで1位を獲得し、OpenMDW-1.1の寛容なライセンスを採用しているため、ファインチューニング、派生、商用再配布が可能です。また、クラウド開発と車載蒸留デプロイ向けにAlpamayo 1.5 / 1も提供され、Robotaxiや自動運転車の分野を対象としています。00
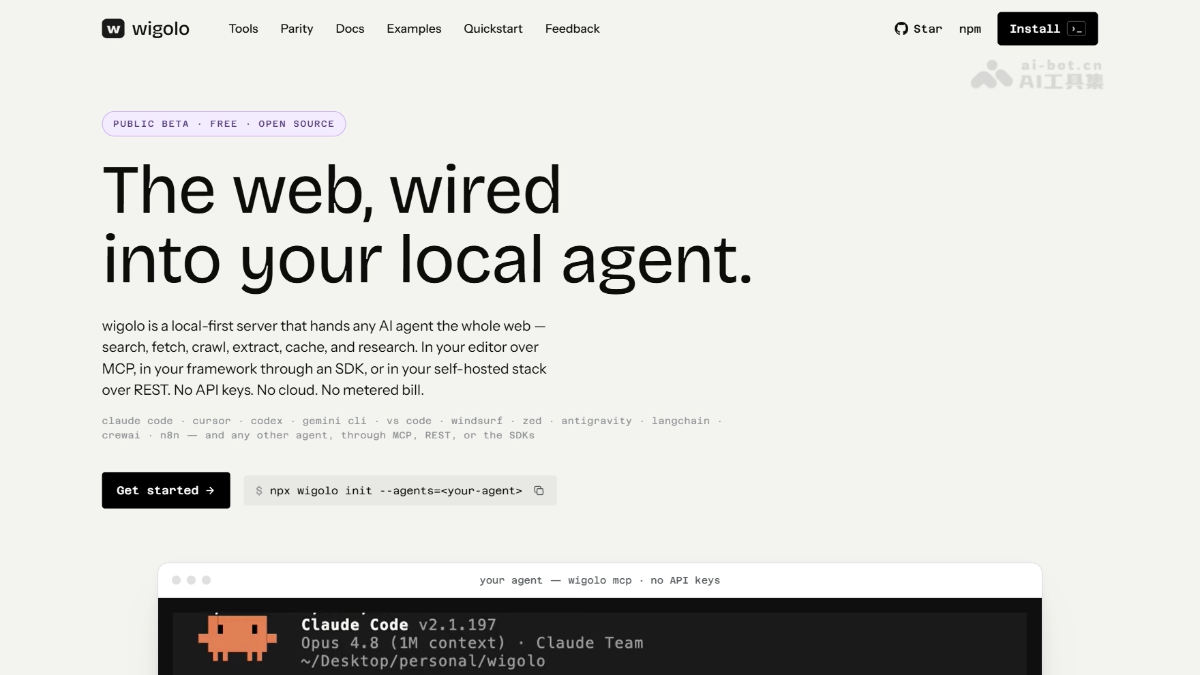 wigoloAIエージェントwigoloは、MCPを通じてClaude CodeやCursorなどのコーディングAgentに接続できるオープンソースのローカル検索ツールです。APIキー不要、完全無料で、ローカル上で検索、Webページ取得、サイト全体のクロール、構造化データ抽出、キャッシュ、リサーチを実行できます。00
 MemHarness – 上海AI Labなどが開発したエージェント記憶再構成フレームワークAIエージェントMemHarnessは、上海AI Labが浙江大学、復旦大学、上海交通大学などの大学と共同開発したLLMエージェント向け記憶再構成フレームワークです。検索と行動の間に批判・再構成の工程を挿入し、現在のコンテキストに基づいて過去の経験を保持、書き換え、または破棄します。GRPOによるエンドツーエンド学習を採用しており、追加の人手アノテーションは必要ありません。記憶検索、批判・再構成、行動生成、経験の書き戻し、剪定までの一連のプロセスをサポートし、5段階の意思決定フローを提供します。7BパラメータモデルはALFWorldとWebShopでGemini-2.5-Proをそれぞれ23.1%と39.7%上回り、分布外シナリオで平均成功率85.9%を達成しています。身体性知能による家事、自律型オンラインショッピング、インテリジェントカスタマーサービス、コード支援開発などに適しています。10
 ForgeStencil – 面壁智能が提供するStencil全自動研究・デプロイシステムAIエージェントForgeStencil – 面壁智能が提供するStencil全自動研究・デプロイシステムは、面壁智能がOpenBMBコミュニティと共同開発したもので、Kernel AgentとApp Agentによる2エージェントのクローズドループアーキテクチャを採用しています。最適化戦略の発見、高性能CUDA Kernelの合成から、本番アプリケーションへの統合検証までの全工程を自律的に実行し、人手を一切介在させません。1週間で100以上の産業・科学計算ソフトウェアをエンドツーエンド最適化し、中央値で1.41倍の高速化を達成しました。石油・ガス探査、電磁界シミュレーション、医用画像など、8つの主要産業分野と5つの主要科学分野をカバーし、HPC専門家への依存と研究開発期間を大幅に削減します。00
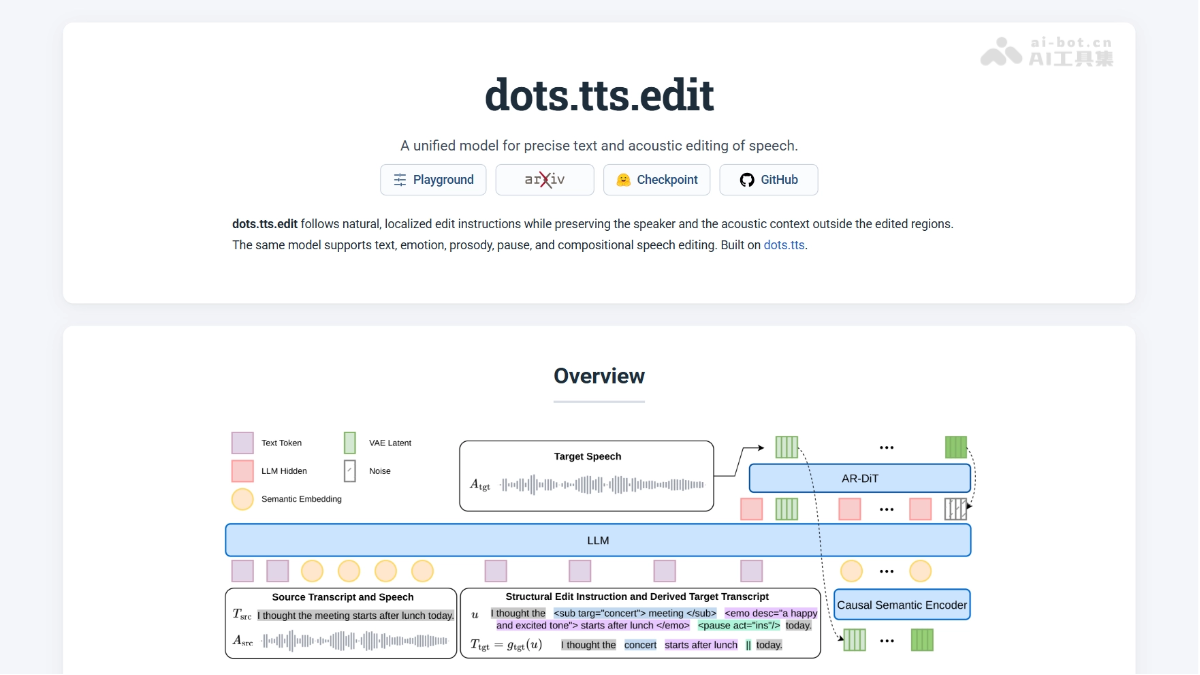 dots.ttsAI音声合成dots.ttsは、小紅書のdotsチームと上海交通大学X-LANCE研究室が共同でオープンソース化した、20億パラメータの完全連続自己回帰音声合成基盤モデルです。モデルは連続潜在空間で48kHz音声を直接パッチ単位で生成し、...00
 ShieldstralAIスマートQ&AShieldstral – Mistral AIのオープンソース・マルチモーダルコンテンツ安全分類モデルは、Mistral AIが開発した30億パラメータのオープンソース・マルチモーダルコンテンツ安全分類モデルで、Ministral-3Bをベースに構築されています。従来の固定カテゴリによるコンテンツモデレーションを、二値質問応答タスクとして再定義し、自然言語によるクエリでモデレーションポリシーをリアルタイムに定義できます。再トレーニングなしで異なるシナリオに適応可能です。テキスト安全性ベンチマークで平均F1スコア84.9%、マルチモーダル安全性でF1スコア83.8%を達成し、いずれもSOTAです。16GB GPU 1枚でデプロイでき、12言語をサポートします。主な機能には、ポリシー適応型モデレーション、マルチモーダル統合検出、きめ細かな違反識別、キャリブレーション済み安全スコア、軽量なエッジデバイス展開があり、ソーシャルプラットフォームのコンテンツリスク管理、AI対話の安全保護、広告・マーケティングコンプライアンス、オンライン教育コンテンツのフィルタリング、企業文書のセキュリティ監査などに利用できます。00
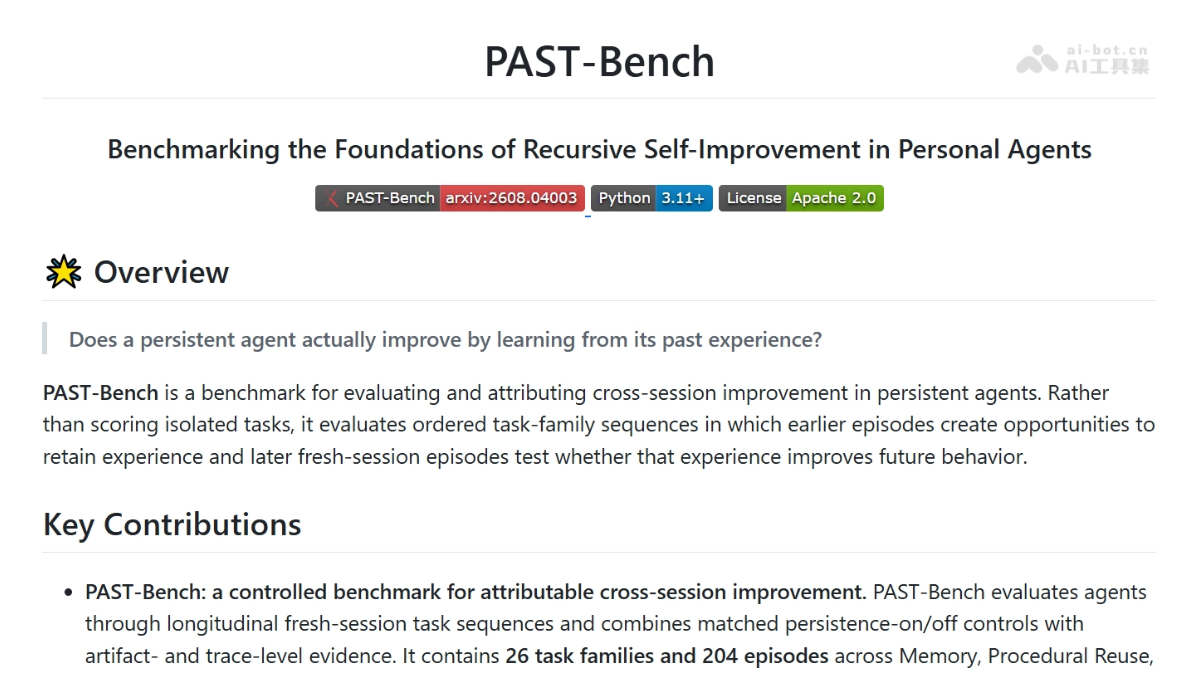 PAST-BenchAIエージェントPAST-Benchは、プリンストン大学の王夢迪チームが開発したベンチマークテストで、個人AIエージェントの再帰的な自己改善能力を検証します。PAST-Benchは、記憶がある場合とない場合のタスク実行結果を比較することで、判...00
 PixelRAG開発プラットフォームPixelRAGは、バークレー大学SkyLab/BAIRがオープンソースで公開するビジョンネイティブRAGフレームワークです。Webページを純粋なテキストに抽出してから検索する従来の方法を離れ、ブラウザでWebページやPDFをスクリーンショットのタイルにレンダリングし、LoRAで微調整...00
 LTX-2.5AI動画生成LTX-2.5はLTXがオープンソースで公開するAI動画生成基盤モデルで、220億パラメータを備え、リリース時点からモデルウェイトを公開しています。ネイティブなマルチショット生成、4K HDR、RAW/EXRのプロフェッショナルワークフローに対応し、音声も同時生成できます。...00
 HOMIEAI動画生成HOMIEは香港科技大学がオープンソースで公開するデジタルヒューマン動画生成フレームワークです。Wan2.1-T2V-14Bをバックボーンネットワークとし、Qwen3-VLマルチモーダル大規模モデルを統合しています。フレームワークはデジタルヒューマン+商品+Logo+テキストの4要素を統合的に処理し、...00
 Palmier ProAI動画編集Palmier ProはAI時代のために作られたmacOSネイティブの動画編集ソフトです。Swiftでゼロから構築され、オープンソースで基本機能を無料で利用できます。生成AIをタイムラインに直接組み込み、Seedance、Kling ...に対応しています。00
 MindMemOS – Huawei Noah's Arkがオープンソース化したAI Agent向けメモリOSAIエージェントMindMemOS – Huawei Noah's Arkがオープンソース化したAI Agent向けメモリOS。長期的なメモリ管理を必要とするエージェントに、オープンで再利用可能なメモリレイヤーを提供します。エンティティ・属性・時間の3次元構造を採用し、メモリを単一のAgentから切り離してフレームワークをまたいで利用できる独立資産に変換します。さらに、Dreamingによるオフライン整理、Feedbackによる誤りの修正、Skill Evolutionによる自動進化などの仕組みにより、メモリを継続的に最適化します。MindVanillaとMindSchemaによるデュアルモードのメモリ書き込み、および複数経路に対応したCompact Search検索を提供し、Dockerによるローカルデプロイ、クラウドAPI、Python SDK、CLIなど、多様な接続方式をサポートします。94%以上の構造化リコール精度と、圧縮メモリ後の質問応答精度を10%向上させる効果により、パーソナライズドアシスタント、マルチAgent協調、複雑な業務自動化などのシーンで、セッションをまたいだ情報共有とタスク効率の向上を支援します。00
 Nemotron 3.5 LightningAIエージェントNemotron 3.5 Lightningは、NVIDIAが開発した300億パラメータのオープンソースMoEモデルで、マルチエージェントシステム向けに最適化されています。同クラスのモデルと比べて出力速度は4倍、エージェントタスクの完了速度は30%向上し、...00
 Wan-Animate-2 – Wanxiangチームがオープンソース化した次世代キャラクターアニメーションモデルアニメ制作Wan-Animate-2は、Wanxiangチームがオープンソース化した次世代キャラクターアニメーションモデルです。Wan-Animateの大幅なアーキテクチャアップグレードとして、エンドツーエンドのデュアルブランチDiTを採用し、明示的なポーズ骨格を必要とせず、参照動画からモーションの事前情報を捉えます。駆動動画からキャラクターアニメーションへの変換、アイデンティティと外観の保持、テキストによる視点制御に対応し、高品質なBaseモードと少ないステップ数で推論するDistillationモードを提供します。また、リアルタイムのストリーミングキャラクターアニメーションに向けてLiteバリエーションも展開されています。バーチャル配信者、ショート動画制作、デジタルヒューマンなどの用途に適しており、モーションの忠実度とアイデンティティの一貫性を同時に高め、生成遅延を低減することを目指しています。00
 SenseNova U1.5-Lite-Preview – 商湯がオープンソース化した軽量マルチモーダルモデルAI大モデルSenseNova U1.5-Lite-Preview – 商湯がオープンソース化した軽量マルチモーダルモデルは、NEO-Unifyアーキテクチャを基盤とし、8B-MoTパラメータで視覚理解、推論、生成、編集をネイティブに統合します。モデルは4K超高精細画像のネイティブ生成に対応し、精緻なテクスチャ、リアルな質感、中英語の複雑なレイアウト文字レンダリングを実現します。Prompt Enhance Skillを内蔵し、創作のハードルを下げるとともに、非常に長い自然言語指示や構造化された視覚指示を正確に実行し、継続的な反復編集にも対応します。デザイナー、開発者、コンテンツクリエイター向けに、低い導入コストと高い指示遵守性を兼ね備えた商用レベルのビジュアル制作ツールを提供します。10
 IndexTTS-2.5AI音声合成IndexTTS-2.5は、Bilibiliがオープンソースで公開する産業級のゼロショット音声クローンモデルです。パラメータ数はわずか0.8Bで、中国語、英語、日本語、スペイン語、アラビア語の5言語間のクロスリンガル転移に対応しています。00
 MAGI-2-preview – Sand.aiがオープンソース化したマルチモーダル動画生成モデルAI動画生成MAGI-2-preview – Sand.aiがオープンソース化したマルチモーダル動画生成モデルは、Sand.aiが公開した世界初の1,000億パラメータ級MoEマルチモーダル動画生成モデルです。総パラメータ数は114B、アクティブ化されるパラメータはわずか6Bです。モデルはシングルストリーム・アーキテクチャを継承し、テキスト、動画、音声を同一のTransformerに統合して共同モデリングすることで、ネイティブなマルチモーダル生成を実現します。主な機能として、テキスト・画像・動画から動画への生成に対応し、音声理解をネイティブに統合しています。MoEのスパース活性化により、推論コストを大幅に削減します。対象ユーザーはAI研究者、開発者、企業の技術チームで、学術研究、オンプレミス展開、マルチモーダル映像のプリビジュアライゼーションなどに適しており、オープンソースで商用利用可能な高効率動画生成ソリューションを提供します。00
 Qwen-CUA – Alibaba Qwenなどが発表したネイティブComputer Use AgentAIエージェントQwen-CUA – Alibaba Qwenなどが発表したネイティブComputer Use Agentは、397B-A17B混合エキスパートアーキテクチャを基盤とし、スクリーンショットだけでインターフェースの状態を認識します。DOMツリーやアクセシビリティメタデータに依存せず、キーボードとマウスのイベントを直接出力して、ブラウザー、デスクトップ、専門ソフトウェアを操作できます。OSWorld-Verifiedベンチマークでは86.2点を獲得し、より大規模なQwen-CUA-Maxは87.6点に達しており、オープンソースCUA分野でトップクラスの水準です。エンドツーエンドの視覚・アクション学習を採用し、クロスプラットフォームの汎用性と高い安定性を備えています。技術レポートとDemoも公開されており、自動テスト、RPA、アクセシビリティ支援、科学研究用ソフトウェアの操作などに活用できます。00
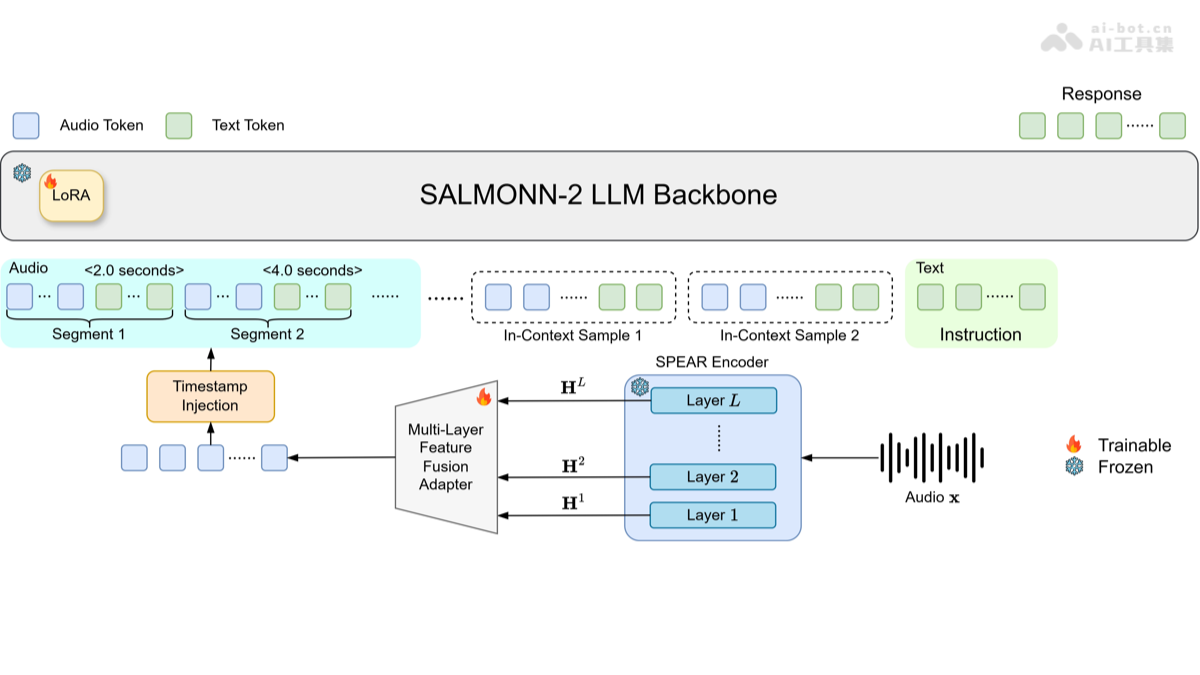 SALMONN-2 – 清華大学などがオープンソース化した汎用音声大規模言語モデルAIプログラミングSALMONN-2 – 清華大学などがオープンソース化した汎用音声大規模言語モデルは、ByteDanceのSPEAR統一自己教師あり音声エンコーダーと多層特徴融合アダプターを基盤に構築され、テキスト基盤モデルとしてQwen3を採用した汎用音声大規模言語モデルです。音声認識、音声説明、音楽理解、感情認識、話者認証などの分野横断タスクに対応し、汎用ALLMとして初めて、音イベント検出、音声ディープフェイク検出、音声品質評価、マルチモーダル文脈音声認識などの高度な機能を体系的に実現しています。従来のデュアルエンコーダー方式に代えて単一のSPEARエンコーダーを採用し、MLFアダプターによって多層の音響特徴を融合することで、よりバランスの取れた分野横断性能を実現します。約1.8万時間の教師ありデータによる効率的な学習で、SALMONN-2はMMAU-Pro、MMAR、MMSUという3つの総合ベンチマークにおいて、同規模のオープンソースモデル中で最高の性能を達成しています。スマート会議アシスタント、音声コンテンツ審査、音声品質モニタリングなどの用途に適しています。00
 Muse Glimmer – Metaがオープンソース化した300億パラメータの大規模言語モデルAIエージェントMuse Glimmerは、Metaがオープンソース化した300 億パラメータの大規模言語モデルで、24時間ローカルで動作するAgentワークフロー向けに深く最適化されています。4bit量子化技術により、24 GBのVRAMを搭載した単体GPU、または32 GBのユニファイドメモリを備えたApple Silicon(M4/M5 Max)上でスムーズに動作し、性能低下もほとんどありません。DFlash推測デコードを統合し、RTX 5090などのハイエンドハードウェアでは最大3.1倍の高速化を実現。リアルタイム対話、ツール呼び出し、コード生成、複数ステップ推論などのマルチモーダルタスクに対応します。個人開発者や中小企業、さらにデータプライバシー要件の高い医療・金融などの業界に適しており、少ないVRAMで高効率なローカルAI環境を提供します。データはすべてデバイス内に保持されます。00
 Hunyuan3D-Buffalo 1.0 – テンセント混元が提供する3Dマルチモーダルフレームワーク3DデザインHunyuan3D-Buffalo 1.0 – テンセント混元が提供する3Dマルチモーダルフレームワークは、共有のHunyuan3D-VLMバックボーンにより、3D質問応答、空間位置特定、テキストからの3D生成、指示ベースの編集、パーツ生成を単一のワークフローに統合する統合3Dマルチモーダルフレームワークです。自然言語による3Dモデル構造の理解、パーツの特定、指示に基づく局所ジオメトリの変更、セマンティックなパーツの抽出に対応し、3D理解・生成・編集の循環をつなぐことで、ゲーム、アニメーション、工業デザイン向けに組み合わせ可能な3Dアセット制作ソリューションを提供します。主な機能は3D理解、テキストからの3D生成、指示ベースの編集、パーツ生成で、4種類のタスクが同じ3Dセマンティック表現と処理パイプラインを共有します。ゲーム開発者、アニメーション制作者、工業デザイナー、3Dコンテンツクリエイターに適しており、自然言語による対話で専門知識の壁を下げ、アセットの再利用と反復効率を高めます。00
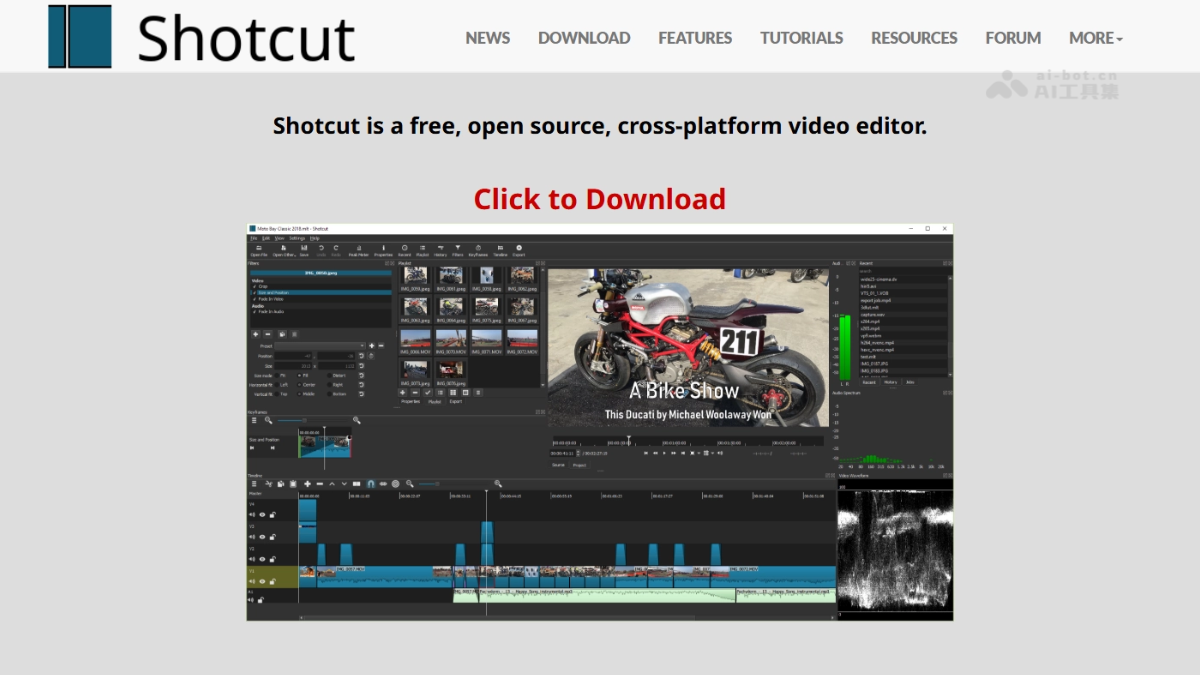 ShotcutAI動画編集ShotcutはFFmpegを基盤とするオープンソースの動画編集ソフトで、完全無料、透かしなし、時間制限なしで利用できます。数百種類の音声・動画形式をインポートせずに直接編集でき、マルチトラックタイムライン、キーフレームアニメーション、豊富...00
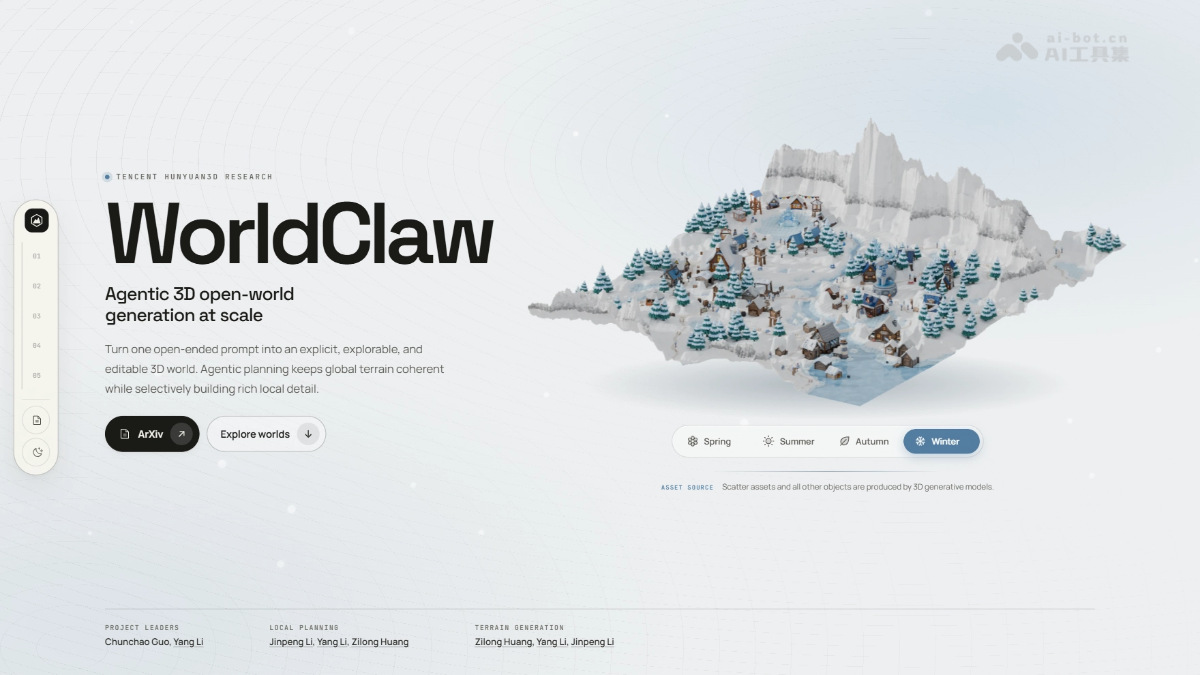 WorldClaw – Tencent Hunyuanチームが開発した3Dワールド生成フレームワーク3DデザインWorldClawはTencent Hunyuanチームが開発したAgent駆動型のオープンワールド3D生成フレームワークです。ユーザーが自然言語で説明を入力すると、システムが地形、エリア、建物、オブジェクト、空間関係を自動的に計画し、グローバルからローカルへ段階的に生成することで、Blender上に自由に探索でき、オブジェクト単位で編集可能な完全な3Dシーンを構築します。Claude Opus、GPT-Image-2、SAM3、Hunyuan3Dなど複数のモデルが連携して動作し、ビジュアルAgentによる自己検査・修復機能も備えています。宙に浮いたオブジェクトやメッシュの貫通など、接触に関する問題を自動的に修正できます。00
 PyTorchAIプログラミングツールPyTorchは、Meta AIの研究チームによって立ち上げられ、現在はLinux Foundationが管理するオープンソースの機械学習フレームワークです。主に人工知能の研究者、機械学習エンジニア、データサイエンティスト、学生を対象としています。通常はPythonでモデルとフォワード計算の流れを定義し、テンソル計算、自動微分、ニューラルネットワークモジュールを使ってトレーニングを行います。関連エコシステムのライブラリと組み合わせることで、画像、音声、テキストのタスクにも対応できます。動的計算グラフにより実験とデバッグが容易で、研究用プロトタイプからモデルのデプロイへ進めることも可能です。実際に使用するには、Python、テンソル演算、深層学習の基礎知識が必要です。実験コードを本番環境へ移行する際は、エンジニアリング面でのデプロイやリソース設定も自分で対応する必要があります。057.6
 Qwen 3.8-Max – Alibaba Cloud Qwenチームが開発したフラッグシップ大規模モデルAI大モデルQwen 3.8-Max – Alibaba Cloud Qwenチームが開発したフラッグシップ大規模モデルで、Qwen 3.5アーキテクチャを基盤に2.4兆パラメータまで拡張され、企業・研究向けの超大規模言語モデルとして位置付けられています。長期的な自動コーディング、論文の再現、コンペティション実戦、オフィス業務の効率化、量的戦略の研究開発、チップの自律設計など、多様な価値の高いシーンに対応します。実世界強化学習と自己進化型のフィードバックループにより、数日から数十日にわたる自律実行を実現し、人の介入なしで複雑なタスクを完了できます。ユーザーは千問AIプラットフォームのOpenAIまたはAnthropicプロトコル互換APIから呼び出せるほか、オープンソースの重みをローカルにデプロイして、Claude Code、Codex、Qoderなどのエージェントフレームワークに簡単に統合できます。そのため、研究開発チーム、法務・コンプライアンス担当者、デザイナーなどの専門ユーザーは業務効率を大幅に高め、長期化しやすいプロジェクトを1回の対話で納品可能な形に短縮できます。10
このタグが付いたすべてのツールを表示しています。