
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-11-02
01Xiaomi-OCR-0とは
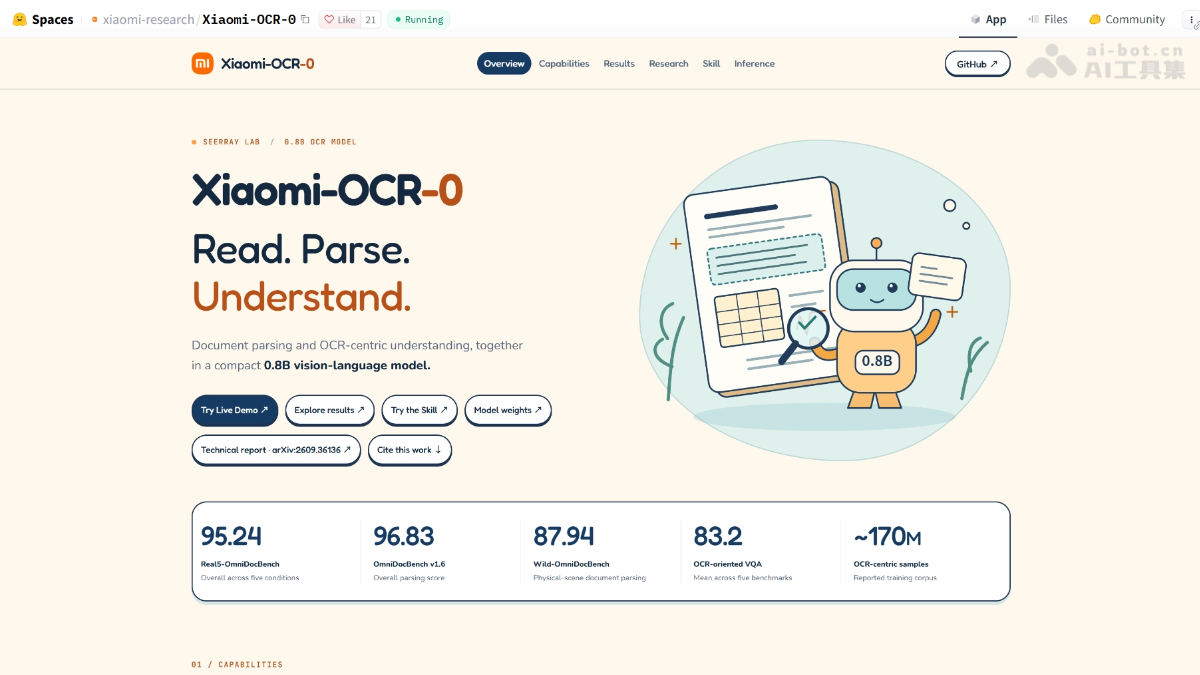
Xiaomi-OCR-0は、Xiaomiがオープンソースで公開する0.8Bの軽量マルチモーダル文書理解モデルです。Qwen3.5-0.8Bを基盤に学習され、文書解析、重要情報抽出、OCRビジュアルQAを一体化しています。Real5-OmniDocBenchで95.24点を獲得して首位、OmniDocBench v1.6では96.83点で2位、5種類のOCR-VQA平均83.2点で同規模モデルを上回ります。Xiaomi-OCR-0のデータエンジンは、専門家コンセンサスによるアノテーションとレンダリング検証を採用し、MCPやAgent Skillツールチェーンにも対応しています。すでにXiaomiスマートフォンの「スーパー小愛」に導入されています。
02Xiaomi-OCR-0の主な機能
文書解析:文書内の本文、複雑な表、数式を認識・復元し、自然な読み順に沿ったMarkdown/LaTeX形式の構造化結果を出力します。
重要情報抽出(KIE):請求書やカードなどの半構造化文書を対象に、指定フィールドを正確に特定し、JSON形式の構造化データとして出力します。
OCRビジュアルQA:文字の転記にとどまらず、文書やグラフに対する要素横断検索、数値計算、意味推論を含む質問応答に対応します。
03Xiaomi-OCR-0の技術原理
WeChatで「オープンソース」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます。
異種専門家コンセンサスアノテーション(ETC):アーキテクチャ、データ、戦略が異なる8つのOCR専門モデルが文書領域を個別に予測し、テキスト(NED)、表(TEDS)、数式(CDM)についてペアごとの一致度をそれぞれ算出します。コンセンサスが最も高い3つ組を選び、その中央値を擬似ラベルとします。コンセンサスが0.9以上の高信頼サンプルだけを直接トレーニングセットに投入し、単一モデルのバイアスを根本から排除します。
レンダリング誘導型の精緻化・判定(Render-Guided Refine-and-Judge):専門家の意見が分かれた領域について、Qwen3.5-122B-A10Bで候補解析結果を再び画像としてレンダリングし、元の領域と画素レベルおよび構造レベルで比較して、行列のずれや記号の欠落などの見えにくい欠陥を特定します。最大3ラウンド反復修正し、それでも収束しないものは、完全な検証履歴を保持した第2段階の「診断—修正—検証」に進みます。最終的に専門家プールで再度コンセンサスが得られたものだけが採用されます。
サンプリングマイニングとターゲット合成:トレーニング比率は、専門家コンセンサス度、モデルの自己一貫性、K-Means意味クラスタリングという3つのシグナルを組み合わせて決定します。これに基づき、CPT向けの広範囲な混合集合と、RL向けの高難度サンプル集合をそれぞれ構築します。合成データは「カバレッジ駆動」と「失敗駆動」の2系統で生成し、レシピの効果を凍結検証セットで確認してから採用します。
段階的な3段階トレーニング:まずQ-Maskによるテキストアンカー付き事前学習で、文字内容と空間位置をきめ細かく対応付けます。次にマルチタスクOCR継続事前学習を行い、同一の自己回帰形式で全ページ解析、領域認識、VQAなどのタスク範囲を拡張します。最後に、マイニングした高難度サンプルでDAPO式Mix-RL強化学習を行い、タスク種別に応じて報酬を振り分けます。検証可能な報酬により、複雑なレイアウトと多段階推論の限界を突破します。
04Xiaomi-OCR-0の使い方
コードの取得:GitHubリポジトリSeerRay-Lab/Xiaomi-OCR-0をクローンし、requirementsに記載された依存環境をインストールします。
重みのダウンロード:Hugging FaceのSeerRay-Lab/Xiaomi-OCR-0から0.8Bモデルの重みファイルを取得します。
クイック体験:プロジェクト付属のスクリプトを実行してブラウザ上のインタラクティブDemoを起動し、文書画像をアップロードするだけで解析、抽出、質問応答を試せます。
Agent呼び出しの設定:リポジトリのMCPサービスまたはAgent Skillをエージェントに接続し、「画面/文書を認識—フィールドを抽出—次のステップを実行」という自動化フローを実現します。
ローカルサービスのデプロイ:SGLangまたはvLLMでモデルをローカル推論サービスとしてデプロイし、業務システムからAPI経由で呼び出せます。
レイアウト検出の導入:2段階パイプラインを使用する場合、まずPP-DocLayoutV3で文字、表、数式の領域を検出し、その後各領域をXiaomi-OCR-0に入力して認識し、ページ全体の結果に組み立てます。
指示の作成:統一されたimage–instruction–response形式でプロンプトを構成し、解析、KIE、VQAのタスク種別をそれぞれ指定します。
05Xiaomi-OCR-0の主な強み
圧倒的なパラメータ効率:わずか0.8BパラメータでOmniDocBench v1.6において96.83点を獲得し、0.8B〜1.2Bの専用モデルとしてGPT-5.2やQwen3-VL-235Bなどの汎用大規模モデルを全面的に上回ります。
実環境での収集データに対する堅牢性で首位:Real5-OmniDocBenchで95.24点を獲得して首位となり、スキャン、紙の湾曲、画面の再撮影、照明の不均一、斜め撮影という5種類のノイズ環境すべてで最先端の性能を示します。
3つの能力を一体化:文書解析、重要情報抽出、OCRビジュアルQAを単一モデルに統合し、共有指示インターフェースでタスクを切り替えられるため、複数の専用モデルを組み合わせる必要がありません。
パラメータの増加に代わるデータエンジン:1.7億件のサンプルを、専門家コンセンサス投票、レンダリング誘導型検証、失敗駆動合成によって自動生成し、モデル規模ではなくデータ品質で性能を高めます。
カリキュラム学習による正の転移:解析が成熟した後、理解に関する教師信号を解析へフィードバックし、最大+0.64点を向上。軽量モデルで2つの能力を同時に飛躍させます。
06Xiaomi-OCR-0のプロジェクトURL
プロジェクト公式サイト:https://huggingface.co/spaces/xiaomi-research/Xiaomi-OCR-0
GitHubリポジトリ:https://github.com/xiaomi-research/Xiaomi-OCR-0
Hugging Faceモデルリポジトリ:https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
arXiv技術論文:https://arxiv.org/pdf/2609.36136
07Xiaomi-OCR-0の活用シーン
日常の利用証明を即時管理:フードデリバリーの受け取りコード、宅配便の受取コード、順番待ち番号などの有効期限付き情報を認識して登録し、必要なときにワンタップで呼び出せます。
スマート家計簿と明細整理:WeChatやAlipayの利用明細から金額、店舗、日時、カテゴリをワンタップで抽出し、家計簿の記録を自動生成します。
カード・証憑の構造化入力:撮影または画面認識によって、身分証、銀行カード、請求書、パスポートなどの項目をJSONとして抽出し、手入力と照合作業を不要にします。
スマートな予定生成:グループチャットの通知やイベントポスターから日時と場所を抽出し、予定カードを自動生成してカレンダーに追加します。
移動情報との連携:チャットから便名などの旅程情報を抽出し、リアルタイムの発着状況を自動検索して通知します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0