
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-09
01Ling-3.0-flash-VLとは
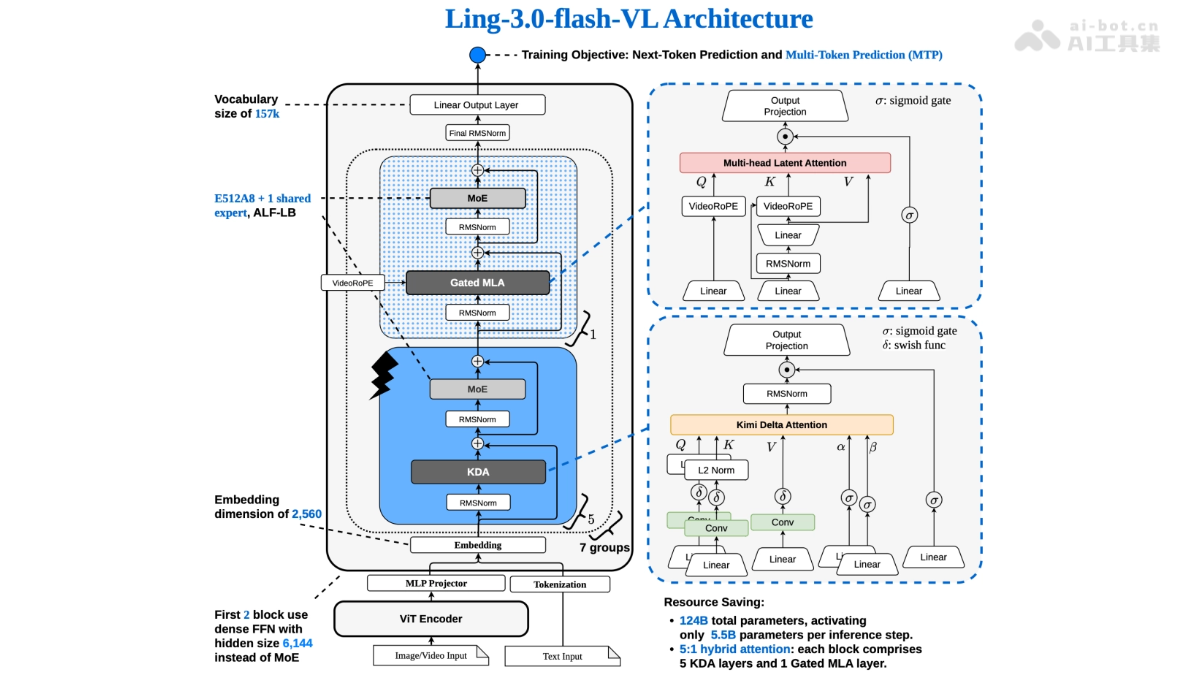
Ling-3.0-flash-VLは、蚂蚁 InclusionAIの百灵シリーズ初のオープンソースネイティブマルチモーダル大規模モデルです。Ling-3.0-flashのMoEアーキテクチャを拡張し、総パラメータ数は124B、1回の推論でアクティブになるのはわずか5.5Bです。画像とテキスト、動画の入力をネイティブでサポートし、コンテキストウィンドウは256K Tokenに達します。Ling-3.0-flash-VLは、人間のように観察しながら行動し、検証と修正を行うことで、タスクを一度きりの生成から信頼性の高い継続的な成果提供へと変革します。
02Ling-3.0-flash-VLの主な機能
リアルタイム視覚インタラクション:カメラを起動して見ながら会話し、動植物、ランドマーク、車種を識別し、外国語の標識をリアルタイムで翻訳できます。
視覚フィードバック型コーディング:Webページのスクリーンショットからフロントエンドコードを生成し、レンダリング結果と照合して自ら修正することで、Webページを再現できます。
GUI Agent:画面の構造と操作状態を認識し、Webデータの調査、Excelの整理、グラフの作成など、複数のツールをまたぐタスクを完了します。
医療レポートの解読:血液検査、生化学検査、画像検査などの複数ページ・複数期間にまたがる指標を抽出し、健康リスクを赤・黄・緑の信号で表示します。
リアルタイム学習パートナー:授業動画の映像から数式や板書を認識し、その場で質問に答え、練習問題を生成します。
長時間動画のハイライト編集:数時間に及ぶ試合動画に対して「特定→切り出し→検証→修正」を実行し、ハイライト集を自動合成します。
03Ling-3.0-flash-VLの技術原理
WeChatでフォローして「开源」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます
MoE高効率スパースアーキテクチャ:Ling-3.0-flashを拡張したモデルで、総パラメータ数は124B、推論ごとにアクティブになるのは5.5Bパラメータ בלבדです。性能を維持しながら計算コストを大幅に圧縮し、Agentワークフローの高頻度実行ノードに適しています。
ネイティブマルチモーダル共同学習:画像、テキスト、動画を同一の学習で共同最適化し、テキストを先に学習してから視覚モジュールを追加する方式ではありません。実際、視覚情報の導入はテキスト能力を低下させるどころか、Artificial Analysis Intelligence Indexで4ポイントの向上をもたらしました。
任意解像度の視覚エンコーディングとVideoRoPE:任意解像度の視覚エンコーダーを導入して異なるサイズの画像・テキスト入力を処理し、VideoRoPE位置エンコーディングと組み合わせることで、動画をフレーム分割して画像列に変換することなく、動画をネイティブに理解します。
KDAとGated MLAの混合言語バックボーン:言語部分には42層の混合アーキテクチャを採用し、線形注意機構KDAとゲート付きMLAを5:1の比率で交互に配置しています。長いコンテキストでの効率とモデリング精度を両立し、256K Tokenのコンテキストウィンドウを支えます。
視覚フィードバックの閉ループ機構:モデルは「観察→行動→検証→修正」の循環実行モードを導入し、タスクを一度きりの生成から複数ラウンドの反復へと変えます。まず視覚情報を理解して行動し、次に実行結果を観察して目標と照合し、ずれがあれば方針を修正することで、成果の信頼性と検証可能性を確保します。
04Ling-3.0-flash-VLの使用方法
オンライン体験:公式サイトを開く:Ling Studio公式サイト https://chat.ant-ling.com/chat にアクセスします。
無料利用:現在は無料体験期間中で、ログイン後すぐに対話できます。
素材のアップロード:テキストプロンプトを入力し、画像や動画をアップロードしてマルチモーダルなやり取りを行えます。
試せるシーン:Webページのスクリーンショット再現、動画への質問、写真認識などの代表的な機能を試せます。
ローカルデプロイ:モデルのダウンロード:Hugging FaceまたはModelScopeからオープンソースの重みを取得します。BF16およびFP8バージョンは利用可能で、FP4/INT4バージョンは近日公開予定です。
環境の準備:このパラメータ規模に対応した推論環境を構成します。
推論の実行:主要な推論フレームワークでモデルを読み込み、画像・テキストと動画の入力をネイティブでサポートします。コンテキストは256K Tokenまで拡張できます。
ワークフローへの接続:APIを通じて視覚Agentの実行ノードとして利用し、「観察→行動→検証→修正」の複数ラウンドのタスクフローに組み込みます。
05Ling-3.0-flash-VLの主な優位性
マルチモーダルによるテキスト能力の向上:ネイティブマルチモーダル共同学習はテキスト能力を弱めるどころか、Artificial Analysis Intelligence Indexで純粋なテキスト版を4ポイント上回りました。
視覚フィードバックの閉ループ: 「観察→行動→検証→修正」の反復メカニズムにより、タスクを一度きりの生成から、信頼性と検証可能性を備えた継続的な成果提供へと高度化します。
卓越した推論効率:総パラメータ数124Bに対し、1回の推論でアクティブになるのは5.5Bのみで、計算コストとToken消費を大幅に削減し、高頻度の複数ラウンド呼び出しに適しています。
超長コンテキスト:256K Tokenをネイティブでサポートし、長文書の解析、長時間動画の分析、複数ステップAgentの履歴記憶に容易に対応できます。
全モダリティのネイティブ入力:任意解像度の視覚エンコーダーとVideoRoPEを導入し、画像、テキスト、動画をネイティブに処理します。フレーム分割による低品質化は不要です。
実測結果も優秀:Image-to-WebDev Arenaの評価で、5.5Bのアクティブパラメータ規模ながらGPT-5.4を上回るスコアを獲得しました。
06Ling-3.0-flash-VLのプロジェクトURL
HuggingFaceモデルリポジトリ: https://huggingface.co/inclusionAI/Ling-3.0-flash-VL
https://huggingface.co/inclusionAI/Ling-3.0-flash-VL-fp8
07Ling-3.0-flash-VLの活用シーン
フロントエンド開発とWebページ再現:デザイン案のスクリーンショットから実行可能なWebページコードを生成し、レンダリング結果との比較を通じて継続的に自動修正します。
GUIによるオフィス業務自動化:Webデータの取得、Excelへの整理、グラフの自動生成など、複数のソフトウェアをまたぐタスクを実行します。
医療レポートの解読支援:血液検査、生化学検査、画像検査など複数種類のレポートを統合し、異常指標を抽出して健康リスクを赤・黄・緑で段階表示します。
オンライン教育の学習パートナー:授業動画を見ながら映像に基づいて数式や板書を解説し、その場で質問に答え、学習内容に沿った練習問題を生成します。
スポーツ試合のハイライト編集:数時間に及ぶ試合動画に対して「特定→切り出し→検証→修正」を実行し、流れのある見どころ集を自動合成します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0