
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-09
01Naive-N0.5-Flashとは
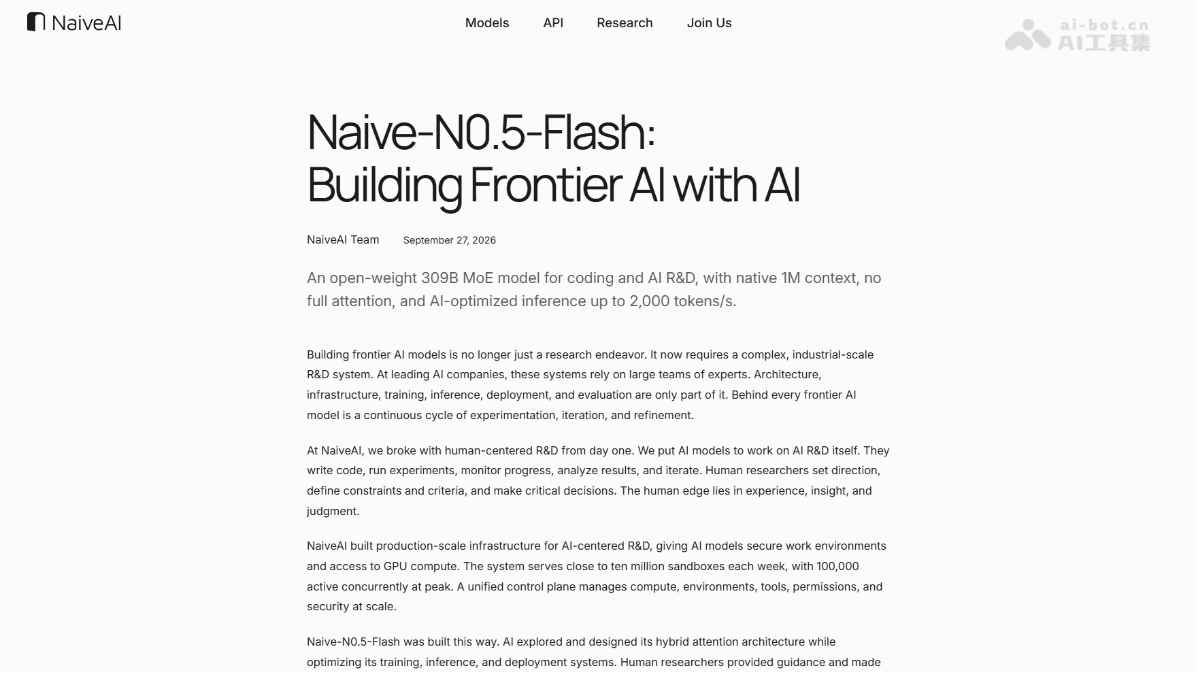
Naive-N0.5-Flashは、NaiveAIがオープンソース化した初のMoE大規模モデルで、プログラミングとAI研究開発向けに設計されています。Naive-N0.5-Flashは小米MiMo-V2.5のベースモデルを改良した309B MoEアーキテクチャで、SWA+DSA混合スパース注意機構を採用し、全注意層なしで1Mコンテキストをネイティブにサポートします。モデルの研究開発にはAIが深く関与しており、付属の推論システムNaiveRTは単一ストリームのデコードで最大2122 tokens/sを達成します。
02Naive-N0.5-Flashの主な機能
長文脈プログラミング:1M tokenのコンテキストをネイティブにサポートし、超大規模コードリポジトリや長期的なソフトウェアエンジニアリングタスクを処理できます。
AI研究開発支援:論文の読解、手法の再現、実験の実行、結果の分析が可能で、モデル研究開発の全工程に直接参加できます。
推論高速化:付属のNaiveRT推論システムにより、標準モードで50 tokens/s、超高速モードで単一ストリームのデコード最大2,122 tokens/sを実現します。
自律研究:目標、計算リソースの予算、評価プロトコルを指定すると、研究をエンドツーエンドで自律的に推進できます。
03Naive-N0.5-Flashの技術原理
WeChatでフォローし、「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
SWA–DSA混合スパース注意機構:MiMo-V2.5のベースモデルを基盤に、計算コストの高いグローバル注意層をDeepSeekのスパース注意機構に置き換え、スライディングウィンドウ注意と5:1の割合で交互に積み重ねています。ネットワーク全体に全注意層はありません。SWAは128 tokenの局所ウィンドウを処理し、DSAは軽量インデクサーで全履歴をスコアリングしてtop-2048 tokenを選び、主幹ネットワークで計算します。
軽量インデクサー設計:DSAのMLAをGQAに変更し、インデクサーのクエリヘッドを64から16に削減することで、インデックス選択経路の所要時間を44%短縮しながら、1MコンテキストのAgentタスクで性能低下を維持します。
3段階の学習プロセス:まず50B tokenで主幹ネットワークを凍結し、KLダイバージェンス損失によってインデクサーと全注意分布を整合させます。次にスパース注意へ切り替え、3T tokenの継続事前学習を行い、新たな情報選択機構に適応させるとともに、プログラミングと研究開発能力を強化します。最後に200B tokenの教師ありファインチューニングを行い、学習率を減衰させます。全工程で1Mコンテキストを維持し、top-k想起分析と数値安定性の修正をAIが自動実行します。
混合シーケンス並列化とメモリ最適化:SWAが局所ウィンドウのみを必要とし、DSAが全履歴を必要とする違いに対応するため、それぞれにHaloシーケンス並列化を採用します。メモリ面ではアクティベーションのオフロード粒度を演算子レベルまで細分化し、top-kインデックスを明示的に保持して再計算による選択結果の変化を防ぎます。512枚のGPUで約4日で1T tokenを学習できます。
NaiveRT推論最適化:巨大な演算子融合、PDLによる上下流カーネルのオーバーラップ実行、投機的デコードループのGPU上での完全実行により、1ラウンドのデコード遅延を12.3msから3.4msに短縮します。また、乱数シードに基づくビット単位の決定論的サンプリングをサポートし、RL学習におけるサンプリングと学習時logprobの一致を保証します。すべての最適化は、エンドツーエンドの実モデル経路を採用基準としています。
04Naive-N0.5-Flashの使い方
ハードウェアの確認:FP8をサポートするNVIDIA GPUが必要です。モデルの重みは約315GBで、追加のVRAMも確保する必要があります。
重みの取得:Hugging FaceからNaiveAI/Naive-N0.5-Flash-FP8リポジトリを取得します。
依存関係のインストール:pip install "transformers[torch,kernels]>=5.17.0"を実行します。
モデルの読み込み:AutoTokenizerとAutoModelForCausalLMを使用し、trust_remote_code=True、device_map="auto"を指定して読み込みます。
入力の構築:apply_chat_templateで対話メッセージを渡し、入力テンソルを生成します。
結果の生成:model.generate()で応答を生成し、tokenizer.decode()で出力をデコードします。
パラメータ設定:一般的な用途ではtemperature=1.0、top_p=0.95を推奨します。
高性能推論の再現:2,122 tokens/sの速度が必要な場合は、NaiveRTのオープンソースコード、Docker Compose環境、付属のベンチマークスクリプトを取得して自分でデプロイできます。
05Naive-N0.5-Flashの主な強み
超長文脈:1M tokenのコンテキストをネイティブにサポートし、ネットワーク全体に全注意層がないため、長系列デコードのコストが一般的なアーキテクチャより大幅に低くなっています。
卓越した推論速度:付属のNaiveRTシステムにより、単一ストリームのデコード最大2,122 tokens/sを実現し、投機的デコードの遅延をSGLangと比較して72.4%削減します。
優れた研究開発能力:PaperBench 63.2、MLE-bench-30 73.7%、NanoGPT SpeedRun 73.8sを達成し、複数のAI研究開発評価で同等クラスのモデルを上回ります。
AIネイティブ研究開発:モデルのアーキテクチャ設計とシステム最適化にAIが参加しており、人間が目標を設定し、AIが反復を実行する「AIがAIを研究開発する」パラダイムを実現しています。
自律研究の可能性:目標と予算を指定すると、研究をエンドツーエンドで自律的に完了でき、400時間の学習でAutoWM世界モデルを開発し、WorldArenaで首位を獲得しました。
06Naive-N0.5-FlashのプロジェクトURL
プロジェクト公式サイト:https://naive.ai/en/research/
GitHubリポジトリ:https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
Hugging Faceモデルリポジトリ:https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07Naive-N0.5-Flashの活用シーン
AI研究開発アシスタント:研究者による論文の読解、手法の再現、実験の実行、結果の分析を支援します。PaperBenchやMLE-benchのような研究開発タスクに活用できます。
長期的なソフトウェアエンジニアリング:ネイティブな1Mコンテキストにより、大規模コードリポジトリを処理し、ファイル横断の理解、バグ修正、リポジトリレベルのコード生成を実行します。
長文脈Agentタスク:ターミナル操作や複数回のツール呼び出しなど、長時間のインタラクションでも完全なタスク履歴を維持します。
RL学習インフラ:NaiveRTの高い単一ストリームデコード速度とビット単位の決定論的サンプリングを組み合わせ、長期的な強化学習のロールアウトを高速化し、取り残されるサンプルを削減します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0