
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-11-10
01Sophon-Realtime v1とは
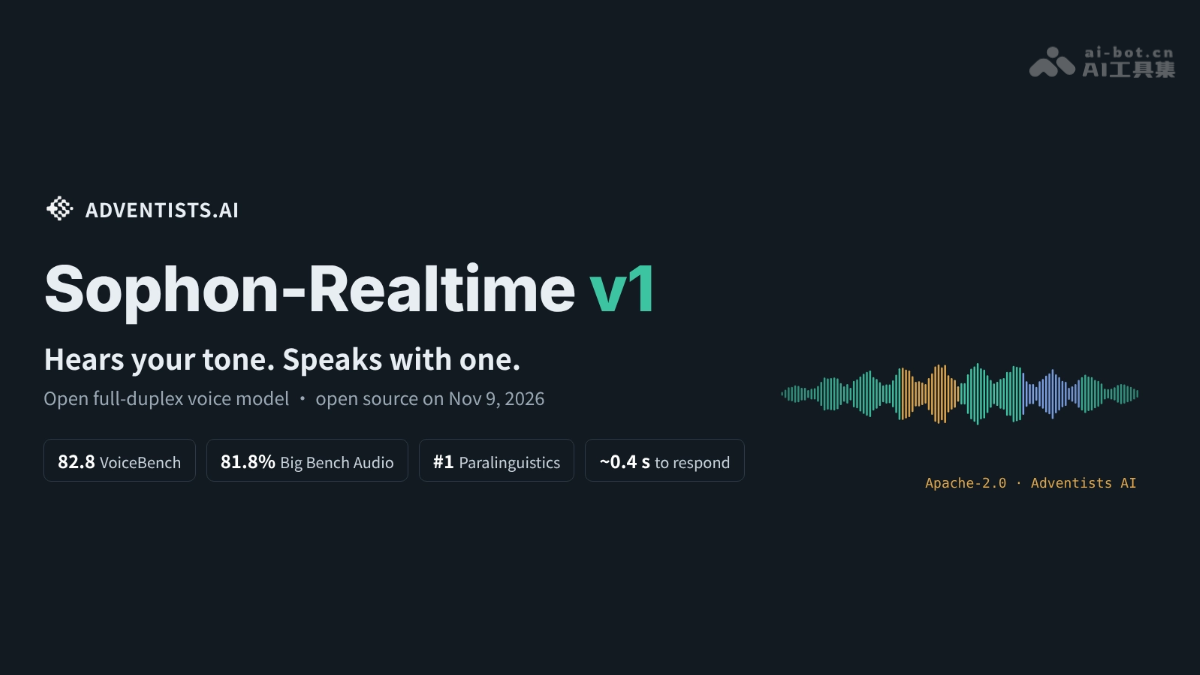
Sophon-Realtime v1は、AI降临派(Adventists AI)がオープンソースで公開する全二重音声モデルです。音声を聞きながら話者交替を判断し、いつでも割り込まれても対応できます。話し方のニュアンス、笑い声、ため息を理解し、感情のこもった声で応答します。Sophon-Realtime v1は32Bパラメータを基盤とし、音声評価ベンチマークVoiceBenchで82.8点を獲得し、オープンソースの全二重モデルで首位となっています。Sophon-Realtime v1には、表現力に優れたTag、高速応答のFlash、研究プレビュー版のE2Eという3つのバージョンがあり、80GB GPU 1枚でデプロイできます。Apache-2.0ライセンスを採用しており、商用利用も可能です。
02Sophon-Realtime v1の主な機能
全二重対話:話している間も聞き続け、話し終わるとすぐに応答します。いつでも割り込めるため、新しい質問を受けると直ちに回答を停止します。
語調の理解:ためらい、強調、笑い声、ため息、反語などのパラ言語情報を認識し、文字どおりの内容だけにとどまりません。
語調の表現:応答時の音声に、自然な笑い、ため息、咳払い、息継ぎなどを加え、文字を読み上げるだけではありません。
マルチモーダル理解:図表やスクリーンショットを見せると、その内容を読み取り、口頭で解説できます。
ツール呼び出し:複数ステップのツール呼び出しに対応し(Full-Duplex-Bench v3 Pass@1は48%)、実際の作業を実行できます。
Liveモード:OpenAI GPT-Liveプロトコルに対応し、大規模モデルのバックエンドと連携できます。
高速デプロイ:1つのコマンドと80GB GPU 1枚で稼働でき、Flash版の初回パケットはわずか0.31秒です。
微調整可能:ms-swiftとLoRAを使って、ペルソナ、話し方、専門知識、ツール呼び出しの習慣を微調整できます。
03Sophon-Realtime v1の技術原理
04Sophon-Realtime v1の使い方
環境の準備:システムがLinux + CUDA + Python 3.12であることを確認し、pip install sophon-realtimeを実行します。
サービスの起動:sophon-realtime serveを実行すると、初回起動時に約42GBのTag重みが自動ダウンロードされ、その後サービスが8000番ポートで待ち受けます。
APIの呼び出し:ws://HOST:8000/v1/realtime(全二重)またはPOST /v1/chat/completions(音声入力、テキスト+音声出力)を通じてモデルとやり取りします。
対話のテスト:python client_example.py --wav 私の質問.wav --lang zh --voice vivian_zhを実行して音声を送り、応答を聞きます。
Liveモードへの接続(任意):エンジンの横でcd sophon-realtime/live && BUILD=tag PORT=8000 LIVE_PORT=8780 bash start_live.shを実行すると、OpenAI GPT-Liveプロトコルで独自のバックエンド大規模モデルに接続できます。
微調整とカスタマイズ(任意):ms-swiftを使い、LoRA方式で80GB GPU上で学習します。jsonl形式の対話データ(音声を記述し、応答に[laughter]などのタグを付加)を用意し、swift sftコマンドを実行すると、ペルソナや専門知識を変更できます。
05Sophon-Realtime v1の主な強み
オープンソース全二重モデルで首位:VoiceBenchで82.8点を獲得し、GPT-4o-mini-Audioと同等のスコアを達成。MiniCPM-o 4.5(76.1)など、他のオープンソース全二重モデルを上回ります。
音声推論が最強:1,000問の音声推論問題Big Bench Audioで正答率81.8%を達成し、従来最高のオープンソースモデルRaon SpeechChat(58%)を大きく上回ります。
語調を理解:聴覚モデルDuplexJevが、LISTEN、StressTest、MSPBのパラ言語ベンチマークで総合首位(48.6)となり、Gemini 3.8 FlashやQwen3-Omniを上回ります。
語調を表現:NVV-SuperBenchでTag版は中国語0.86、英語0.80を達成し、笑い声、ため息、咳払いなどの表現が最も自然です。
実際の作業に対応:Full-Duplex-Bench v3のツール呼び出しでPass@1が48%に達し、Grok(43%)を上回ります。応答すべきタイミングでは100%応答します。
高速で高い同時処理性能:Flash版の初回パケットは0.31秒で、1枚のGPUで40同時接続に対応。Tag版は約0.6秒で、16同時接続に対応します。
06Sophon-Realtime v1のプロジェクトURL
GitHubリポジトリ:https://github.com/adventists-ai/sophon-realtime
07Sophon-Realtime v1の活用シーン
インテリジェントカスタマーサービス:Flash版は初回パケット0.31秒、1枚のGPUで40同時接続に対応し、顧客の感情を理解しながら複数ステップのツール呼び出しで業務を処理できます。大規模なコールセンターに適しています。
AIコンパニオンとバーチャルキャラクター:Tag版は音声表現力が最も高く、笑いやため息にも対応します。感情的な伴侶、バーチャル恋人、ゲームNPCに適しています。
車載音声アシスタント:全二重でいつでも割り込め、低遅延で応答します。ウェイクワードが不要で、語調を理解してドライバーの状態判断も支援できます。
AIハードウェア端末:チームの技術はすでに300以上のハードウェア製品に導入されています。Apache-2.0ライセンスで商用利用でき、スピーカー、玩具、ロボットなどの機器への組み込みに適しています。
企業向け音声エージェント:LiveモードはGPT-Liveプロトコルに対応し、Sophonが「聞く・話す」を担当し、検索や業務処理をバックエンドの大規模モデルに任せます。銀行、行政、航空などの業界向けカスタムサービスに適しています。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0