
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-17
01Spark-Audio-1.0-Previewとは
Spark-Audio-1.0-Previewは科大訊飛が開発した完全国産の音声基盤大規模モデルです。0.65B音声エンコーダー+30B-A3B MoE言語モデルアーキテクチャを採用し、1300万時間の音声と大量のテキストデータを用いて、純国産コンピューティングリソースでトレーニングされています。モデルは音声に含まれる意味、感情、状況を直接理解でき、99言語、202方言の認識に加え、音声文字起こし、翻訳、話者識別、感情分析、音声に関する質問応答などのタスクに対応します。高ノイズや小音量などの複雑な状況でも優れた性能を発揮し、カスタマーサービス、車載システム、医療など幅広い分野で活用できます。
02Spark-Audio-1.0-Previewの主な機能
音声文字起こし:音声を直接テキストに変換し、99言語と202方言の認識に対応します。
多言語翻訳:音声から音声/テキストへの言語間翻訳を実現し、口調やイントネーションなどの韻律情報を保持します。
多方言認識:202方言をカバーし、広東語や温州語なども理解できます。
環境音認識:人の声と周囲の環境音を同時に聞き分け、音が発生した状況を理解します。
話者識別:誰が話しているかを自動的に区別し、会議の文字起こしや議事録作成などに適しています。
感情分析:音声に含まれる口調や感情を捉え、より「温かみのある」インタラクションを実現します。
音声質問応答:複雑な音声内容を理解して質問に回答し、「聞き取る」から「理解する」へと進化させます。
03Spark-Audio-1.0-Previewの技術原理
エンドツーエンド音声理解アーキテクチャ:従来の「まず文字に変換してから大規模モデルに渡す」カスケード方式とは異なり、0.65B音声エンコーダーと30B-A3B大規模言語モデルを組み合わせ、テキストと音声の2モダリティを同一モデルに直接入力します。これにより、人の声、環境音、音楽、およびそれらの意味、感情、状況を一度に理解し、カスケード経路における情報損失やエラーの蓄積を回避します。
音声エンコーダーの事前学習:音声エンコーダーの事前学習によって表現能力を段階的に拡張し、さらに事前学習と事後学習によってモデルの基礎能力、複雑な状況への汎化性能、多タスク性能を向上させます。最終的に、高ノイズや小音量などの現実の複雑な状況で優れた成果を達成しています。
完全国産コンピューティングリソースによる学習:純国産コンピューティングリソースのクラスターを基盤に、1300万時間の音声と大量のテキストデータで学習しています。業界初の全工程を国産コンピューティングリソースで学習した音声基盤大規模モデルであり、国産コンピューティングリソースによって業界最高水準の音声モデルを学習できることを実証しました。
微調整可能な基盤体系:訊飛星火大規模モデルの1+N体系と同様に、Spark-Audioは音声基盤としてさらに微調整できます。音声認識、音声同時通訳、音声インタラクションなどの専用モデルやシステムを開発でき、さまざまな音声業務への導入を容易にします。
04Spark-Audio-1.0-Previewの使用方法
公式体験ページを開く:モデル体験ページ https://iflytekresearch.iflytek.com/experience/spark-audio にアクセスします。
モデルの機能をオンラインで体験する:ページ上でテキストまたは音声を入力し、音声文字起こし、翻訳、方言認識、音声質問応答などの機能を体験します。
05Spark-Audio-1.0-Previewの主な優位性
完全国産コンピューティングリソースによる学習:純国産コンピューティングリソースのクラスターで学習した業界初の音声基盤大規模モデルであり、国産コンピューティングリソースによって業界最高水準のモデルを学習できることを実証しています。
音声をエンドツーエンドで直接理解:まず文字に変換してから理解するカスケード方式から脱却し、口調、感情、環境音などの重要情報を失わず、処理経路の分断や遅延、途切れを解消します。
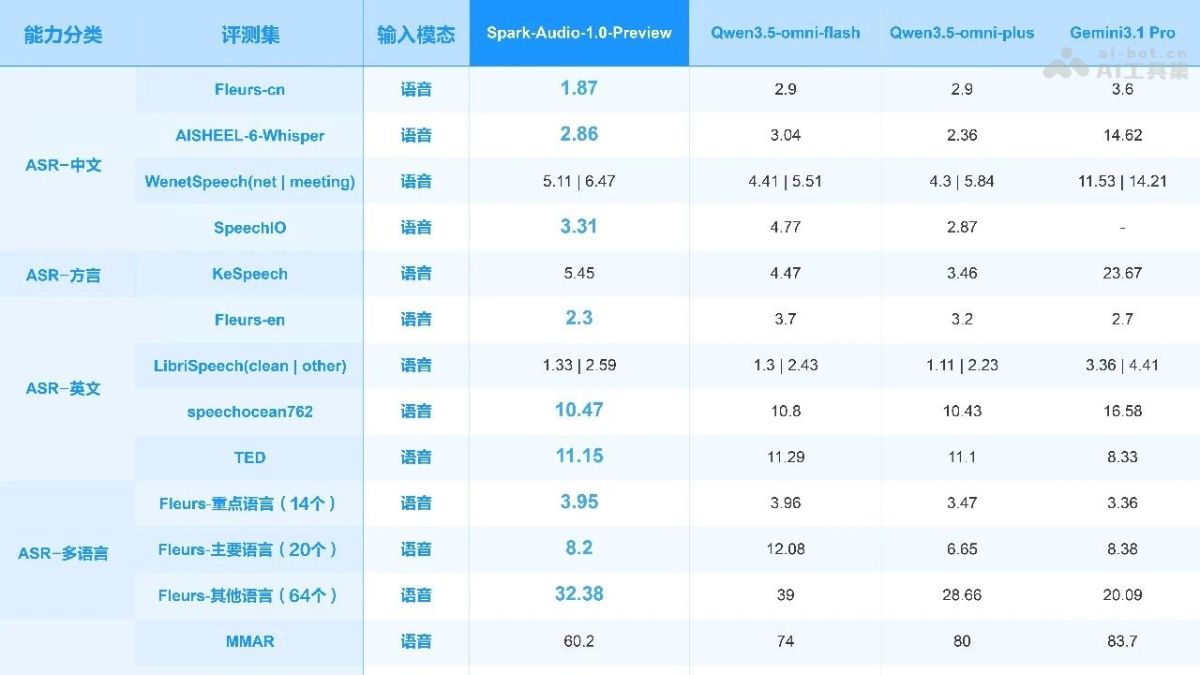
幅広い多言語・多方言対応:99言語と202方言の認識に対応し、同規模モデルとの比較で多言語・多方言認識性能に優れています。
複雑な状況で優れた性能:高ノイズや小音量など、実際のアプリケーションに近いタスクで明確な優位性を示し、ノイズ耐性に優れています。
より大規模なモデルに引けを取らない性能:規模が1桁大きいQwen3.5-omni-plusに近い性能を実現し、Fleurs中国語テストセットでSOTAを達成しています。複数の評価でGemini-3.1 Proを上回るスコアを獲得しています。
テキスト能力を維持:一般知識、数学、コードなどのテキストタスクで明らかな性能低下は見られず、音声基盤モデルにありがちな課題を克服しています。
効率的なアーキテクチャ:0.65B音声エンコーダー+30B-A3B MoEアーキテクチャを採用し、小規模でありながら、より大規模なクローズドモデルに近い性能を実現します。
06Spark-Audio-1.0-Previewの活用シーン
スマートカスタマーサービス:ユーザーの感情や表現方法を認識し、より自然で温かみのある対話を実現して、サービス体験を向上させます。
自動車コックピット:車内の騒がしい環境でもドライバーの指示を正確に認識し、方言によるインタラクションにも対応して、より自然な車内音声体験を実現します。
リアルタイム翻訳・多言語会議:音声同時通訳や多言語翻訳を行いながら、口調やイントネーションなどの韻律情報を保持し、より自然な異言語コミュニケーションを実現します。
会議の文字起こし・議事録作成:話者を自動的に区別し、重要な意思決定事項を抽出して構造化された議事録を作成することで、担当者の繰り返し作業を削減します。
医療電子カルテ・コンテンツ審査:音声でカルテの記録やコンテンツ審査を行い、医療などの専門分野で手入力の負担を軽減し、効率を高めます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0