
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-24
01Qwen-Audio-3.1とは
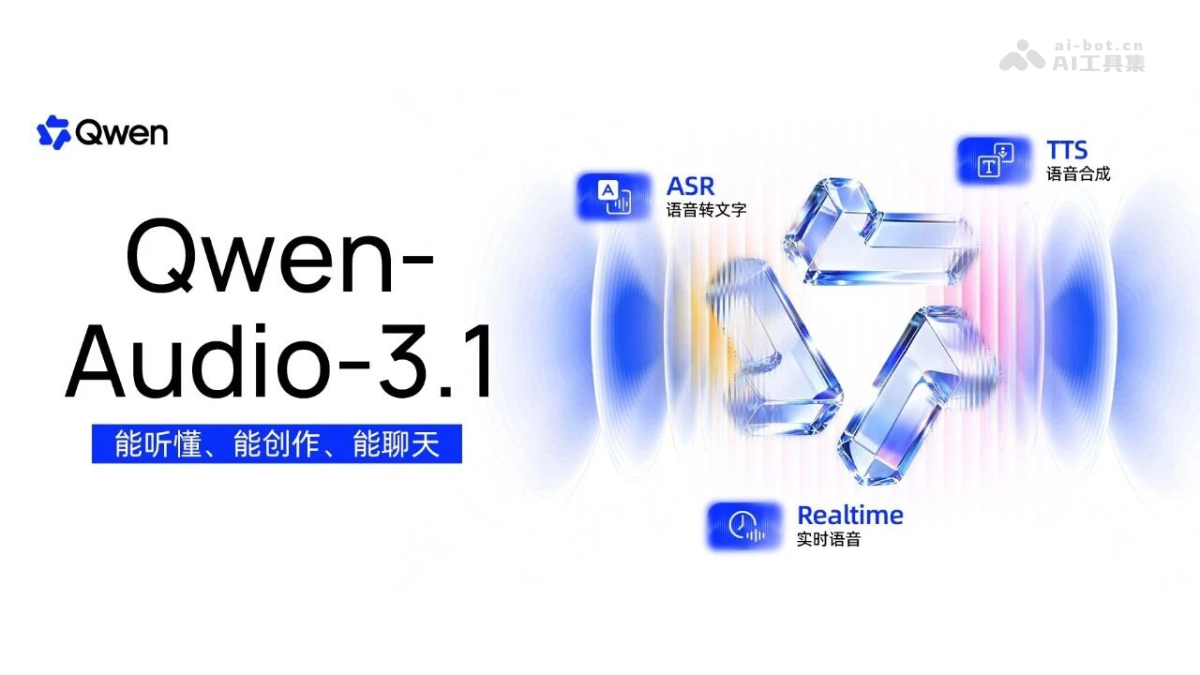
Qwen-Audio-3.1は、通義千問が提供する音声大規模モデルシリーズです。ASR音声認識、ASR-Nextオーディオ理解、TTS音声合成、TTS-Nextオーディオ制作、Realtimeリアルタイムインタラクションの5つのモデルで構成され、理解・生成・インタラクション・制作の全工程をカバーします。Qwen-Audio-3.1は30言語と16種類の中国語方言に対応し、話者分離文字起こし、感情認識、全二重リアルタイム対話が可能で、ツールを呼び出してタスクを実行できます。
02Qwen-Audio-3.1の主な機能
ASR音声認識:30言語と16種類の中国語方言による話者分離文字起こしに対応し、話者ラベルとタイムスタンプを付与できます。テキストの自然な校正にもネイティブ対応します。
ASR-Nextオーディオ理解:文字起こしから、人物の感情、環境音、機械音の理解へと対象を拡張し、音声の説明、イベント位置特定、音声による質疑応答に対応します。
TTS音声合成:多言語・多方言の合成に対応し、同じ声質を言語間で自然に移行できます。指示による感情や話速の制御も可能です。
TTS-Nextオーディオ制作:人の声、効果音、環境音で構成された完成度の高い音声を一度に生成します。ポッドキャスト、オーディオブック、映像、ゲーム、広告に適しています。
Realtimeリアルタイムインタラクション:聞く・話すを同時に行う全二重通信に対応し、感情や意図を理解して多言語を切り替えられます。対話中にツールを呼び出してタスクを実行することも可能です。
03Qwen-Audio-3.1の技術原理
エンドツーエンドの統合モデリング(ASR):Qwen-Audio-3.1-ASRはエンドツーエンド方式を採用し、話者ラベル、タイムスタンプ、文字起こしテキストを一体的に出力します。従来のカスケードシステムのように段階的に処理しないため、短い割り込み発話や重複音声を保持できます。さらに、フィラー除去、重複除去、自己修正、意味の再構成機能を内蔵し、会議記録や対話分析にそのまま使える構造化された文字起こし結果を生成します。
次世代オーディオ理解アーキテクチャ(ASR-Next):ASR-Nextは次世代アーキテクチャに基づき、処理対象を「音声中の文字」から完全な音声信号へと拡張します。音響レベルの感情、環境音、機械音を理解することで、音声イベントの位置特定、説明、推論を実現し、ASRを文字起こしツールから汎用オーディオ理解モデルへと進化させます。
声質の移行と表現制御(TTS):TTSモデルは、文字と発音の正確さだけを追求する従来の合成方式を超え、同じ声質で言語や方言をまたぐ自然な移行を実現します。感情、話速、表現方法を指示によってモデル化し、内容や場面に合った合成音声を生成します。
統合オーディオ生成(TTS-Next):TTS-Nextは、テキスト、タイムスタンプ、参照音声の3種類の入力をもとに、人の声、効果音、環境音を統合的に生成します。複数ターンの対話でも各役割の声質と感情の一貫性を保ち、自然言語で生成プロセスを制御できます。高精度なタイムスタンプ制御、声の複製、48kHzの高音質出力にも対応します。
複数教師蒸留による全二重アーキテクチャ(Realtime):Realtimeは複数教師蒸留アーキテクチャを採用し、低遅延を維持しながら理解、推論、表現、安全性を向上させます。話す・聞くを同時に行う全二重インタラクションを実現し、いつでも割り込みや中断が可能です。ツール呼び出し機能も統合されており、継続的な対話の中で変化するニーズを理解し、外部API、ナレッジベース、業務システムと接続してタスクを完了できます。
04Qwen-Audio-3.1の使い方
千問AIプラットフォームを開く:https://www.qianwenai.com/ にアクセスしてアカウントにログインし、モデル広場に移動します。
必要なモデルを選択:用途に応じて、ASR(文字起こし)、TTS(合成)、TTS-Next(制作)、Realtime(リアルタイムインタラクション)から該当するモデルを選び、詳細ページを開きます。
API Keyを取得:コンソールでモデルサービスを有効化し、API Keyを作成してAPI認証に使用します。
APIを呼び出す:各モデルの詳細ページにあるAPIドキュメントを参照し、HTTPリクエストで音声またはテキストのパラメータを渡します(ASR-Next APIはまだ公開されていないため、公開を待つ必要があります)。
アプリケーションに統合:APIを独自のアプリケーション、Agent、スマートハードウェアに接続すると、音声タスクをオンラインで実行できます。
05Qwen-Audio-3.1の主な強み
多言語・方言への高い対応力:1つのモデルで30言語と16種類の中国語方言に対応し、温州語など聞き取りが難しい方言の認識精度が特に向上しています。
インテリジェントな文字起こし校正:ASRがフィラー除去、重複除去、意味の再構成をネイティブで行い、より滑らかで論理的な構造化テキストを出力します。
高精度な話者分離文字起こし:話者ラベル、タイムスタンプ、テキストをエンドツーエンドで出力し、Fun-ASRのカスケードシステムを全面的に上回ります。
オーディオ理解の進化:ASR-Nextは感情、環境音、機械音を理解し、「文字起こし」から「完全な音声の理解」へと進化しています。
一体化された制作機能:TTS-Nextは人の声、効果音、環境音を一度に生成し、複数の役割の声質と感情を一貫させます。複数人で分担するポストプロダクション工程を代替できます。
人間らしいリアルタイムインタラクション:全二重で聞く・話すを並行して行い、割り込みや中断に対応します。感情を認識し、ツールを呼び出してタスクを実行できます。
低遅延・高性能:ストリーミング認識の初回文字応答は約160ミリ秒。Realtimeは複数教師蒸留により、低遅延と推論能力を両立しています。
06Qwen-Audio-3.1のプロジェクトURL
オンライン体験デモ: Qwen-Audio-3.1-ASR:https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS:https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next:https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime:https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07Qwen-Audio-3.1の活用シーン
会議議事録・インタビュー記録:ASRの話者分離文字起こしとタイムスタンプ機能を使い、「誰がいつ何を話したか」を構造化された記録として自動出力します。フィラーなどの口語的なノイズも自然に除去でき、会議の効率を大幅に高めます。
ポッドキャスト・オーディオブック制作:TTS-Nextで複数人の会話、効果音、環境音を含む完成音声を一度に生成します。複数の役割の声質と感情を一貫させ、ナレーター、音響効果担当、ミキサーによる分業を省けます。
リアルタイム音声カスタマーサービス・スマートアシスタント:Realtimeの全二重インタラクションと感情認識機能に基づき、割り込みに対応し共感を示せる音声カスタマーサービスを構築できます。対話中に業務システムを呼び出し、照会や注文などのタスクも実行できます。
海外旅行・多言語コミュニケーション:30言語のリアルタイム切り替えと、同じ声質で言語間の合成を行う機能により、旅行計画、越境EC、国際会議に自然でスムーズな音声翻訳・交流体験を提供します。
AIスマートハードウェア:QwenNoteや千問AIグラスなどのハードウェアと連携し、パソコンやスマートフォンを開かずに、音声でタスクの開始、条件の追加、実行状況の追跡ができます。音声をAIハードウェアの自然な入口にします。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0