
すべてのAIツール
AI音声認識
音声認識分野の注目AI製品を掲載しています。作成、処理、効率化など一般的な利用シーンに対応します。
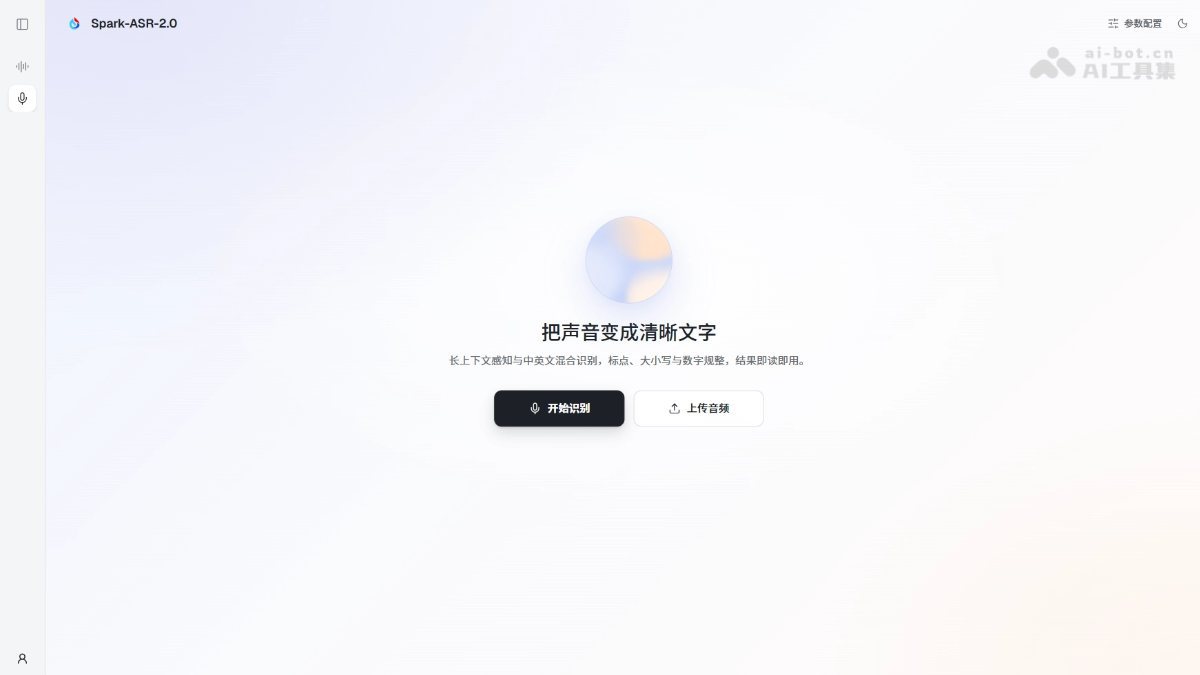 Spark-ASR-2.0AI音声認識Spark-ASR-2.0は、科大訊飛が星火音声基盤大規模モデルSpark-Audioを基に開発した最新世代の音声認識大規模モデルです。モデルは「非自己回帰+LLM強化自己回帰」の協調アーキテクチャを採用し、中国語と英語の混在、方言、専門...00
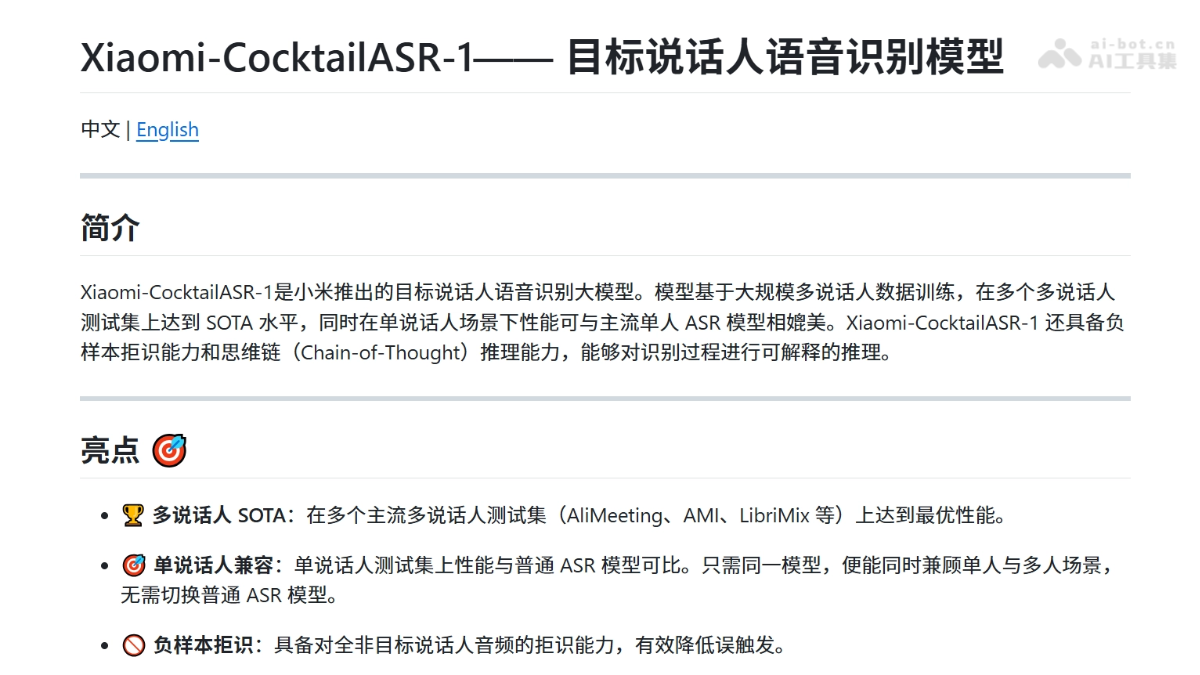 Xiaomi-CocktailASR-1AI音声認識Xiaomi-CocktailASR-1は、Xiaomiがオープンソースで公開するターゲット話者音声認識の大規模モデルです。LLMエンドツーエンドアーキテクチャに基づき、参照音声を話者特徴のプロンプトとして使用します。音声分離なしで、複数人の混合音声からターゲット話者の発話を正確に書き起こせます…00
 MAI-Transcribe-2AI音声認識MAI-Transcribe-2は、Microsoftが提供する最強のAI音声テキスト変換モデルで、精度、速度、コストのすべてで優れています。60言語に対応し、FLEURSテストセットでの平均単語誤り率はわずか5.2%です。00
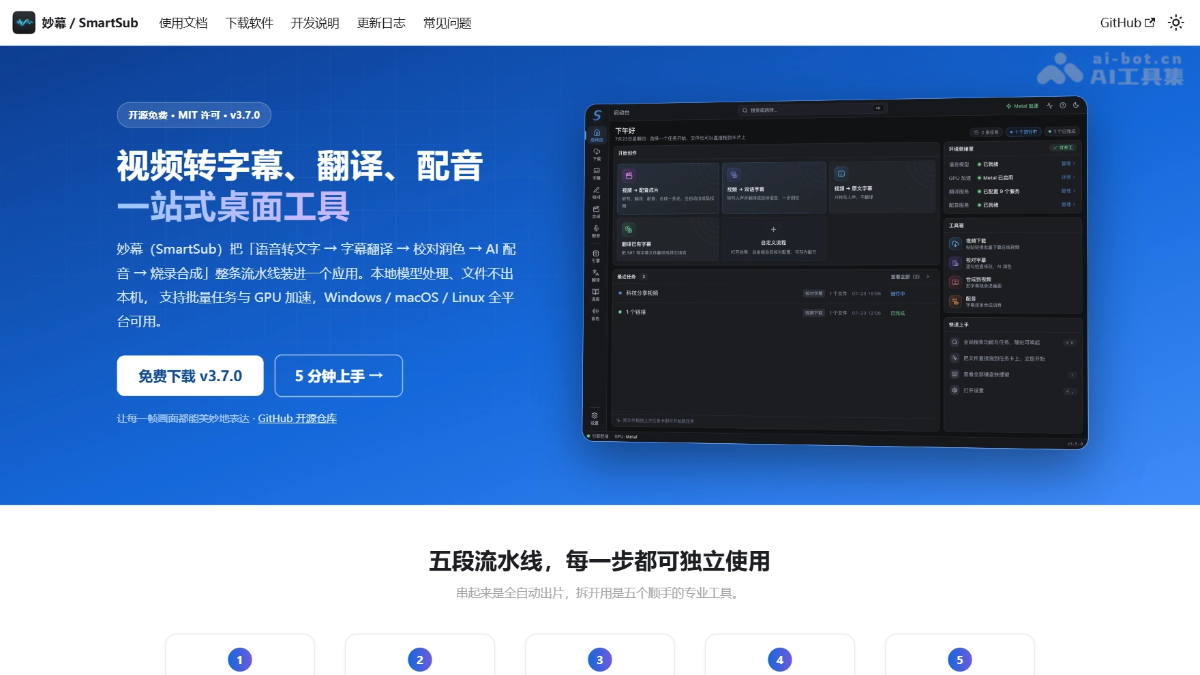 SmartSub – オープンソースのオールインワン音声・動画字幕処理デスクトップツールAI音声認識SmartSub(妙幕)は、オープンソースのオールインワン音声・動画字幕処理デスクトップツールです。音声・動画処理の全工程を1つのアプリに統合し、Whisper、FunASR、Qwen3-ASRなどのローカルモデルによるオフライン音声認識に対応。20種類以上の翻訳サービスと、複数話者によるAI音声合成を利用できます。オンライン動画ダウンローダーを内蔵し、Bilibili、YouTubeなどのプラットフォームに対応。NVIDIA CUDA、Apple Core MLなどのハードウェアアクセラレーションをサポートし、Windows、macOS、Linuxの3つのプラットフォームでローカル実行できます。00
 Hy ASR 3.0 preview – Tencent Hunyuanが提供する次世代音声認識モデルAI音声認識Hy ASR 3.0 preview – Tencent Hunyuanが提供する次世代音声認識モデルは、Hy3大規模言語モデルを基盤とする次世代音声認識システムで、高精度な音声認識と深い意味理解を融合しています。中国語、英語、広東語および10の主要方言地域に対応し、文脈に基づくインテリジェントな誤認識補正、ホットワード注入、高ノイズ・ささやき声などの複雑な環境における高い堅牢性を備えています。オープンソース評価セットではWERを約3%に抑え、自社評価セットでは競合製品を全面的に上回っています。インテリジェントカスタマーサービス、コンテンツ制作、音声検索、オフィスコラボレーション、スマートデバイスなどのシーンに適しており、Tencent Cloud API経由で接続できるほか、Tencent Yuanbaoで無料体験できます。00
このカテゴリーのすべてのツールを表示しています。