
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-21
01Layaとは
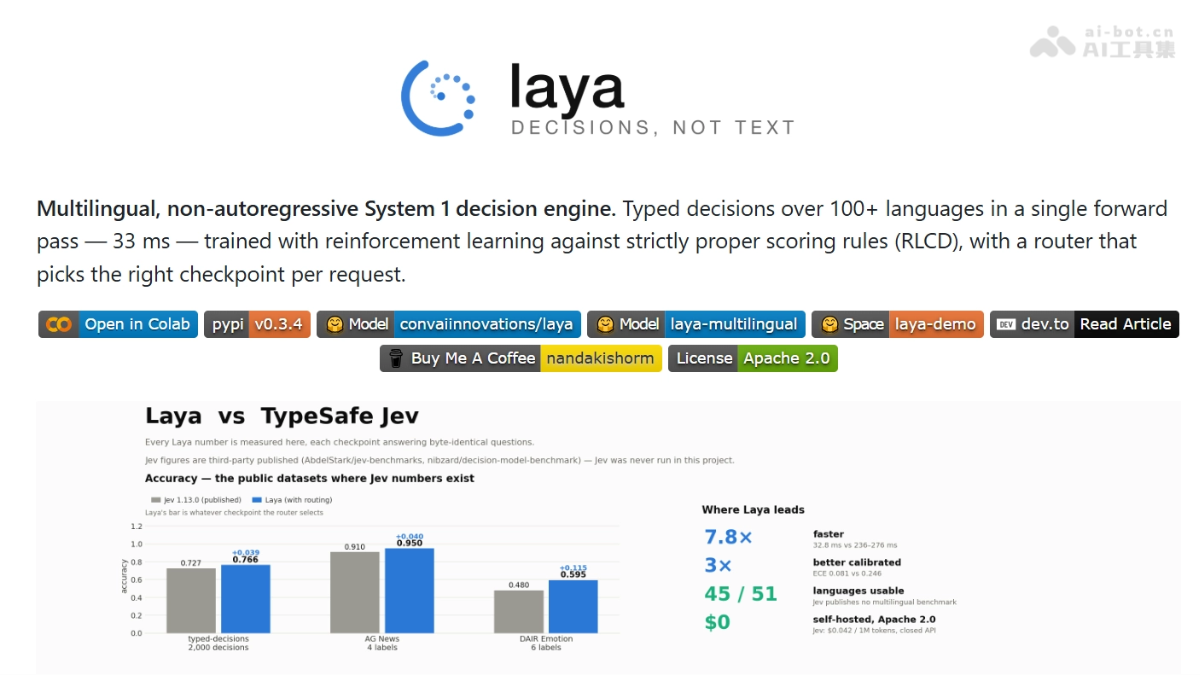
Layaはオープンソースの非自己回帰型AI意思決定モデルです。テキスト生成は行わず、ModernBERT/mmBERT双方向エンコーダーを基盤に、テキストと型付き質問に対して1回のフォワードパスのみを実行し、約33msで構造化された結果と校正済み確率を出力します。モデルには100以上の言語をサポートする言語ルーティングが組み込まれています。クローズドモデルのJevと比較して、Layaは精度(76.6%対72.7%)、多言語対応(100以上の言語)、コスト(ローカル展開は無料)で優れています。
02Layaの主な機能
1回のフォワードパスによる意思決定:状態と型付き質問の組を入力すると、テキスト生成を行わず、1回のフォワードパスで構造化された結果を直接返します。処理時間は約33msです。
3種類の意思決定プリミティブ:choiceは候補から1つを選び、各項目の確率を返します。scoreは順序尺度でスコアを付け、分布を返します。noulはYes/No形式の質問に回答し、成立確率を0~1で返します。
自動言語ルーティング:Routerが0.5ms未満で入力の文字体系と言語を検出し、英語または多言語チェックポイントへ自動的に振り分けます。モデルの選択ミスによる「自信満々の誤答」を防ぎます。
信頼度ゲーティング:確率はRLCDトレーニングにより統計的な意味を持つため、しきい値に基づいて高信頼の意思決定を自動承認し、低信頼のものを人手に回せます。
組み込みワークフロープリセット:モデルルーティング、プロンプトインジェクション対策、コンテンツ安全性審査、チケット振り分けなどの問題テンプレートを提供し、すぐに利用できます。
ローカル微調整:Kaggle notebookが付属し、自前データによるデータ生成、RLCDトレーニング、温度フィッティング、評価までの一連の微調整フローに対応します。
03Layaの技術原理
WeChatで「開源」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます
双方向非自己回帰アーキテクチャ:ModernBERT-large(421M)またはmmBERT-base(322M)の双方向エンコーダーを基盤とし、入力トークンは前後の文脈を同時に参照できます。推論時にはテキストを1文字ずつ生成せず、各候補に独立した[MASK]位置を割り当て、1回のフォワードパスですべての候補のlogitを出力し、Softmaxで確率分布に正規化します。これが33ms級の遅延を実現する要因です。
RLCD強化学習トレーニング:対数スコア、球面スコア、順位確率スコアなどの厳密な真値スコアリング規則を報酬として使用します。モデルは真の事後確率を出力した場合にのみ高得点を得られるため、不確実な場合は信頼度が自然に低下し、従来の大規模モデルに見られる「盲目的な自信」の問題を防ぎます。
言語ルーティング機構:Routerはforwardの前に純粋なPythonでUnicode文字セットと言語を検出し、それに基づいてチェックポイントを選択します。英語チェックポイントは非ラテン文字に対して、信頼度0.95で正解率0の回答を返すことがあるため、信頼度自体では事前警告できません。そのため、ルーティングの判断は推論前に完了する必要があります。
確率校正:出荷時のチェックポイントには過信の傾向があるため、(質問タイプ、選択肢数)ごとに自前データで温度をフィッティングする必要があります。フィッティング後、平均ECEは0.466から0.081まで低下し、この時点で初めて確率を自動承認の判断に直接利用できます。
04Layaの使い方
インストール:pip install laya。PyPIパッケージで、2日間で0.1.0から0.3.4へ更新されています。インターフェースは現在も変更中です。
モデルの読み込み:Router(preload=True)で3つのチェックポイントを事前読み込みし、言語切り替えのたびにモデルを再構築するコールドスタートを避けます。
状態の準備:分析対象のテキストを{"from": ..., "subject": ..., "body": ...}のようなdictにまとめます。任意の言語またはJSON構造に対応します。
質問の定義:JSONで型付き質問のセットを記述し、type(choice / score / noul)、instructions、criteria(選択肢または尺度)を指定します。
予測の実行:router.predict(state, questions)を呼び出すと、1回のフォワードパスですべての回答を返します。英語はlayaを使用し、Hindiなどは自動的にmultilingualへ振り分けられます。
結果の取得:res["answers"]からchoiceのラベル、scoreの値、またはnoulの確率を取得します。res["routing"]には、そのチェックポイントが選択された理由が示されます。
信頼度ゲーティング:confidenceにしきい値(例:0.85)を設定し、高信頼のものは自動処理、低信頼のものは人手に回します。ただし、事前に自分のデータで温度フィッティングを行っていることが前提です。
05Layaの主な強み
高速推論:1回のフォワードパスは約33ms(T4)で、バッチ処理では最短7.2ms/問です。クローズドモデルのTypeSafe Jevより約7.8倍高速です。
幻覚リスクゼロ:テキストを生成せず、構造化された意思決定だけを出力するため、解析の負担がなく、内容を捏造する問題もありません。
校正可能な確率:RLCDの厳密な真値スコアリング規則でトレーニングされているため、信頼度は統計的な意味を持ち、自動承認や人手確認のフローを直接駆動できます。
校正精度で優位:温度フィッティング後のECEはわずか0.081で、Jevの0.246を上回ります。typed-decisionsの精度も0.766で、Jevの0.727を超えています。
多言語ルーティング:組み込みのRouterが100以上の言語をサブミリ秒単位で識別し、チェックポイントを自動選択します。非ラテン文字に対する英語モデルの「自信満々の誤答」を防ぎます。
完全オープンソースで無料:Apache-2.0ライセンス、重みを公開、自前運用に対応しています。Jevの$0.042/百万tokenのAPI料金と比べ、長期的な利用コストはゼロです。
型付き出力:choice / score / noulの3種類のプリミティブで、分類、スコアリング、Yes/No判定をはじめ、構造化された意思決定の大半の場面をカバーします。
06LayaのプロジェクトURL
GitHubリポジトリ:https://github.com/NandhaKishorM/laya
HuggingFaceモデルリポジトリ:https://huggingface.co/convaiinnovations/laya
07Layaの活用シーン
カスタマーサポートチケットの自動振り分け:担当部署(billing/technical/sales)、緊急度、ユーザーの苛立ち、離脱リスクを判定し、高信頼のものは自動で割り当て、低信頼のものは人手に回します。
コンテンツの安全性とモデレーション:有害性、嫌がらせ、脅迫的な内容を検出します。noulプリミティブで違反確率を出力し、コミュニティやUGCプラットフォームのリアルタイム審査に適しています。
プロンプトインジェクション対策(Guardrails):Agentシステムの入口で、脱獄、インジェクション、秘密鍵の漏えいなどの攻撃を検出します。33ms級の遅延により、各リクエストの処理経路に組み込めます。
インテリジェントなモデルルーティング:大規模モデルを混在させたアーキテクチャで、リクエストを小規模モデルと最先端モデルのどちらに送るべきかを判定します。極めて低コストで振り分けを行い、推論費用を削減できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0