
- 月間訪問数
- 0
- 料金
- 無料、有料
- 掲載日
- 2026-08-13
- 更新済み
- 2026-08-13
01dots.ttsとは
dots.ttsは、小紅書のdotsチームと上海交通大学X-LANCE研究室が共同でオープンソース化した、20億パラメータの完全連続自己回帰音声合成基盤モデルです。モデルは連続潜在空間で48kHz音声を直接パッチ単位で生成し、Seed-TTS-Evalなどのベンチマークで音色類似度と内容正確度のSOTAを達成しています。ゼロショット音声クローン、ストリーミング出力、低遅延の双方向対話に対応します。プロジェクトのコードと重みを完全公開し、dots.tts.editによる高精度な音声編集機能も拡張しています。
02dots.ttsの主な機能
ゼロショット音色クローン:3~10秒の参照音声だけで、その音色のまま任意の新しいテキストを読み上げられます。多言語クローンにも対応し、Seed-TTS-Evalベンチマークで内容正確度と話者類似度のSOTA性能を達成しています。
テキスト音声合成:ランダムな音色のサンプリングから指定話者による高品質な音声生成まで提供します。2Bパラメータの連続自己回帰モデルに基づき、48kHz音声を直接出力します。
ストリーミング生成と低遅延インタラクション:ネイティブにストリーミング出力へ対応し、テキストの先頭部分を入力すると音声をパッチ単位で生成できます。1T1Aの二重ストリームモードでは、上流のLLMがテキストTokenを1つ出力するたびに音声側が即座に応答し、音声の初回パケット遅延は最短54.4ミリ秒です。リアルタイム音声Agentや双方向対話に適しています。
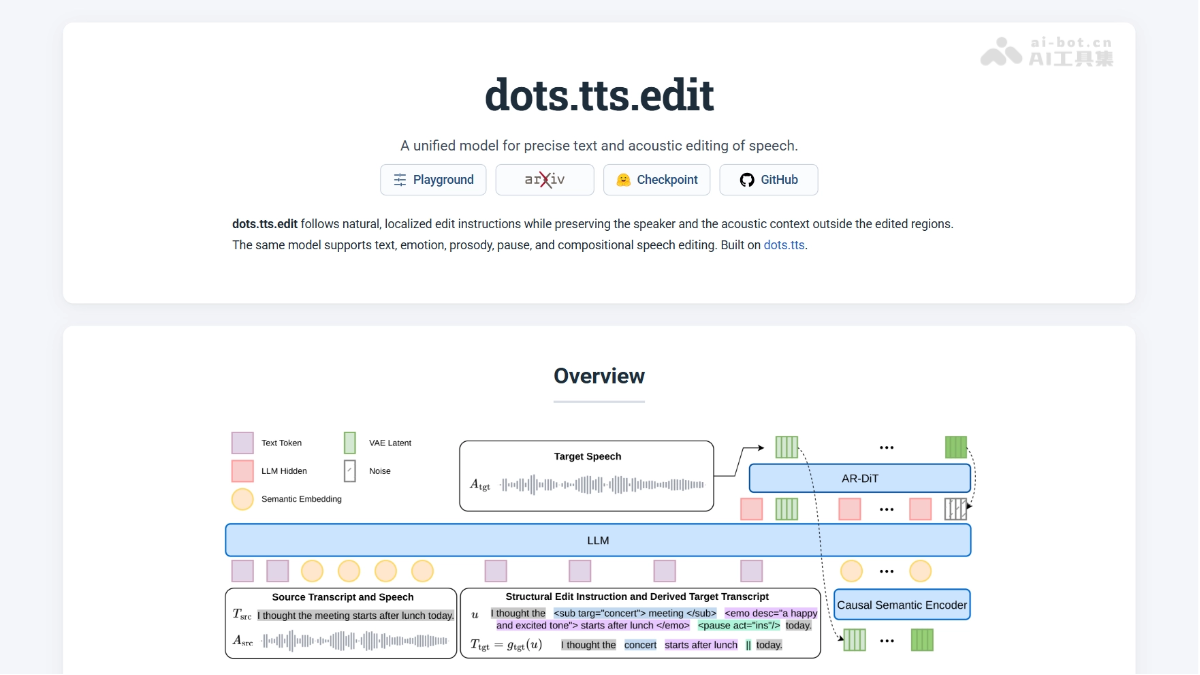
高精度な音声編集:既存の録音に対して、テキスト置換、感情調整、音高・速度変更、ポーズの挿入・削除を行えます。複数の操作を1つの指示にまとめて一度に実行でき、編集していない部分はそのまま保持されます。
多言語対応:24言語をカバーし、MiniMax多言語評価で話者類似度の平均83.9を達成。そのうち19言語で個別1位を獲得しています。
複数の推論速度:Base、SOAR、MeanFlow(4ステップ)、2ステップsCM、1ステップDMDなど複数のチェックポイントを提供し、音質と推論速度を用途に応じて選択できます。
03dots.ttsの技術原理
WeChatでフォローし、「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
完全連続自己回帰アーキテクチャ:dots.ttsは、音声を離散Tokenに量子化する従来方式を採用せず、生成プロセス全体を連続潜在空間で実行します。モデルは自己回帰方式で音響パッチを順次予測し、BigVGAN風のデコーダーで48kHz波形に復元します。これにより、離散量子化による情報ボトルネックや音色の細部の損失を根本的に回避します。
意味的な連続表現:HoliTokをベースに設計されたAudioVAEを使用し、元の波形を25 FPSの連続潜在変数へ圧縮します。エンコーダーは意味情報を重視した学習により、再構成忠実度と潜在空間の構造化のバランスを実現し、再構成後の話者類似度は0.969に達します。これにより、後続の自己回帰生成に豊かな音色・音響細部を保持する余地を残します。
誤差制御メカニズム:連続自己回帰において、前のステップの小さな誤差が後続へ累積・拡散する固有の問題に対処するため、dots.ttsは因果的意味エンコーダーを導入しています。生成済みのVAEパッチをリアルタイムで簡潔な意味履歴へ圧縮し、大規模言語モデルへ再入力します。高分散の局所的な音響変化を分離して長距離の意味要約だけを保持することで、長系列生成における誤差伝播、発振、音色ドリフトを効果的に抑制します。
生成プロセス:生成の中核は大規模言語モデルで、Qwen2.5-1.5Bを初期化に用い、BPEテキストTokenを直接受け取り、各ステップの隠れ状態を出力します。その後、自己回帰フローマッチングヘッド(18層DiT)が、LLMの隠れ状態と自己回帰プレフィックスを条件として、次の音響パッチに対するデノイズ生成を実行します。同時に、凍結されたCAM++話者エンコーダーが提供するグローバルx-vectorにより、音色の一貫性を確保します。
ポストトレーニングによる高速化:チームはSOARの自己修正アライメントによって、学習時に実際の推論で生じる逸脱状態をシミュレートし、モデルに自己修正を学習させています。報酬モデルなしで安定性を向上させられます。MeanFlow蒸留では、教師モデルの複数ステップの軌跡を平均速度へ圧縮し、4ステップで高品質な生成を実現します。さらに簡略化一貫性モデル(sCM)によって2ステップまで圧縮し、報酬認識分布マッチング蒸留(DMD)と二重時間スケール更新戦略により、自然で明瞭な高品質1ステップモデルを得ています。
04dots.ttsの使い方
インストール:pip install dots.ttsを実行してインストールできます。またはGitHubからソースコードをクローンし、pip install -e .でローカル開発用にインストールします。高同時実行数の環境では、SGLang Omniを追加でデプロイすることで、CUDA Graphによる高速化と連続バッチ処理に対応できます。
コマンドライン合成:dots.ttsエントリーポイントで--model-name-or-path、--text、対象となる--prompt-audioと--prompt-textを指定すると、ゼロショット音色クローンを実行できます。--prompt-textを省略するとx-vectorクローンに切り替わり、--prompt-audioを省略するとランダムな音色をサンプリングします。
コマンドライン編集:dots.tts.editエントリーポイントを使用し、--source-audioとXML形式の--instructionを指定すると、既存の録音に対してテキスト置換、感情・韻律の変更などの高精度編集を実行できます。
Python APIの基本呼び出し:DotsTtsRuntime.from_pretrained()でモデルを読み込んだ後、generate()を呼び出します。テキストと任意の参照音声を渡すと、合成音声テンソルを取得してファイルに保存できます。
Python APIのストリーミング出力:generate_stream()を呼び出すと、音声テンソルをパッチ単位で取得できます。プレーヤーやWebSocketへリアルタイムに送信することで、生成しながら再生する低遅延体験を実現します。
Python APIの二重ストリーム対話:DotsTtsRuntimeDoubleStreamingでセッションを開始した後、テキストをToken単位で送信すると、音声側が即座に生成を開始します。音声の初回パケット遅延は最短54.4ミリ秒で、リアルタイム音声Agentに適しています。
ファインチューニング:accelerate launch scripts/train_dots_tts.pyを実行し、自前のデータパスを設定することで、公開チェックポイントをベースに音色またはドメイン適応のファインチューニングを行えます。
蒸留による高速化:scripts/train_dots_tts_meanflow.pyでSOARチェックポイントを教師モデルとしてMeanFlow蒸留を行うと、4ステップ、2ステップ、または1ステップの高品質な学生モデルを取得でき、異なる遅延・同時実行数の要件に対応できます。
Webインターフェース:python apps/gradio/app.pyを実行すると、ビジュアルな合成インターフェースを起動できます。また、apps/edit_playground/app.pyを実行するとEdit Playgroundを起動でき、ブラウザ上で音声をアップロードし、編集区間を指定して結果をリアルタイムにプレビューできます。
05dots.ttsの主な強み
完全連続潜在空間モデリング:離散音響Tokenを廃止し、連続潜在空間で直接自己回帰生成することで、スペクトルの質感や息遣いなど豊かな音色の細部を保持します。再構成後の話者類似度は0.969に達します。
SOTAの合成品質:Seed-TTS-Evalベンチマークで内容正確度と音色類似度の両方でSOTAを達成し、24言語のMiniMax評価では平均SIMが83.9に達します。総合性能で主流方式を上回ります。
ネイティブなストリーミングと低遅延:1T1Aの二重ストリームモードでは音声の初回パケット遅延が最短54.4ミリ秒です。SGLang OmniとH100 1枚の構成では16並列でスループット4.76 req/sを実現し、リアルタイム音声Agentの要件を満たします。
統合された編集機能:dots.tts.editは同一の基盤モデルをベースに、XML構造化指示によるテキスト、感情、韻律、ポーズの高精度編集に対応します。doteBench評価では、他のオープンソースシステムを総合的に上回っています。
06dots.ttsのプロジェクトURL
GitHubリポジトリ:https://github.com/studio-dots-ai/dots.tts
arXiv技術論文:https://arxiv.org/pdf/2608.02673
07dots.ttsの利用シーン
リアルタイム音声Agent:1T1Aの二重ストリームモードで初回パケット遅延が最短54.4ミリ秒。LLM駆動のリアルタイム双方向対話や音声アシスタントに適しています。
ゼロショット音色クローン:数秒の参照音声だけで任意の音色を再現でき、多言語クローンにも対応します。オーディオブック、吹き替え、パーソナライズされたコンテンツ制作に適しています。
多言語コンテンツ生成:24言語をカバーしながら高い話者類似度を維持します。グローバル製品の多言語音声配信やローカライズサービスに適しています。
高精度な音声編集:dots.tts.editを使用して既存の録音のテキスト置換、感情調整、韻律変更、ポーズ調整を行えます。ポッドキャストのポストプロダクションや音声コンテンツの精密編集に適しています。
ライブ配信とリアルタイム読み上げ:LLMのストリーミング出力と組み合わせて生成しながら再生でき、ニュース読み上げ、ライブコマース、リアルタイム情報配信に適しています。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0