
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-28
01Kevとは
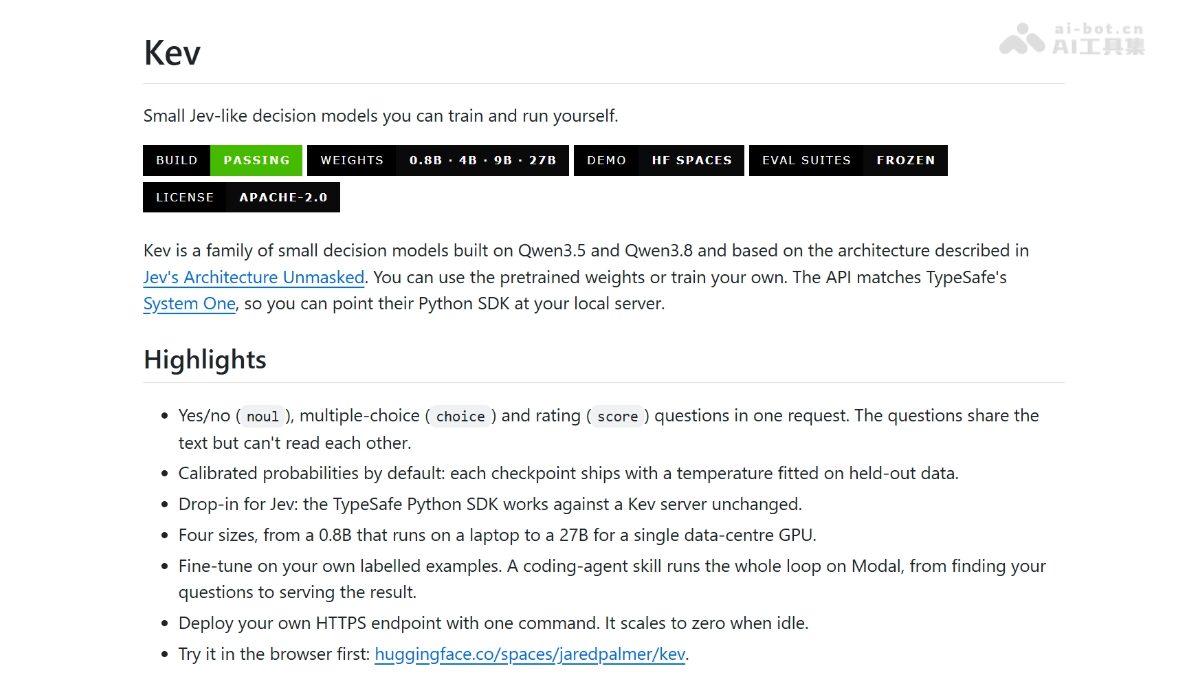
Kevは、CognitionのエンジニアリングVPであるJared Palmerがオープンソースとして公開した意思決定モデルファミリーです。Qwen3.5/Qwen3.8を基盤とし、0.8Bから27Bまで複数のモデルサイズを提供します。Kevはテキストを生成せず、状態テキストと構造化された質問を入力すると、1回のフォワードパスで校正済み確率を直接出力します。はい/いいえ、選択肢ルーティング、段階評価の3種類の意思決定に対応し、TypeSafe System OneとAPI互換です。
02Kevの主な機能
構造化された意思決定:状態テキストと複数の構造化された質問を入力すると、1回のリクエストで各選択肢の校正済み確率を直接出力し、説明文は一切生成しません。
3種類の意思決定プリミティブ:noul、choice、scoreに対応します。
一括質問の分離:複数の質問が同じ入力状態を共有し、アテンションマスクで互いに分離されます。1回のフォワードパスで全質問に同時回答し、相互に干渉しません。
ローカルデプロイ:kev.serveを1行のコマンドで起動でき、POST /v1/systemoneエンドポイントを公開します。CUDA、ROCm、Apple Silicon(MLX)に対応します。
低コストな微調整:独自のアノテーションデータを使い、公式チェックポイントから継続学習できます。kev-finetune skillにより、coding agentがデータ整理、学習、評価、デプロイの全工程を自動で実行します。
評価体系を内蔵:固定評価セットを内蔵し、正解率、Brierスコア、校正誤差、自動化可能な意思決定の割合をレポートします。CIがリリース時の数値も自動検証します。
03Kevの技術原理
WeChatで「オープンソース」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます
ポインターヘッドで生成を判別に変換:KevはQwenの基盤モデルの重みを凍結し、rank-16のLoRAアダプターとポインターヘッドを追加します。各候補の隠れ状態と質問の隠れ状態をスコアリングし、softmaxで確率を得ます。本質的には、大規模モデルの「作文問題」を「選択問題」に変え、トークン単位の逐次生成を省略します。
ブロック因果アテンションによる質問分離:入力シーケンスを「状態 + 複数の質問ブロック」として構成し、アテンションマスクによって各トークンが状態と自身の質問内部だけを参照できるようにします。位置IDは各質問で再カウントするため、1回のフォワードパスで互いに無関係な複数の質問に同時回答できます。状態の計算を共有しながら、質問間で情報が漏れることはありません。Qwen3.5/3.8のような混合Gated DeltaNetモデルでは、各質問を独立した行として配置し、状態のKVキャッシュを再利用する方式に変更されるため、分離がさらに厳密になります。
学習と校正:正しいラベルに対して交差エントロピーでアダプターとポインターヘッドを学習し、基盤モデルは全工程で凍結します。各チェックポイントについて、ホールドアウトデータで温度パラメータをフィッティングし、推論時に校正後の確率を直接出力します。温度は順位を変えず、信頼度の数値だけを校正します。
04Kevの使い方
環境準備:Python 3.12/3.13とuvをインストールし、リポジトリをクローンした後、uv sync --extra serveを実行して依存関係をインストールします。
ローカルでサービスを起動:KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009を実行してモデルを起動します。初回実行時に重みが自動ダウンロードされます。
意思決定リクエストを送信:POST /v1/systemoneにstateテキストとquestionsを送信すると、各選択肢の校正済み確率が返されます。
Python SDKで呼び出し:TypeSafe公式SDKのbase_urlをローカルサービスに向ければ、既存のJevアプリを変更せずに切り替えられます。
ブラウザーで試す:Hugging Face Spaceにアクセスするか、ローカルでplaygroundを実行すれば、インストールなしで体験できます。
独自データを微調整:アノテーションデータをJSONL形式で整理し、uv run python -m kev.train --init_from jaredpalmer/kev-4b ...を使って公式チェックポイントから継続学習します。
Agentによる全自動微調整:npx skills add jaredpalmer/kev@kev-finetuneを実行した後、coding agentに問題の発見、データ作成、学習、評価、デプロイの全工程を任せられます。ローカルGPUは不要です。
クラウドデプロイ:pip install modal && modal deploy kev_serve.pyを実行すると、HTTPSエンドポイントをワンクリックでデプロイできます。アイドル時は自動的にゼロまでスケールダウンし、料金は発生しません。
評価と検証:uv run python -m kev.benchmark --run <モデル> --suite evals/v4/transfer-v4を使い、固定評価セットで効果を検証します。公開前に評価を行います。
05Kevの主な強み
非常に低コスト:1回のフォワードパスで確率を直接出力し、トークン単位の逐次生成を省略します。H100では6問への回答がわずか18msで完了し、自社運用後のAPI呼び出し費用は不要です。
安価で再現可能な学習:公式の3モデルの移植学習にかかった費用は約95ドル、個人での微調整は1回約1ドルです。完全な請求内容が公開されています。
オープンソースで制御可能:Apache-2.0ライセンスのもと、重み、学習コード、固定評価セットをすべて公開しています。独自学習、監査が可能で、ベンダーロックインもありません。
APIをそのまま利用可能:TypeSafe System Oneと完全互換で、既存のJevアプリはbase_urlを変更するだけで切り替えられます。
複数の質問を一度に処理:入力状態を共有し、ブロック因果アテンションで分離することで、任意の数の質問に1回のフォワードパスで同時回答できます。相互に干渉しません。
06KevのプロジェクトURL
GitHubリポジトリ:https://github.com/jaredpalmer/kev
07Kevの利用シーン
カスタマーサポートチケットのルーティング:1回のフォワードパスで「どの部署に転送するか」「有人対応にエスカレーションするか」「顧客の怒りのレベル」を同時に判定します。確率のしきい値に基づいて自動振り分けし、確信度が低い場合は有人対応に回します。
コンテンツ安全性審査:UGCテキストに対して「noul 違反かどうか + choice 違反の種類 + score 深刻度」を並列実行し、確信度が高ければ自動処理します。
金融・信用審査:苦情の種類、有人介入の必要性、リスクレベルを判定し、確率分布をコンプライアンス記録や有人再審査の優先順位付けに活用します。
EC商品・インテント分類:ユーザーの検索語を検索、レコメンド、アフターサービスなどの下流システムにルーティングし、「1つの語が複数カテゴリに該当する」マルチラベル分布の問題に対応します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0