
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-10
01AuKとは
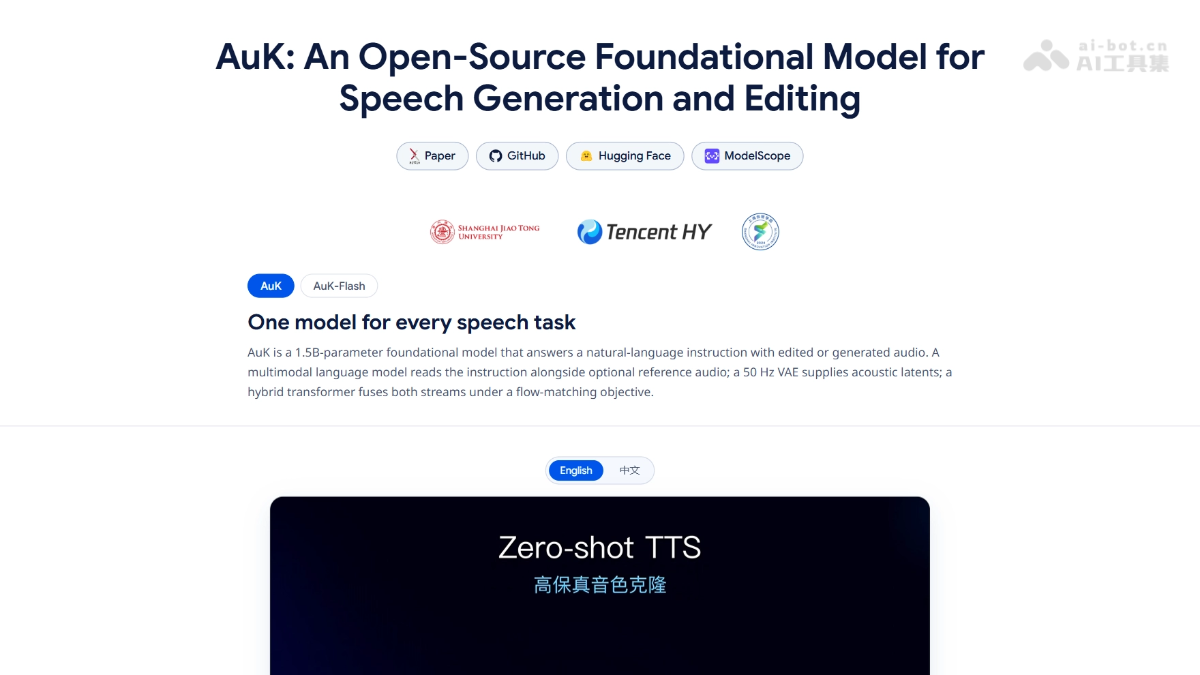
AuKは、Tencent Hunyuanがオープンソースとして公開した15億パラメータの音声生成・編集基盤モデルで、自己回帰方式ではなくフローマッチング拡散アーキテクチャを採用しています。モデルは統一された自然言語指示インターフェースを通じて、ゼロショット/指示型TTS、音声コンテンツ編集、音響調整、パラ言語編集、ノイズ除去や音声分離など16種類の音声タスクを実行できます。4ステップ推論の高速版AuK-Flashも提供されており、速度は約4.5倍向上します。
02AuKの主な機能
Zero-shot TTS:数秒の参照音声から声色をクローンし、新しい音声を合成します。
Instruct TTS:参照音声なしで、声の特徴をテキストで説明するだけで対応する音声を生成します。
音声コンテンツ編集:声色やイントネーションを変えずに、録音内のテキストを置換、挿入、削除します。
歌詞編集:メロディーと歌声の特徴を保ったまま、歌詞だけを書き換えます。
音高/速度/音量編集:半音、倍速、デシベル単位で音響属性を正確に調整します。
感情・声色編集:言葉を変えずに感情表現を変更したり、内容を保ったまま声色を変換したりできます。
アクセント編集とノイズ除去:アクセントを取り除き、ノイズや残響を低減して明瞭度を高めます。
パラ言語イベント編集:呼吸音、笑い声、咳などを追加・削除し、通常の発話とささやき声を相互変換します。
音声分離:話者の発話順に複数人の音声を分離したり、内容の説明に基づいて対象話者を抽出したりできます。
音楽分離:楽曲からボーカルを抽出し、伴奏を除去します。
03AuKの技術原理
WeChatで「开源」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます。
全体のパラダイム:AuKはフローマッチング拡散アーキテクチャを採用して音声の潜在空間表現を生成します。「編集」タスクに自然に適しており、元の音声の潜在表現をノイズ除去の開始点として、指示された部分だけを変更します。これにより、元の声色、メロディー、編集されていない内容をより適切に保持できます。これが、編集タスク群を網羅できる技術的基盤です。
3コンポーネントのパイプラインアーキテクチャ:システムは3つの部分で構成されます。マルチモーダル大規模モデルが自然言語の指示と参照音声を読み取り、意味条件を生成します。音声VAEが24kHzの波形を50Hzの音響潜在空間にエンコードします。中核のハイブリッドTransformerは、10層の双流MMDiTと20層の単流DiTを積み重ねた構成で、モデル幅は1536、総パラメータ数は15億です。
大規模な指示アライメント学習:学習データは約30.3億件の「指示—音声」ペアで、累計約195万時間の有効な教師データに相当します。重要なのは、すべてのタスクを同じ「指示+入力音声→出力音声」形式に統一している点です。これにより、モデルは単一のインターフェースで16種類のタスクに汎化できます。
学習後処理と人間の嗜好最適化:モデルは基礎学習後に、人間の嗜好最適化と強化学習による学習後処理(RL post-training)を経て、生成音声の自然さ、指示遵守度、聴覚品質を高めています。
04AuKの使い方
ハードウェア環境を確認:RTX 3090/4090など、VRAM約24GBクラスのNVIDIA GPUを用意します。
コードリポジトリをクローン:GitHubからTencent-Hunyuan/AuKリポジトリをローカルにクローンします。
依存環境をインストール:リポジトリの要件に従ってPython環境を構成し、必要な依存パッケージをインストールします。
モデル重みをダウンロード:Hugging FaceまたはModelScopeからAuKの重みと対応するVAEファイルをダウンロードします。
意味条件モデルをダウンロード:指示と参照音声の解析に使用するマルチモーダル大規模モデルQwen2.5-Omni-3Bを個別にダウンロードして設定します。
入力素材を準備:対象テキスト、参照音声、または編集対象の元音声ファイルを用意します。
自然言語の指示を作成:タスク要件に応じて、声の特徴、置換する文、調整する音高・速度などを指示文に記述します。
推論を実行:コマンドライン(CLI)から指示と素材を入力し、生成または編集を実行して出力を待ちます。
試聴と調整:結果の音声を確認し、満足できない場合は指示文の表現、サンプリングステップ数、CFG強度を調整して再生成します。
05AuKの主な強み
統一インターフェースでタスクを網羅:自然言語の指示により、TTS、編集、強調、分離など16種類の音声タスクに対応でき、タスクごとに個別のモデルをデプロイする必要がありません。
業界でも希少な編集能力:語句の変更、文の挿入、音高の調整、感情の変更などの精密な編集に対応し、元の声色とイントネーションを最大限に保持できます。
Instruct TTSは参照音声不要:声の特徴をテキストで説明するだけで音声を生成でき、利用のハードルを下げます。
フローマッチングアーキテクチャで高い忠実度:トークン逐次予測ではなく拡散型生成を採用し、編集時には元の音声を起点にノイズ除去を行うため、変更していない部分の劣化をほぼゼロに抑えられます。
06AuKのプロジェクトURL
プロジェクト公式サイト:https://auk-project.github.io/
GitHubリポジトリ:https://github.com/Tencent-Hunyuan/AuK
Hugging Faceモデルリポジトリ:https://huggingface.co/tencent/AuK
arXiv技術論文:https://arxiv.org/pdf/2609.08936
07AuKの活用シーン
映像作品・ショートドラマの台詞修復:俳優が言葉を間違えた場合や脚本を微調整する場合、録音内の一部の語句を直接置き換えられます。スタジオで再収録する必要がなく、元の演技の感情も保持できます。
ポッドキャスト・インタビュー制作:言い間違いや不要な発言を削除し、話速やリズムを調整し、背景ノイズや残響を除去して、ラフ編集素材を完成音源へ簡単に整えられます。
オーディオブック・AI音声制作:Instruct TTSで役柄に合わせた声の特徴を説明して差別化された声色を生成できます。同じナレーターでも、後から感情やイントネーションを調整でき、複数キャラクターの制作コストを削減します。
音楽制作・二次創作:元のメロディーと歌声の特徴を保ったままカバー曲の歌詞を書き換えたり、楽曲からボーカルを抽出してリミックス素材にしたりできます。
語学学習・アクセシビリティ:アクセントや言語障害のある利用者向けに、アクセントを取り除き、話速や音量を調整して、より明瞭で理解しやすい音声コンテンツを生成します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0