
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-09-16
01Irisとは
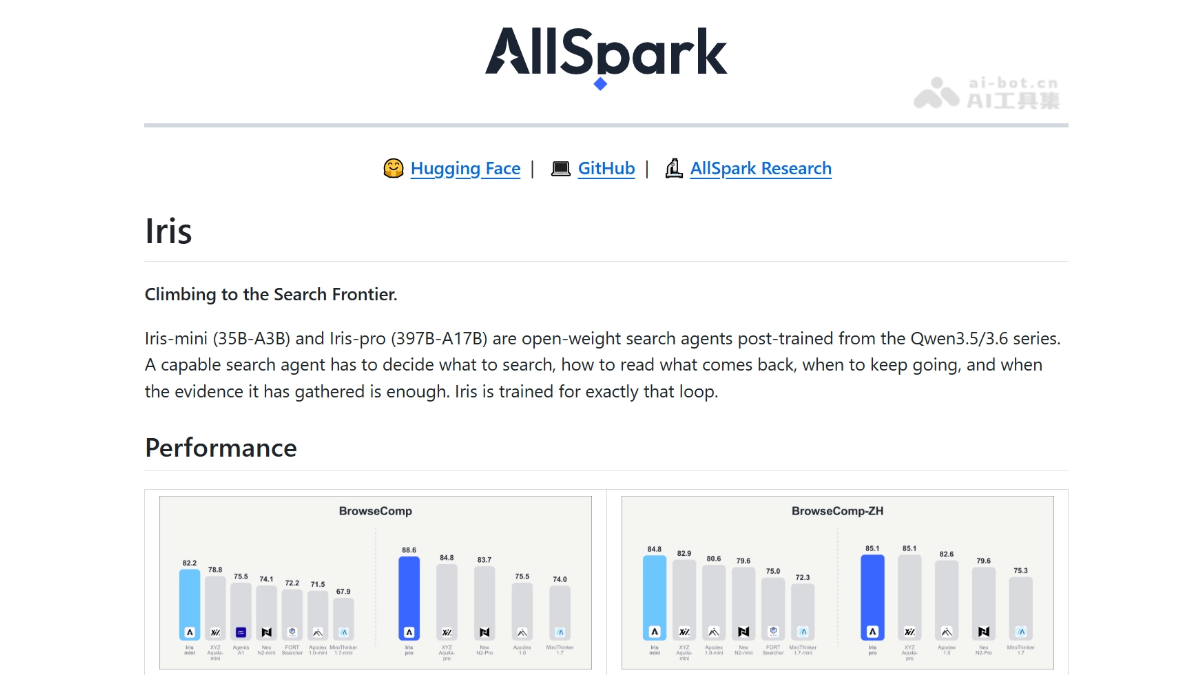
Irisは小紅書AllSparkチームがオープンソースで公開した検索エージェントで、35B(Iris-mini)と397B(Iris-pro)の2つのバージョンがあります。Irisは実際のウェブ上で何を検索し、どのように読み、いつ回答を収束させるかを自律的に判断します。ウェブページのハイパーリンクから、十分に難しく解答可能なトレーニングデータを逆算して構築し、SFTと強化学習を交互に行うSFT–RL Climbingトレーニング手法を採用しています。BrowseComp、DeepSearchQA、HLEなど4つの主要ベンチマークで同規模のオープンソースモデル中、最高水準の結果を達成しています。35B版は1兆パラメータ規模のモデルに迫り、検索能力を汎用ツール呼び出しなどのタスクへ汎化できます。
02Irisの主な機能
自律的なウェブ検索:何を検索し、検索結果をどう読み、いつ続行または停止するかを自ら判断し、検索・推論・回答を同時に行います。
多段階のページ横断推論:キーワードマッチングによる近道ではなく、複数のウェブページを段階的に調べ、唯一の答えを特定できます。
中国語・英語の複雑な検索:BrowseComp、BrowseComp-ZHなど中国語・英語のウェブ検索タスクで、同規模のオープンソースモデル中、最高水準を達成しています。
証拠網羅型の質疑応答:回答時に証拠の連鎖を完全にカバーし、DeepSearchQAで優れた性能を示します。
専門家レベルの難問解決:HLEのような専門家レベルの推論を必要とする難問にも対応できます。
コンテキスト管理:切り詰めや圧縮などのコンテキスト管理戦略に対応し、長い検索チェーンを中断せずに処理できます。特に小規模モデルで大きな効果を発揮します。
能力の汎化:特別なトレーニングなしで、汎用ツール呼び出しやオフィスコラボレーションなどのタスクにも対応できます。
03Irisの技術原理
WeChatでフォローして「开源」と返信すると、AIオープンソースプロジェクトの交流グループに参加できます。
逆算による問題生成:シードページを答えとして、ハイパーリンクをたどってエンティティグラフを構築します。そのグラフ上で、複数ページを横断した多段階推論が必須となる問題を生成し、さらに問題文中の答え以外のエンティティを説明的な指示語に書き換えて、照合可能な手がかりを取り除きます。最後に参照モデルで二重に選別し、閉じた状態では解答できず、証拠を与えれば一意に正解できる問題だけを残します。全工程を自動化しており、コーパスの規模に応じて拡張できます。
SFT–RL Climbing交互トレーニング:SFT段階では、強力な教師モデルが実際の検索ツール上で生成した軌跡を、結果フィルタリングと「判定役」によるステップ単位のフィルタリング後に学習します。RL段階では、モデルが実際のウェブ上で検索しながら学習します。各ラウンド終了後、正答が最も難しかった軌跡と最も効率的に解けた軌跡を次のSFTへ戻します。モデルが強くなるにつれて問題も自動的に難しくなり、適応型カリキュラムを形成します。
トレーニング工程の内製化:採点と要約を自社構築モデルでトレーニングクラスタ内部にて完結させ、外部APIに依存しません。ネットワーク変動によるトレーニングループへの干渉を避けると同時に、トレーニングとオンライン利用で同じ要約器を使用し、学習と推論のずれを解消します。
超長時間軌跡の中断・再開:一部の処理を遅延させる長時間セッションを丸ごと破棄せず、リクエスト単位で中断し、次のステップを送信済みのプレフィックスから継続します。同期スケジューリング下でもGPUの高い利用率を維持できます。
整合性を重視した評価プロトコル:すべての比較システムを、同一のツール、コンテキスト、採点モデル、コンテキスト管理戦略の下で、単一のReActエージェントのみを用いて評価します。マルチエージェントやテスト時の自己検証などによる枠組み上の抜け道を排除し、スコアがモデル本来の能力を正確に反映するようにしています。
04Irisの使い方
コードリポジトリをクローン:git clone https://github.com/AllSpark-Research/Irisを実行して、推論・評価コードを取得します。
モデルの重みをダウンロード:HuggingFaceコレクション huggingface.co/collections/AllSpark-Research/iris からIris-mini(35B)またはIris-pro(397B)の重みをダウンロードします。
実行環境を設定:リポジトリの要件に従って依存関係(vLLM/SGLangなどの推論フレームワーク)をインストールし、検索ツールのインターフェースを設定します(インターネット検索はSearch Agentに必須です)。
モデルを読み込み、ツールに接続:ReActエージェント形式でモデルを読み込み、検索エンジンをモデルが呼び出せるツールとして登録します。
質問を入力して推論を実行:質問を入力すると、モデルが検索クエリの計画、ウェブページの読解、多段階推論を自動的に行い、証拠付きの回答へ収束させます。
05Irisの主な強み
同規模で最高水準のオープンソース性能:BrowseComp、BrowseComp-ZH、DeepSearchQA、HLEの4つの検索ベンチマークで、同規模のオープンソースモデルを全面的に上回っています。397BのIris-proは、一部の項目で1兆パラメータ規模のモデルを上回ります。
小規模で超大規模モデルに迫る性能:35BのIris-miniはBrowseCompで82.2点を獲得し、数十倍のパラメータを持つKimi-K2.6などのモデルに迫っています。小規模モデルでも特定領域で超大規模モデルに挑戦できる能力を示しています。
自動化された高品質なデータ構築:ウェブページのハイパーリンクから問題を逆算して生成し、照合可能な手がかりを除去したうえで、「十分に難しく、解答可能」な問題を二重に選別します。人手による問題作成は不要で、コーパスの規模に応じて無制限に拡張できます。
堅牢で効率的なトレーニング工程:採点と要約をトレーニングクラスタ内に内製化し、外部APIへの依存を完全に排除しています。超長時間軌跡の中断・再開によりGPUを継続的に高稼働させ、トレーニングの不確実性を大幅に低減します。
トレーニングとオンライン利用の一貫性:検索内容を圧縮する要約器は、トレーニング時、評価時、オンライン利用時で同一のものを使用しており、学習と利用のずれがありません。
能力の汎化と高い汎用性:検索能力を、特別なトレーニングを行っていない汎用ツール呼び出しやオフィスコラボレーションなどのタスクにも汎化できます。Searchは再利用可能な原子能力です。
06IrisのプロジェクトURL
GitHubリポジトリ:https://github.com/AllSpark-Research/Iris
HuggingFaceモデルコレクション:https://huggingface.co/collections/AllSpark-Research/iris
arXiv技術論文:https://arxiv.org/pdf/2609.04304
07Irisの活用シーン
ディープリサーチ/調査レポート:複数回の自動検索、ページ横断推論、証拠の完全な網羅に対応し、業界調査、競合分析、学術調査などのDeep Research系プロダクトに適しています。
複雑なファクトチェック:複数のウェブページを横断して多段階で答えを特定する必要があり、デマ検証、ファクトチェック、デューデリジェンスなど「必ず出典を見つける」必要がある場面に適しています。
中国語・英語のバイリンガル検索:BrowseCompとBrowseComp-ZHの双方で優れた性能を発揮し、中国語・英語が混在するコーパスの越境情報検索に適しています。
汎用ツール呼び出しエージェント:BFCL、τ-benchなどのGeneral Tool Useタスクにも能力を汎化でき、エージェント製品の汎用基盤として利用できます。
オフィスコラボレーション(Cowork):OfficeQA、APEXなどのオフィスタスクに特別なトレーニングなしで対応でき、オフィスアシスタントに組み込んで文書に関する質疑応答や業務フローを処理するのに適しています。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0