
- 月間訪問数
- 0
- 料金
- 無料、有料
- 掲載日
- 2026-08-07
- 更新済み
- 2026-08-07
01SALMONN-2とは
SALMONN-2は、清華大学、上海人工知能研究所、ケンブリッジ大学が共同でオープンソース化した汎用音声大規模言語モデルです。ByteDanceのSPEAR統一自己教師あり音声エンコーダーと多層特徴融合アダプターを基盤に構築され、テキスト基盤モデルとしてQwen3を採用しています。約1.8万時間の教師ありデータのみで、MMAU-Pro、MMAR、MMSUという3つの総合ベンチマークにおいて同規模のオープンソースモデル中最高の性能を達成し、汎用ALLMとして初めて、音イベント検出、音声ディープフェイク検出、音声品質評価、マルチモーダル文脈音声認識などの高度な機能を体系的に実現しました。
02SALMONN-2の主な機能
汎用音声理解:音声認識、音声説明、音楽理解、感情認識、話者認証などの分野横断タスクに対応します。
音イベント検出(SED):犬の鳴き声や足音など、環境音イベントの開始・終了時刻を特定して出力できます。
音声ディープフェイク検出:音声が本物かどうかを判定し、合成または編集された疑いのある部分の時間範囲を特定します。
音声品質評価(SQA):ノイズ、歪み、明瞭度などの低レベル音響特徴を捉え、品質スコアとその説明を提示します。
マルチモーダル文脈音声認識(MICL):文字表記と発音参照音声を組み合わせ、珍しい単語やまれな人名の認識精度を向上させます。
03SALMONN-2の技術原理
WeChatでフォローして「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
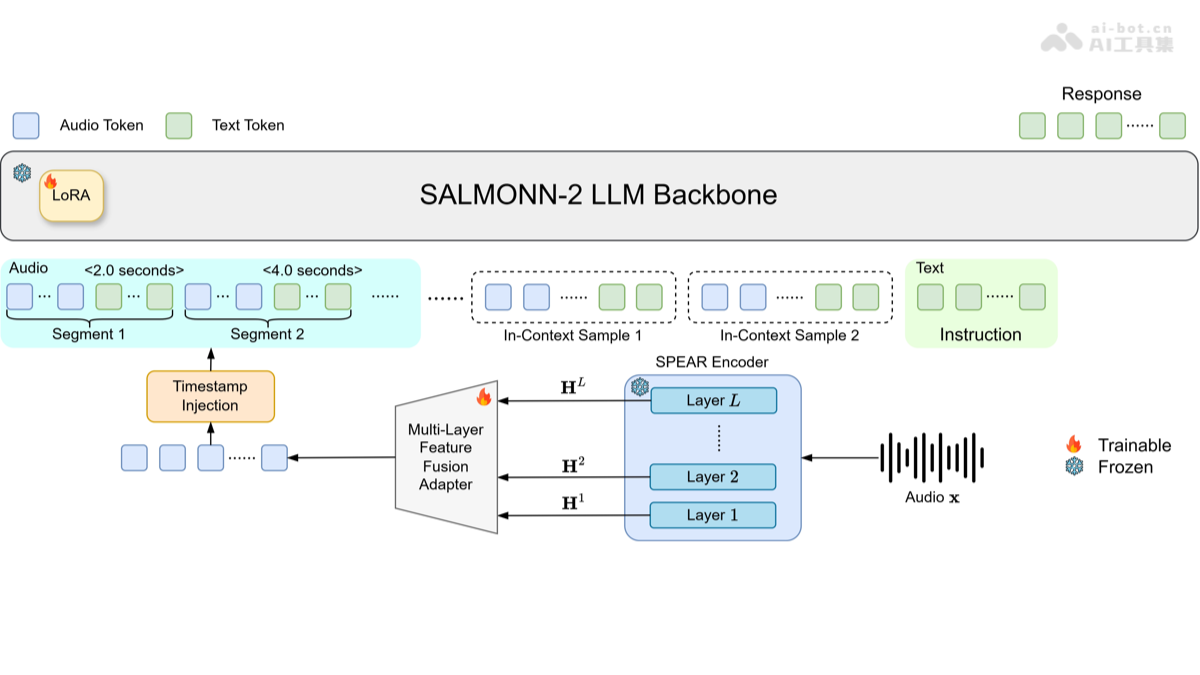
統一自己教師あり音声エンコーダー:SALMONN-2はSPEARを単一の音声フロントエンドとして採用しています。このエンコーダーは大規模なラベルなし音声データで自己教師あり学習を行い、意味、発音、音色、話者、音響環境の情報を同時に捉えます。従来のWhisper+BEATsデュアルエンコーダー方式に代わり、アーキテクチャを簡素化しながら、よりバランスの取れた分野横断能力を維持します。
多層特徴融合(MLF)アダプター:SPEARの各層が保持する情報の階層は異なります。浅い層は音響・発音の細部を保持し、中間層は音色・話者情報を含み、深い層は意味概念を蓄積します。MLFアダプターはまず各層の隠れ状態に層正規化と連結を施し、学習可能な下投影とフレームグループ圧縮を経て、融合された階層的表現を言語モデルの埋め込み空間へ写像します。これにより、モデルはタスクの要求に応じて異なる階層の音響手がかりを柔軟に利用できます。
タイムスタンプ注入機構:モデルはタイムスタンプを自然言語テキスト形式(例:<2.0 seconds>)で音声系列に直接挿入し、音声埋め込みと交互に言語モデルへ入力します。これにより、専用のタイムスタンプ埋め込み層を追加せず、統一された生成フレームワーク内で時間位置特定タスクを実行できます。
マルチモーダル文脈学習(MICL)トレーニング:文脈音声認識タスクでは、モデルはテキストによるバイアス語彙を受け取るだけでなく、これらの単語の発音参照音声もマルチモーダルな文脈として同時に取得します。学習時には、妨害語と目標語をランダムに除外する戦略を導入して過度なバイアスを防ぎ、音響的証拠に基づいて文脈情報を適切に利用する能力を学習させます。
04SALMONN-2の使い方
リポジトリにアクセスしてコードをクローン:GitHubリポジトリ https://github.com/bytedance/SALMONN/tree/salmonn2 にアクセスし、git cloneでコードをローカルにダウンロードします。
実行環境を作成:conda create -n salmonn2 python=3.10を実行して仮想環境を作成・有効化し、pip、setuptools、wheelをアップグレードします。
依存関係とプロジェクトをインストール:リポジトリのルートディレクトリでpip install -r requirements.txtおよびpip install -e . --no-depsを実行し、SALMONN-2と実行時依存関係をインストールします。
事前学習済み重みをダウンロード:HuggingFace CLIでモデルチェックポイントをダウンロードします:hf download marcoyang/SALMONN-2-8B --repo-type model --local-dir /path/to/salmonn-2-hf。
モデルを読み込んで推論:AutoProcessorとAutoModelForCausalLMでローカルの重みを読み込み、音声ファイルと指示テキストを渡してmodel.generate()を呼び出すと、音声理解の結果を取得できます。
05SALMONN-2の主な強み
データ効率:同規模の競合モデルで一般的に使われる数十万~数百万時間を大幅に下回る約1.8万時間の教師ありデータで学習でき、アノテーションコストを大きく削減します。
統一フロントエンドによるバランス:単一のSPEAR自己教師ありエンコーダーがデュアルエンコーダーに代わり、音声、環境音、音楽、副言語タスク間でよりバランスの取れた性能を実現します。
階層的情報の完全活用:MLFアダプターが全エンコーダー層の特徴を融合し、最終層だけを使用することで音響・音色などの重要な細部が失われるのを防ぎます。
音声分析能力の拡張:汎用ALLMとして初めて、SED、ディープフェイク検出、SQAなど、従来見過ごされていた音声分析タスクを体系的にサポートします。
スケール拡張性:テキスト基盤モデルを8Bから30B-A3Bへ拡張すると、3つの総合ベンチマークのスコアがいずれも継続的に向上し、アーキテクチャが優れたスケールアップの可能性を持つことが検証されています。
06SALMONN-2のプロジェクトリンク
GitHubリポジトリ:https://github.com/bytedance/SALMONN/tree/salmonn2
HuggingFaceモデルリポジトリ:https://huggingface.co/marcoyang/SALMONN-2-8B
arXiv技術論文:https://arxiv.org/pdf/2607.17079
07SALMONN-2の活用シーン
スマート会議アシスタント:会議内容をリアルタイムで文字起こしし、参加者の発音例と組み合わせて、外国人名や専門用語を正確に認識します。
音声コンテンツ審査:ライブ配信やポッドキャスト内の異常な音イベントを自動検出し、ディープフェイク音声を識別して詐欺を防止します。
音声品質モニタリング:カスタマーサービス通話や録音スタジオ素材を自動で品質評価し、ノイズや歪みのある区間を特定します。
マルチメディアアーカイブ検索:過去の音声や放送番組にタイムスタンプ付きのイベント説明を生成し、コンテンツに基づく高精度な検索を実現します。
聴覚障害者向け支援機器:ドアベルや警報などの環境音イベントを、テキストとタイムスタンプでリアルタイムに聴覚障害者へ通知します。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0