
- 月間訪問数
- 0
- 料金
- 無料、有料
- 掲載日
- 2026-08-13
- 更新済み
- 2026-08-13
01PixelRAGとは
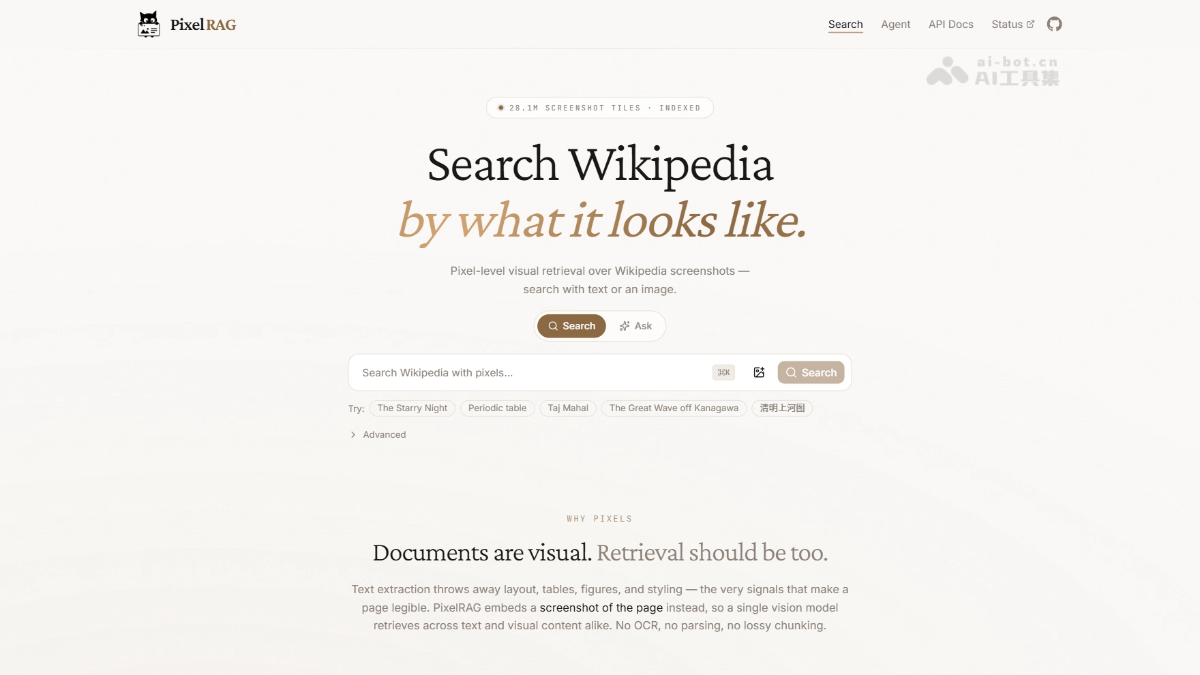
PixelRAGは、バークレー大学SkyLab/BAIRがオープンソースで公開するビジョンネイティブRAGフレームワークです。Webページを純粋なテキストに抽出してから検索する従来の方法を離れ、ブラウザでWebページやPDFをスクリーンショットのタイルにレンダリングします。LoRAで微調整したQwen3-VLによる視覚ベクトル検索で、モデルが画像上の表、グラフ、レイアウトを直接読み取れるようにし、従来のRAGで表やレイアウトが失われる問題を解決します。
02PixelRAGの主な機能
ページレンダリング(pixelshot):ヘッドレスChromiumでWebページやPDFをスクリーンショットのタイルにレンダリングし、表、グラフ、レイアウトを完全に保持します。Windows/macOSではシステムのChromeを自動的に呼び出し、URLとローカルファイルの混在にも対応します。
視覚セマンティック検索:スクリーンショットをベクトル化し、テキストから画像、画像から画像の検索に対応します。ローカルではデフォルトでFAISSを使用し、大規模環境ではQdrant(量子化圧縮、ディスク保存、複数サービスでの共有に対応)へ切り替えられます。
ピクセルを直接読み取り:検索でヒットしたスクリーンショットをそのまま画像入力としてVLMに渡し、質問に回答します。全工程でテキスト変換は行いません。
ホスト型検索サービス:キー不要のAPIとWebデモを提供し、828万ページのWikipedia事前構築済みインデックスを内蔵しています。すぐに検索を始められます。
独自インデックス構築パイプライン:pixelrag index / embed / build-index / serveの一連のコマンドで、自分のPDFやサイトのインデックスを構築できます。Mac(Apple Silicon)で小規模な実行が可能です。
Agent連携:MCPに依存しないClaude Codeプラグインpixelbrowseにより、Claudeが不完全なHTMLを読み込むのではなく、スクリーンショットでWebページを「見る」ことができます。
03PixelRAGの技術原理
WeChatでフォローし「开源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
表示層——ドキュメントを画像化:ヘッドレスChromiumでWebページをスクリーンショット化し、PDFをページ単位で画像に変換してタイルに分割します。これにより、表の行列の整列、グラフ、インフォグラフィックなどの視覚構造をそのまま保持します。
検索層——視覚ベクトル埋め込み:Qwen3-VL-Embedding-2Bをベースに、対照学習データでLoRA微調整を行います。これによりスクリーンショットをセマンティック検索でき、検索でヒットするのは「その一部分の画像」であり、「その一段落の文字」ではありません。ベクトルはローカルではFAISSに保存し、大規模環境ではQdrantに切り替えられます。
生成層——VLMが画像を読み取って回答:検索でヒットしたスクリーンショットのタイルをピクセル入力として直接ビジョン言語モデルに渡し、モデルが画像から数字やレイアウトを直接読み取ります。途中でテキスト変換を行いません。
規模と効率:スクリーンショット形式でWikipedia全体をカバーする初のRAGパイプラインです。ピクセル表現は新たな効率化の手段ももたらし、スクリーンショットの解像度を下げることで、精度を維持したままトークンコストを最大3倍削減できます。実験ではテキストRAGベースラインを全面的に上回り、最大18.1%向上しました。
04PixelRAGの使い方
インストール:pip install pixelragを実行するとコアツールを利用できます(Python 3.10+が必要です)。
ページのレンダリング:pixelshot https://example.com -o ./tilesを実行すると、WebページまたはPDFをスクリーンショットのタイルにレンダリングできます。
ホスト型検索を試す:設定は一切不要です。https://api.pixelrag.ai/search にPOSTリクエストを送るだけで、828万ページのWikipediaインデックスを検索できます。またはブラウザでpixelrag.aiを開いてオンラインで試用できます。
独自インデックスの構築:pixelrag.yaml設定ファイルを作成し(ドキュメントのパス、埋め込みモデル、出力先を指定)、pixelrag index buildを実行して構築します。その後、pixelrag serve --index-dir ./my_index --port 30001で検索サービスを起動します(Mac Apple Siliconで小規模な実行が可能です。Wikipedia全体のインデックスには約217GBとGPU計算能力が必要です)。
Claude Codeとの接続:uv tool install pixelragを実行した後、pixelbrowseプラグインをインストールします(claude plugin marketplace add StarTrail-org/PixelRAGおよびclaude plugin install pixelbrowse@pixelrag-plugins)。これにより、MCPなしでClaudeがスクリーンショットでWebページを「見る」ことができます。
高度なトレーニング:独自の埋め込みモデルを開発する場合は、train/ディレクトリ(独立したuvプロジェクト)に入り、READMEに従って微調整します。または、公式で公開されているLoRA重みとトレーニングデータをそのまま再利用できます。
05PixelRAGの主な強み
情報を損なわない:テキスト抽出の代わりにスクリーンショットを使用し、表の行列、グラフ、レイアウトを完全に保持します。従来のRAGで、答えがありそうに見えてもテキスト抽出後には情報が失われるという問題を根本的に解決します。
より高い性能:論文ではテキストRAGベースラインを全面的に上回り、NQ、SimpleQAなどの純粋なテキストタスクでも優れています。マルチモーダルおよびAgenticベンチマークでは最大18.1%向上しました。
より低コスト:ピクセル表現独自の効率化により、スクリーンショットの解像度を下げることで、精度を維持したままトークンコストを最大3倍削減できます。
よりシンプルなパイプライン:複雑なHTML解析、クリーニング、分割処理が不要で、スクリーンショットをレンダリングするだけでインデックスに登録できます。開発工数を大幅に削減できます。
大規模環境で実証済み:スクリーンショット形式でWikipedia全体をカバーする初のRAGパイプラインです。828万ページのキー不要ホスト型インデックスも付属し、すぐに試用できます。
06PixelRAGのプロジェクトURL
プロジェクト公式サイト:https://pixelrag.ai/
GitHubリポジトリ:https://github.com/StarTrail-org/PixelRAG
arXiv技術論文:https://arxiv.org/pdf/2606.28344
07PixelRAGの活用シーン
決算資料・データ表の質疑応答:決算資料のページや統計表から数字を直接読み取り、テキスト解析による行列のずれを防ぎます。
ダッシュボード・グラフ検索:グラフやKPIパネルを含むスクリーンショット領域を検索し、モデルが画像を読み取って回答します。
インフォグラフィック・図解付きドキュメント:インフォグラフィックやフローチャートなど、従来のテキストインデックスではカバーできなかったコンテンツも検索できます。
多段組みレイアウトの商品ページ:複雑なレイアウトの商品比較ページやニュースページも、元の配置を保ったまま検索対象にできます。
AgentによるWebページ閲覧:Claude Codeのpixelbrowseプラグインにより、Agentが不完全なHTMLを読み込むのではなく、スクリーンショットでWebページを「見る」ことができます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0