
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-11
01PixelUMMとは
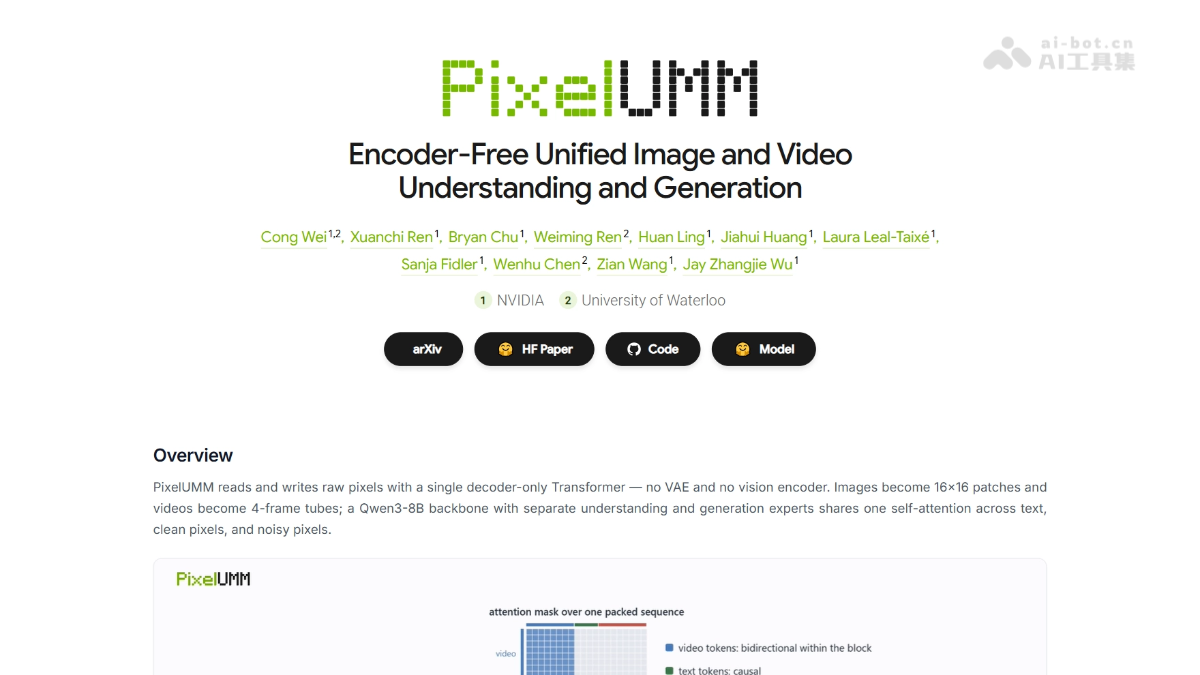
PixelUMMは、NVIDIAとウォータールー大学が共同開発したエンコーダー不要の統合マルチモーダルモデルです。最大の特徴はVAEとビジュアルエンコーダーを完全に排除し、単一のDecoder-only Transformerで画像や動画を生のピクセル空間上で直接読み書きすることです。理解と生成には同じデコーダーと自己注意機構を使用します。画像は16×16パッチ、動画は4フレームのチューブレットに分割されます。コードは公開されています。
02PixelUMMの主な機能
テキストから動画(T2V):最大832×464、96フレーム、24fpsの4秒動画を生成でき、画質は主要な動画拡散モデルに匹敵します。
テキストから画像(T2I):同一モデル内で画像を直接生成でき、個別の画像分岐やデコーダーは不要です。
画像理解:VQA、OCR、グラフ、文書など21種類の画像理解タスクに対応し、8BクラスのVLMと同等の平均性能を達成します。
動画理解:MVBench、Video-MMEなどの動画質問応答ベンチマークに対応し、denseとsparseの2種類の入力モードを提供します。
画像から動画(I2V):クリーンな初期フレーム画像を条件として理解エキスパートに注入することで、VAEによる条件フレームのエンコードなしに後続動画を生成できます。
動画編集:入力動画を視覚条件として使用し、マルチモーダルコンテキスト条件付け機構によって編集タスクを実行します。
03PixelUMMの技術原理
エンコーダー不要のアーキテクチャ:PixelUMMは従来の統合モデルにおけるVAEとビジュアルエンコーダーを完全に排除しています。画像は16×16パッチ、動画は4フレームのチューブレットに分割し、生のRGBピクセル形式で入力します。出力も線形ヘッドによって直接ピクセルへ回帰されるため、潜在空間でのエンコード・デコードによる損失がなく、真のエンドツーエンドのピクセル読み書きを実現します。
MoT共有注意構造:Qwen3-8Bを基盤としてMixture-of-Transformersを構築し、理解エキスパートと生成エキスパートがそれぞれ独立したFFNを持ちながら、同一のself-attentionを共有します。これにより、テキスト、クリーンなピクセル、ノイズピクセルが同じ注意空間内で相互作用し、1つのモデルで理解と生成を統合します。
ピクセル空間での拡散学習:生成タスクではピクセル空間上で直接flow-matching方式の学習を行います。アブレーション実験では、ピクセル空間とVAE空間の勾配ノルムはほぼ一致する一方、ピクセル空間での学習の方が安定していることが示されています。また、圧縮率の実験から、16×16パッチと4フレームのチューブレットが学習難度と効率の最適なバランスであることが確認されています。
マルチモーダル条件注入機構:テキスト条件、参照画像、入力動画などの「クリーンな条件」は理解エキスパートに入力し、生成対象のノイズトークンは生成エキスパートに入力します。両者は共有注意機構で融合されます。これにより、SenseNova-U1のエンコーダー不要の条件付け方式を画像から動画や動画編集へ拡張しています。アブレーションでは理解能力を損なわないことが示され、4つの動画ベンチマークで0.89〜3.49ポイント向上しました。
線形出力ヘッドと畳み込みヘッドの比較:デフォルトでは軽量な線形出力ヘッドを使用しますが、16ピクセルのグリッド状アーティファクトが生じます。Wan方式のアップサンプリング畳み込みヘッドとPixelShuffleヘッドを比較した結果、畳み込みヘッドでアーティファクトを除去できることが確認されました。その中でも時間優先のPixelShuffleが、学習損失とアーティファクト抑制の最適な折衷です。ヘッドを切り替える場合は再学習が必要です。
04PixelUMMの使い方
リポジトリをクローン:git clone https://github.com/nv-tlabs/PixelUMMを実行し、ENVIRONMENT.mdに従ってCUDA環境を設定します。
重みをダウンロード:Hugging Faceのnvidia/PixelUMMからデフォルトチェックポイントS8-F22-R05をダウンロードし、CHECKPOINT.mdに従ってQwen3-8Bの設定ファイルとtokenizerファイルをダウンロードします。
パスを設定:PIXELUMM_CKPT、PIXELUMM_QWEN_DIR、PIXELUMM_OUTPUTの3つの環境変数に、ローカルの絶対パスを指定します。
チェックポイントを検証:まずcheck_checkpoint.pyを実行して、重みの完全性とテンソルの互換性を確認します。
安全審査のアクセス権を申請:Hugging Faceでnvidia/Cosmos-1.0-Guardrailへのアクセス権を申請し、ログインします。
推論を実行:inference.pyで--task t2i / t2v / image-vlm / video-vlmをそれぞれ指定し、prompt、解像度、フレーム数などのパラメーターと組み合わせて、画像や動画を生成するか、理解結果を出力します。
一括生成(任意):inference_batch.pyとYAML形式のpromptファイルを使用して、タスクを一括実行します。
お試し学習(任意):TRAIN.mdに従ってtoyデータセットをダウンロードし、train_toy.pyでF22チェックポイントをベースに4タスクの学習例を実行します。
05PixelUMMの主な利点
完全なエンコーダー不要アーキテクチャ:VAEとビジュアルエンコーダーを排除し、生のピクセル空間上で直接読み書きすることで、潜在空間のエンコード・デコードに伴う情報損失とアーティファクトの原因を取り除きます。
理解と生成の統合:単一のdecoder-only Transformerで、テキストから画像、テキストから動画、画像理解、動画理解の4つの主要タスクを同時に実行します。理解エキスパートと生成エキスパートは同じ自己注意機構を共有します。
シンプルな構造と直接的な推論:出力は軽量な線形ヘッドによって直接ピクセルへ回帰されるため、追加のデコーダーが不要で、生成経路が短くなります。
柔軟で効率的な条件注入:参照画像や入力動画などのクリーンな条件を理解エキスパートに入力するだけで、画像から動画や動画編集を実現できます。アブレーションにより、この設計が理解能力を損なわないことが示されています。
明確で拡張可能な学習特性:8Bモデルは同等の損失に達するまでに、1.7Bモデルのおよそ3分の1の学習ステップしか必要とせず、スケール拡大による効果が明確です。
06PixelUMMのプロジェクトリンク
プロジェクト公式サイト:https://nv-tlabs.github.io/PixelUMM/
GitHubリポジトリ:https://github.com/nv-tlabs/PixelUMM
Hugging Faceモデルリポジトリ:https://huggingface.co/nvidia/PixelUMM
arXiv技術論文:https://arxiv.org/pdf/2609.38597
07PixelUMMの活用シーン
ショート動画コンテンツ制作:1行の説明を入力するだけで4秒・24fpsの動画を直接生成でき、ソーシャルメディア向けの素材を迅速に作成できます。
画像から動画と動画編集:初期フレームや元動画を条件として、コンテンツの生成や変更を行えます。EC商品の動的な展示や映像制作のプレビューに利用できます。
長尺動画の理解と質問応答:入力動画の説明、要約、時間的推論を行えます。コンテンツ審査、素材検索、会議議事録の作成に適しています。
文書とグラフの解析:OCRBench 78.0、DocVQA 90.4のスコアにより、領収書認識や帳票に関する質問応答など、企業文書のインテリジェント化を支援できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0