

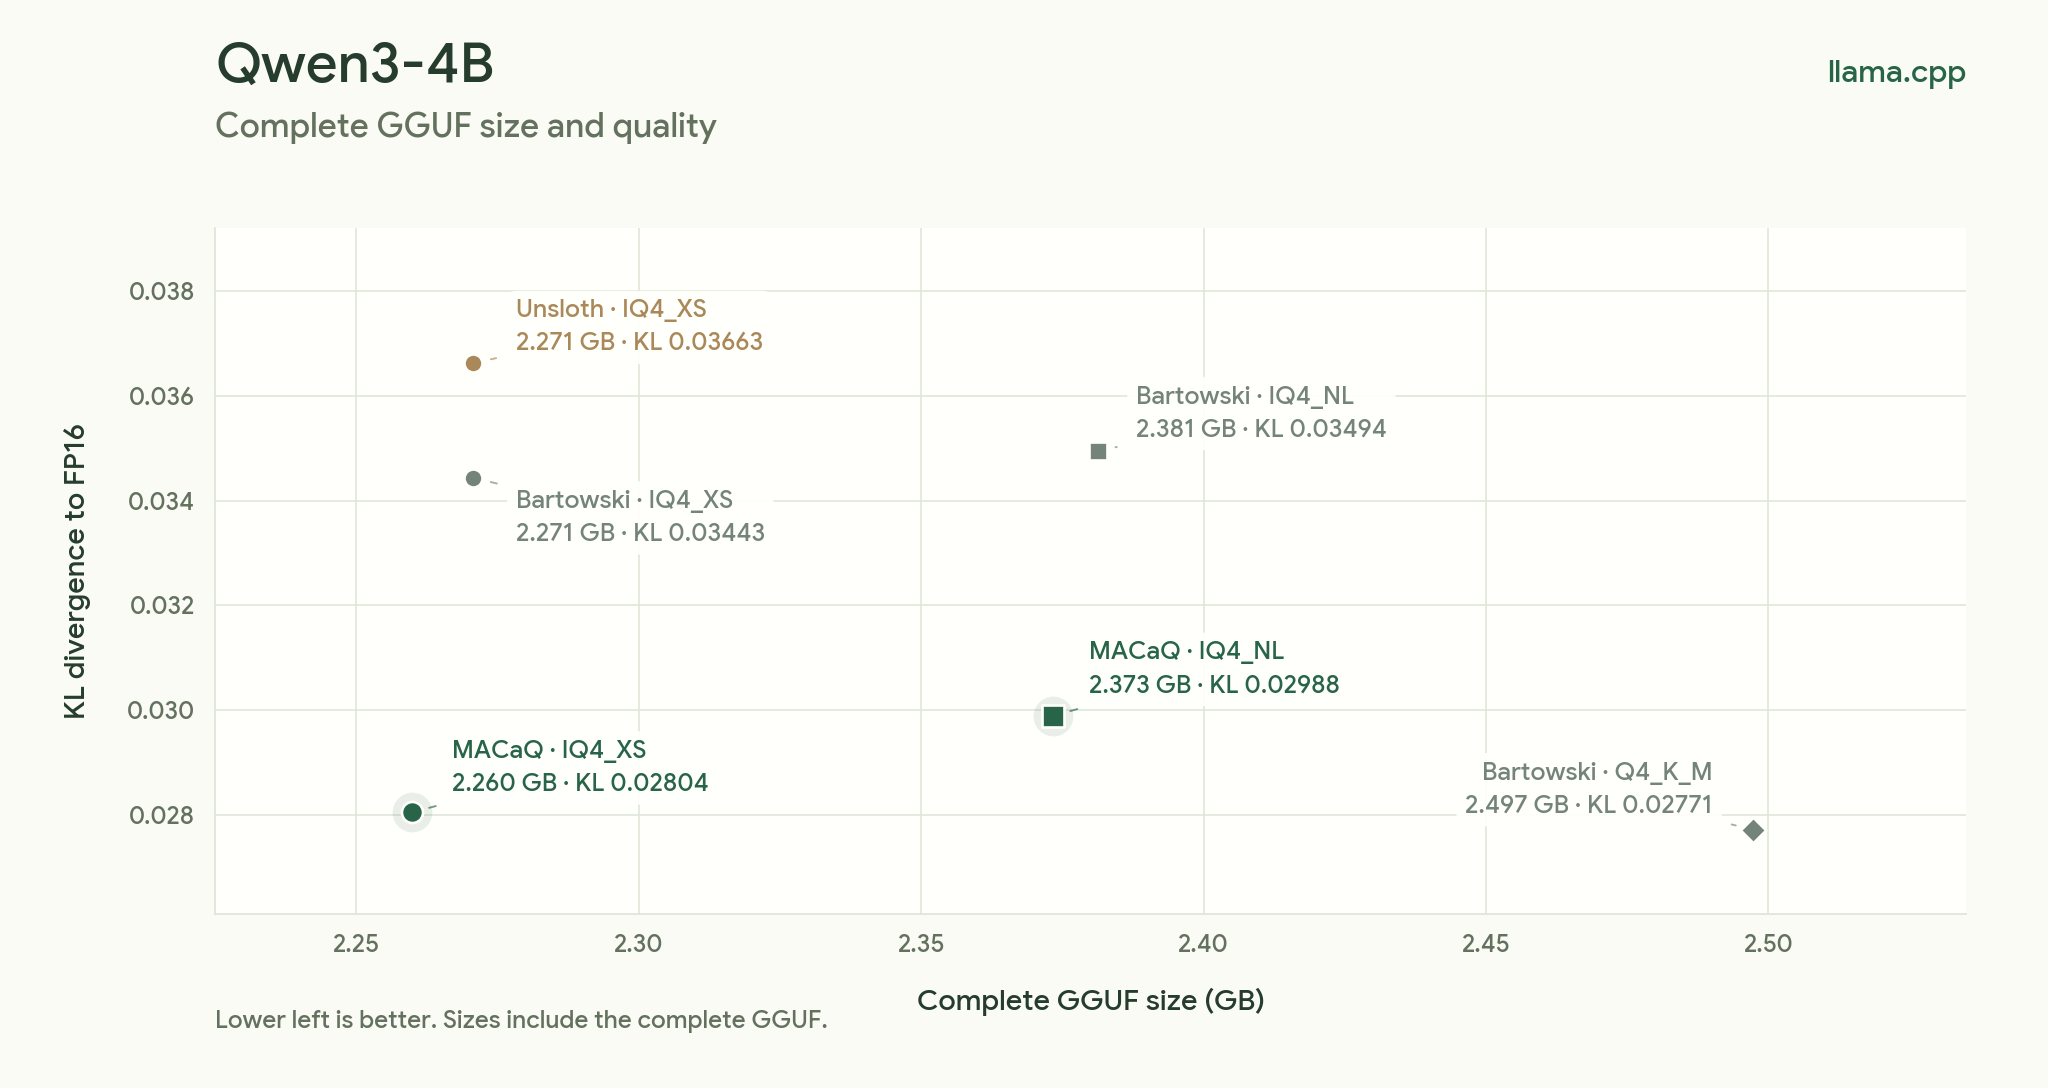
MACaQは、最新のAIモデルに必要なメモリ容量と計算量を削減するための、モデル非依存のキャリブレーション済み量子化プロジェクトです。llama.cpp、vLLM、Diffusers、PyTorchを通じて、テキスト、画像、動画、音声のワークフローに対応しています。
このプロジェクトは、実用的な推論互換性を維持しながら、キャリブレーション済みの低精度重みとアクティベーションに重点を置いています。READMEによると、MACaQは32.5 GBのデバイスメモリを使用して、1220億パラメータのモデルを64分で量子化できます。また、一部の比較ではMR-GPTQやDuQuant++より低いパープレキシティを示し、Llama-3-8Bでは量子化時間を大幅に短縮しながら同程度のパープレキシティを実現したと報告されています。
適切なMACaQバックエンドを選ぶ
まず、モデルとデプロイ先に合ったバックエンドを選択します。各バックエンドで個別の環境を使用し、Python 3.12を利用してください。
- Diffusers: 画像、動画、音声生成モデルをW4A4 safetensorsチェックポイントに量子化します。
- llama.cpp: テキストモデルを2、3、4ビットのGGUFファイルに量子化し、CPUを含むローカル環境で実行します。
- vLLM: W4A4または重みのみの形式で、生成またはHTTPサービング向けにテキストモデルを量子化します。
- PyTorch: 音声生成モデルをW4A4チェックポイントに量子化し、WAV音声を生成します。
リポジトリには、バックエンドごとのインストール、キャリブレーション、量子化、生成手順が収録されています。開始前に、選択したバックエンドのガイドを開いてください。
環境を準備する
Python 3.12を使用し、利用するバックエンド用に分離された環境を作成します。環境を分けることで、llama.cpp、vLLM、Diffusers、PyTorch間の依存関係の競合を避けやすくなります。
MACaQリポジトリをクローンし、そのディレクトリに移動します。
選択したバックエンド用にPython 3.12の仮想環境を作成します。
そのバックエンドのREADMEに従い、依存関係と必要なランタイムをインストールします。
バックエンドのガイドで指定されている元のモデル、キャリブレーションデータ、出力ディレクトリを準備します。
正確なインストールコマンドはバックエンドとモデルファミリーによって異なるため、すべてのワークフローに共通のインストールコマンドを適用せず、リンク先のREADMEを使用してください。
Diffusersで生成モデルを量子化する
Diffusersバックエンドは拡散トランスフォーマーを処理し、量子化済みsafetensorsチェックポイントを保存します。画像、動画、画像から動画への変換、音声生成に対応しています。
リポジトリには、black-forest-labs/FLUX.2-klein-4B、Wan-AI/Wan2.2-TI2V-5B-Diffusers、ylacombe/stable-audio-1.0などのモデル向けワークフローが用意されています。画像から動画への変換モデルでは、条件画像をキャリブレーションに使用できるため、量子化処理に意図した入力パターンを反映できます。
Diffusersガイドを開き、画像、動画、音声のワークフローを選択します。
専用のPython 3.12環境にバックエンドの要件をインストールします。
選択したレシピに必要なソースモデルをダウンロードまたは特定し、キャリブレーション入力を準備します。
記載された量子化コマンドを実行し、W4A4 safetensorsチェックポイントを保存します。
対応する生成コマンドを使用して、画像、動画、音声の結果を生成します。
llama.cppでテキストモデルを量子化する
llama.cppバックエンドは、テキスト生成向けのコンパクトなGGUFファイルを生成します。2ビット、3ビット、4ビットのGGUF形式に対応し、生成されたモデルからテキストを生成するランタイムも含まれています。
リポジトリには、Qwen/Qwen3-4Bなどの密モデル、Qwen/Qwen3.8-27Bなどのハイブリッドモデル、Qwen/Qwen3-30B-A3BやQwen/Qwen3-Coder-30B-A3B-Instructなどの混合専門家モデルについて記載されています。Qwen3.6-35B-A3BとQwen3.8-Flash-Next向けのレシピも含まれています。
標準的な量子化ワークフロー
llama.cppガイドを開き、モデルアーキテクチャに合ったレシピを選択します。
専用のPython 3.12環境にllama.cppバックエンドとその依存関係をインストールします。
選択したレシピで説明されている元のHugging Faceモデルとキャリブレーション用テキストを準備します。
記載されたMACaQ量子化ワークフローを実行し、GGUF出力を保存します。
付属のランタイムまたは互換性のあるllama.cppインストールを使用してテキストを生成します。
モデル固有の詳細については、バックエンドのREADMEにあるdense、hybrid、mixture-of-experts、またはFlash-Nextのセクションを参照してください。これらの手順は、モデルアーキテクチャ間の違いを考慮しています。
GGUFモデルを実行する
GGUFファイルを作成したら、llama.cppのコマンドラインクライアントで実行します。
llama cli -m models/model-macaq-r.ggufllama.cppを通じてモデルをサーブすることもできます。
llama serve -m models/model-macaq-r.ggufMACaQ-Rで既存のGGUFファイルを改良する
MACaQ-Rは、既存の量子化済みGGUFファイルの重みコードを、ネイティブ形式とブロックスケールを維持したまま改良します。生成されたファイルは、標準的なllama.cppのインストール環境と互換性があります。
これは、すでに量子化済みモデルがあり、GGUF形式を変更せずに品質を向上させたり、ワークロードに適応させたりしたい場合に便利です。READMEでは、Hugging FaceでQwen3.6-35B-A3B MACaQ-Rモデルを提供しており、同じ記載サイズの比較対象であるUnsloth UD-Q4_K_XLファイルより低いKLダイバージェンスを報告しています。
量子化済みMoE GGUFを改良するには、量子化済みモデル、対応する元のHugging Faceモデル、FP16教師ファイル、キャリブレーション用テキスト、出力先、作業ディレクトリを指定します。
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
改良が完了したら、標準的なllama.cppで出力を読み込みます。
llama cli -m models/model-macaq-r.gguf活性化変換を含むMACaQの完全なワークフローについては、同梱ランタイムガイドを参照してください。
vLLMでモデルを量子化してサーブする
vLLMバックエンドは、生成またはHTTPサーブ用のコンパクトなテキストモデルチェックポイントを作成します。W4A4がデフォルトの推論モードで、重みのみの量子化にも対応しています。
vLLMガイドを開き、ハイブリッドテキストモデルまたはテキストmixture-of-expertsモデル向けのワークフローを選択します。
専用のPython 3.12環境にvLLMバックエンドをインストールします。
選択した手順に必要なソースモデルとキャリブレーションデータを準備します。
記載されている量子化コマンドを実行して、コンパクトなチェックポイントを作成します。
チェックポイントを読み込んでローカル生成を行うか、記載されているHTTPサーバーを起動します。
READMEではQwen3.8-27Bの比較結果として、MACaQ W4A4のパープレキシティは2.8994で、BF16の2.8463と比較されています。一方、記載されたテスト環境では、プリフィルとデコードの測定値がより高速であると報告されています。
PyTorchで音声生成モデルを量子化する
PyTorchバックエンドは音声生成を対象とし、W4A4チェックポイントを保存します。チェックポイントを保存した後は、キャリブレーションを繰り返さずに読み込めます。
記載されているワークフローは、Qwen3-TTSとChatterbox Turboを対象としています。
PyTorchガイドを開き、音声モデルを選択します。
別のPython 3.12環境に必要なPyTorch依存関係をインストールします。
モデル固有の手順に従ってキャリブレーションと量子化を実行します。
W4A4チェックポイントを保存します。
保存したチェックポイントを読み込み、再キャリブレーションなしでWAV音声を生成します。
AscendハードウェアでMACaQを使用する
MACaQ W4A4のdenseおよびgrouped行列乗算カーネルは、CANN関連のプルリクエストを通じて利用できます。READMEでは、ops-nnのプルリクエスト12568にあるPTO-ISAカーネルと、ops-tilelangのプルリクエスト44にあるCCEバックエンド対応のTileLangカーネルを案内しています。
互換性のあるCANN、PyTorch、torch_npuのバージョンについては、各プロジェクトのビルド手順に従ってください。モデル全体の実行には、Ascend推論ランタイムとの統合が必要です。
より良いワークフローのための実践的なヒント
- デプロイ先に合わせてバックエンドを選ぶ。ポータブルなローカルテキスト推論にはGGUFとllama.cpp、テキストサーブにはvLLM、マルチモーダル生成にはDiffusers、音声モデルにはPyTorchを選択します。
- モデル固有の手順を使用する。Dense、hybrid、mixture-of-expertsモデルでは、準備や量子化の手順が異なる場合があります。
- キャリブレーションデータを用途に合わせる。たとえば、Diffusersのimage-to-videoワークフローでは、キャリブレーション中に条件画像を使用します。
- 環境を分離する。READMEでは、各バックエンドにPython 3.12の個別環境を使用することを明示的に推奨しています。
- ファイルサイズだけでなく品質も比較する。このプロジェクトでは、パープレキシティとKLダイバージェンスを使って、量子化モデルをFP16や他の量子化手法と比較評価しています。
- すでにGGUFがある場合はMACaQ-Rを使用する。標準的なllama.cppとの互換性を維持したまま、既存の量子化済みファイルを改良できます。
まとめ
MACaQは、GGUFテキストモデルからDiffusersの画像・動画・音声モデル、vLLMサービング用チェックポイント、PyTorch音声生成モデルまで、複数のAIワークロードに対応する量子化手法を提供します。まずバックエンド固有のREADMEを確認し、分離環境でPython 3.12を使用して、モデルのレシピに従ってキャリブレーションを行い、作成したチェックポイントを実際に使用するランタイムで検証してください。
研究または技術文書については、MACaQ論文をご覧ください。プロジェクトはApache License 2.0の下で公開されています。