
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-13
01QwenGyre란 무엇인가
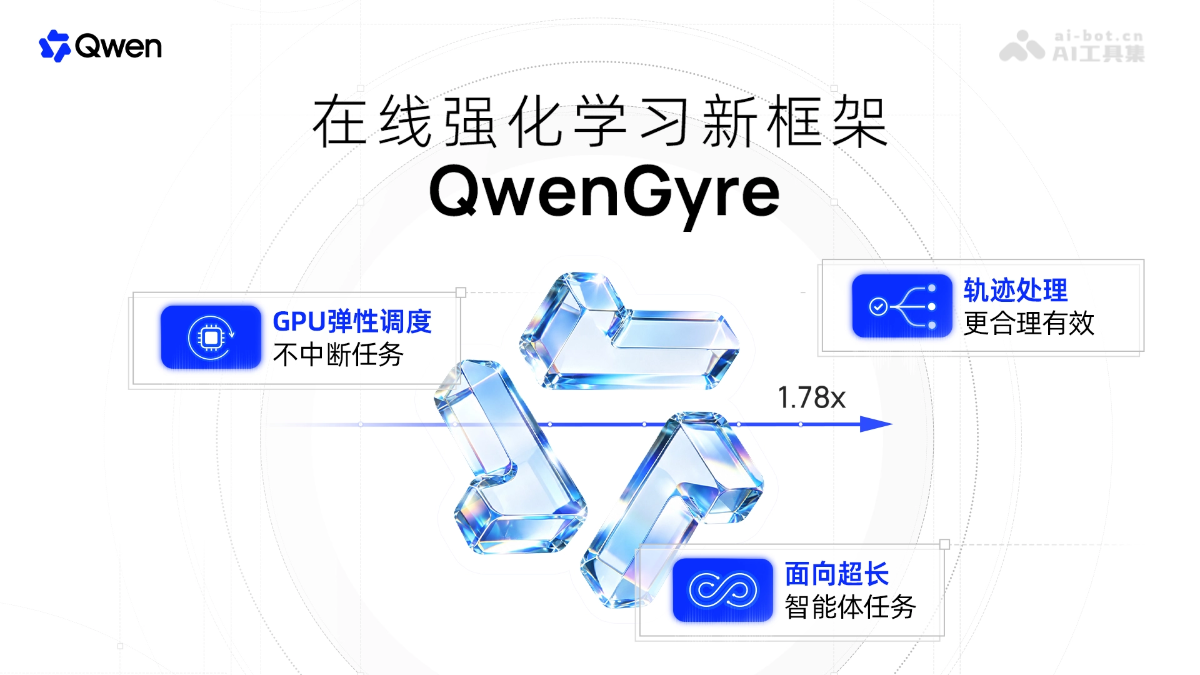
QwenGyre는 알리바바의 Qwen이 출시한 초장기 에이전트 온라인 강화학습 프레임워크로, 한 번에 약 70만 토큰을 사용하고 수 시간 동안 지속되는 작업을 대상으로 합니다. QwenGyre는 탄력적 스케줄링을 통해 작업을 중단하지 않고 유휴 GPU를 샘플링과 학습 사이에서 전환하며, 궤적 처리를 사용해 실제 컨텍스트를 보존하고 부분 결과를 평가하며 공유 접두사를 중복 제거해 비용을 제어합니다. Qwen3.8-2.4T에서 48단계 만에 NL2RepoBench 통과율을 52.48%에서 58.54%로 높였으며, Async 대비 엔드투엔드 속도를 1.78배 향상했습니다.
02QwenGyre의 주요 기능
초장기 에이전트 온라인 강화학습: 한 번의 실행이 수 시간 지속되고 누적 약 100만 토큰을 사용하는 작업에서 직접 RL 학습을 수행합니다.
탄력적 GPU 스케줄링: 작업을 중단하지 않고 유휴 GPU를 샘플링과 학습 사이에서 동적으로 전환합니다.
요청 재라우팅 및 KV 캐시 마이그레이션: GPU 역할을 전환할 때도 에이전트가 계속 실행되며 작업 공간과 도구 상태를 유지하고, RDMA로 KV 캐시를 마이그레이션해 중복 계산을 줄입니다.
스트리밍 학습 및 신규 노드의 중도 참여: 핵심 cell이 권위 있는 파라미터를 저장하고, 위성 cell은 언제든 스냅샷을 가져와 진행 중인 배치에 참여하며 진행 상황에 따라 마이크로 배치를 할당받습니다.
궤적 트리 및 실제 컨텍스트 보존: Token-in Token-out 방식으로 각 호출의 정확한 입출력을 기록하고 공유 접두사를 기준으로 궤적 트리를 구성해 모든 출력이 생성 당시의 컨텍스트에 대응하도록 합니다.
부분 채점(Partial Scoring): 시간 초과로 완료되지 않은 작업이라도 검증 가능한 결과를 산출하면 작업 규칙에 따라 채점하고 학습에 활용합니다.
궤적 예산 및 손실 균형: 각 실행에서 최대 Jmax개의 궤적만 유지하고 공유 접두사는 손실을 한 번만 계산해 분기가 많은 작업의 가중치가 지나치게 커지는 것을 방지합니다.
03QwenGyre의 기술 원리
탄력적 스케줄러(Elastic Scheduler): GPU를 여러 동종 계산 단위로 나누며, 각 cell은 SGLang을 사용해 샘플링 서비스를 제공하거나 Megatron을 사용해 완전한 학습 복제본을 호스팅할 수 있습니다. 스케줄러는 완료되지 않은 작업량인 ‘수위’를 추적합니다. 남은 샘플링 용량이 실행 중인 작업을 지원하기에 충분하고 학습 데이터 공급도 충분하면 cell을 순서대로 하나씩 학습에 투입합니다. 전환 시 에이전트가 모델 요청을 새로운 추론 엔진으로 리디렉션하고 완료되지 않은 요청을 재시도하므로 백엔드 프로세스와 통신 그룹을 재구성할 필요가 없습니다. 핵심 cell은 권위 있는 가중치와 옵티마이저 상태를 보유하고, 위성 cell은 RDMA를 통해 파라미터 스냅샷을 가져온 뒤 현재 배치의 그래디언트 누적에 참여합니다. 마지막으로 핵심 cell이 이를 통합해 업데이트하므로 데이터가 준비되는 대로 학습을 단계적으로 확장할 수 있으며 샘플링과 학습이 높은 수준으로 중첩됩니다.
궤적 처리(Trajectory Processor): QwenGyre는 에이전트를 통해 각 모델 호출의 정확한 입력/출력 토큰 ID와 행동 정책 로그 확률을 기록하고, 공유 접두사를 재사용하며 분기 지점에 가지를 만들어 궤적 트리로 구성합니다. 이를 통해 모든 출력이 생성 당시의 원래 컨텍스트에 대응하도록 보장합니다. 학습 승인 단계에서는 역할 우선순위에 따라 각 실행에 대해 Jmax개 이하의 궤적을 선택합니다. 정책 모델이 생성한 토큰만 손실에 참여하고 공유 대상은 한 번만 계산합니다. 손실은 먼저 실행 내에서 선택된 토큰의 평균을 구한 뒤 실행 간 평균을 계산하므로 실행 가중치가 분기 수와 분리됩니다. 여기에 Partial Scoring을 적용해 시간 초과 작업의 완료된 부분을 평가하고 채점함으로써, 초장기 실행에서 드물지만 비용이 큰 유효 신호를 최대한 활용합니다.
04QwenGyre 사용 방법
현재 QwenGyre는 논문 형식으로 공개되었으며, 알리바바는 아직 코드와 설치 패키지를 공개하지 않았습니다.
05QwenGyre의 핵심 장점
플래그십 모델에서 초장기 온라인 RL을 최초로 구현: Qwen3.8-2.4T에서 한 번에 약 70만 토큰을 사용하는 작업의 온라인 강화학습을 완료했으며, 48단계 만에 NL2RepoBench 통과율을 52.48%에서 58.54%로 높였습니다.
학습 효율 대폭 향상: 동일한 GPU 예산에서 엔드투엔드 속도를 Async 대비 최대 1.78배, Colocate 대비 1.85배 향상했으며, 48단계 학습 시간을 134.55시간에서 75.42시간으로 단축했습니다.
작업 중단 없는 탄력적 스케줄링: GPU가 샘플링과 학습 사이에서 동적으로 전환될 때 에이전트 실행, 작업 공간 및 도구 상태가 완전히 유지되며, 전환 시간은 수 초에 불과해 수 시간의 실행 시간에 비하면 무시할 수 있습니다.
GPU 활용률 극대화: 세밀한 cell 단위 리소스 할당으로 Colocate 방식의 긴 꼬리 대기와 유휴 상태, Async 방식의 고정 분할로 인한 경직성을 제거하며 학습을 샘플링 과정에 완전히 숨길 수 있습니다.
실제 컨텍스트를 보존하는 충실한 학습: TITO 메커니즘은 모든 출력이 생성 당시의 원래 컨텍스트에 대응하도록 보장해 기록 압축이나 하위 에이전트 컨텍스트 결합으로 인해 발생하는 ‘가상 컨텍스트’ 학습 신호를 방지합니다.
06QwenGyre 프로젝트 주소
arXiv 기술 논문:https://arxiv.org/pdf/2609.33848
07QwenGyre의 적용 시나리오
자연어로 완전한 코드 저장소 생성: 자연어 사양에 따라 처음부터 다중 패키지 소프트웨어 저장소를 구축하며, 한 번의 실행에서 약 70만 토큰을 사용하고 최대 수 시간 동안 지속됩니다.
기존 저장소의 장기 소프트웨어 엔지니어링: 기존 코드베이스에서 기능 개발, 결함 수정 및 여러 파일에 걸친 변경과 같은 복잡한 작업을 수행합니다.
다중 라운드 터미널 자동화 작업: 에이전트가 명령줄 환경에서 수백 라운드의 도구 호출을 연속 실행해 시스템 구성 및 운영 작업을 완료합니다.
대규모 코드베이스 리팩터링 및 마이그레이션: 저장소 간 기술 스택 업그레이드, 전면 리팩터링처럼 수 시간 동안 연속적인 계획과 실행이 필요한 엔지니어링 작업입니다.
다중 에이전트 협업 작업: 주 에이전트가 하위 에이전트에 작업을 위임하는 계층적 실행 시나리오에서 궤적 처리를 통해 분기 구조를 활용해 하위 작업의 학습 비용을 제어할 수 있습니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0