
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-28
01Unlimited OCR 2란
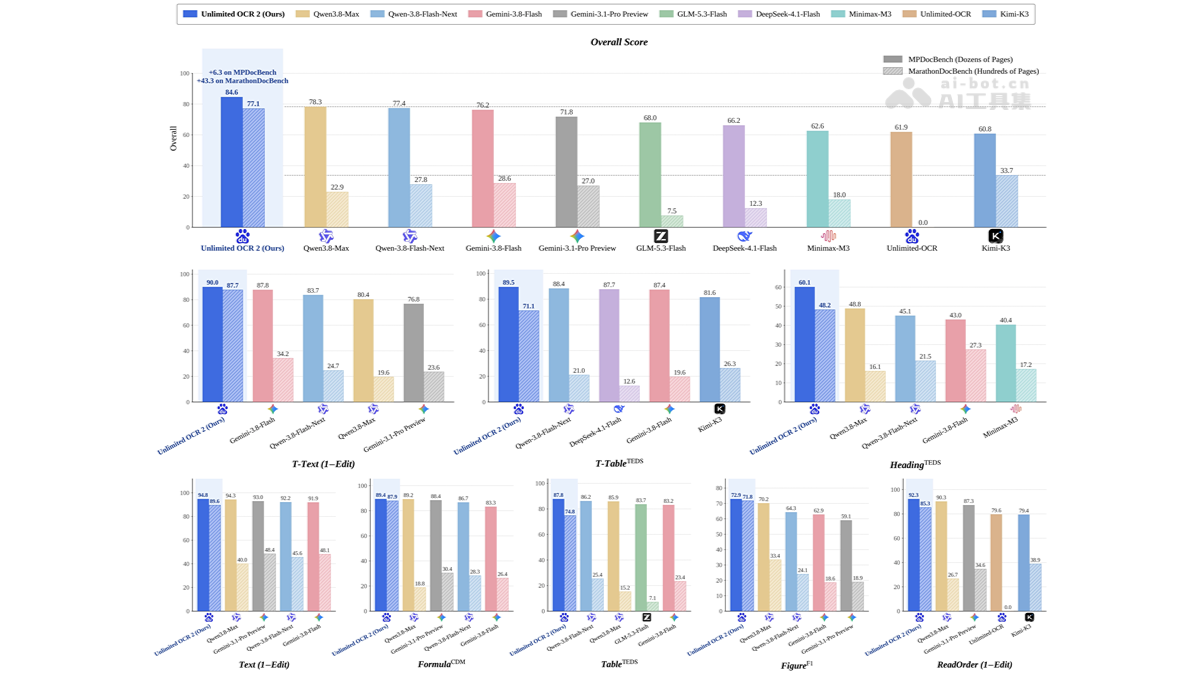
Unlimited OCR 2는 바이두 원신이 오픈소스로 공개한 엔드투엔드 문서 분석 모델로, 페이지 수에 제한 없이 초장문 문서를 분석하며 수천 페이지의 책도 한 번에 처리하면서 정확도와 효율을 유지합니다. Unlimited OCR 2는 희소 참조 슬라이딩 윈도우 어텐션 메커니즘과 무한 디코딩 메커니즘을 사용해 장문 문서의 연산량과 GPU 메모리 사용량을 줄입니다. 또한 MPDocBench, MarathonDocBench 등의 벤치마크에서 SOTA를 달성하며 OCR을 3.0 시대로 이끌고 있습니다.
02Unlimited OCR 2의 주요 기능
페이지 수 제한 없는 분석: 기존 페이지 수 제한을 넘어 수천 페이지 규모의 장문 문서를 한 번에 처리합니다.
장문 문서 고정밀 이해: 문서 길이가 크게 늘어나도 높은 분석 정확도와 처리 효율을 유지합니다.
페이지 간 정보 연계: 앞부분을 다시 확인하고 페이지를 넘나드는 내용을 대조해 여러 페이지를 결합할 때 발생하는 문맥 단절을 줄입니다.
오픈소스 사용 가능: 코드와 모델 가중치를 공개했으며, 바이두 스마트 클라우드와 바이두 AI 오픈 플랫폼에서도 제공됩니다.
03Unlimited OCR 2의 기술 원리
WeChat에서 팔로우한 후 “开源”로 답장하면 AI 오픈소스 프로젝트 교류 그룹에 참여할 수 있습니다.
SR-SWA 희소 참조 슬라이딩 윈도우 어텐션: 사람이 책을 옮겨 적을 때 “현재 페이지에 집중하고 필요할 때 앞부분을 다시 확인하는” 방식을 참고합니다. Page Gate를 통해 각 쿼리의 시각적 참조 범위를 전체 문서에서 관련 페이지로 축소하고 페이지 간 위치 관계를 모델링합니다. 또한 점수가 가장 높은 Visual Token Buckets를 도입해 장거리 시각적 의존성을 포착하고, Full Attention이 전체 문서 토큰에 수행하는 중복 계산을 방지합니다.
Unlimited-Horizon Decoding 무한 디코딩 메커니즘: 초장문 문서 분석에서 발생하는 연산량 및 GPU 메모리 병목에 맞춰 디코딩 과정을 최적화합니다. 더 많은 페이지를 처리할 때 모델이 컨텍스트 길이의 하드 제한에 걸리지 않도록 하여 “페이지 수 제한 없는” 분석 목표를 지원합니다.
엔드투엔드 장문 문서 모델링: 기존 OCR처럼 페이지별 인식 결과를 이어 붙이는 방식이나, 연속된 수십 페이지까지 확장하는 데 그쳤던 이전 세대 R-SWA와 달리, Unlimited OCR 2는 페이지 간 선택, 참조 및 재확인, 현재 페이지 이해를 통합된 엔드투엔드 프레임워크에 담아 장문 문서 분석의 일관성과 완성도를 높입니다.
효율 및 비용 제어: SR-SWA의 단일 단계 디코딩 속도는 Full Attention보다 7배, 이전 세대 R-SWA보다 5.6배 빠릅니다. 핵심적인 이점은 전역 전체 어텐션을 희소 참조로 대체한 데서 비롯됩니다.
04Unlimited OCR 2 사용 방법
진입점 선택: GitHub 또는 Hugging Face에서 코드와 가중치를 다운로드해 로컬에 배포합니다.
문서 준비: PDF, 스캔 문서 또는 장문 문서를 정리하고 페이지가 완전하며 선명하고 방향이 올바른지 확인합니다.
업로드 또는 로드: 온라인 진입점에서는 문서를 직접 업로드하고, 로컬 배포에서는 환경을 구성한 후 Unlimited OCR 2 모델 가중치를 로드합니다.
작업 설정: 페이지 또는 API 매개변수에 따라 출력 형식, 분석 범위, 표 및 레이아웃 인식 등의 옵션을 선택합니다.
분석 실행: 작업을 제출하고 모델이 페이지 간 이해, 콘텐츠 추출 및 구조화된 생성을 완료할 때까지 기다립니다.
결과 검증: 페이지를 넘나드는 제목, 표, 수식, 페이지 번호, 인용 및 문단의 연속성을 중점적으로 확인합니다.
내보내기 및 통합: 텍스트, Markdown 또는 JSON으로 내보내거나 API를 통해 일괄 처리 및 업무 시스템에 연동합니다.
05Unlimited OCR 2의 핵심 장점
페이지 수 제한 없는 분석: 기존 OCR의 페이지 수 제한을 넘어 수천 페이지 규모의 장문 문서를 처리할 수 있습니다.
안정적인 장문 문서 정확도: 페이지 수가 크게 늘어나도 높은 분석 정확도와 효율을 유지합니다.
강력한 페이지 간 이해: 앞부분을 다시 확인하고 페이지를 넘나드는 정보를 연계해 결합 과정에서 발생하는 문맥 단절을 줄입니다.
높은 연산 효율: SR-SWA가 전체 어텐션을 희소 참조로 대체해 중복 연산을 크게 줄입니다.
낮은 GPU 메모리 사용량: 무한 디코딩 메커니즘과 결합해 초장문 문서 분석의 GPU 메모리 부담을 완화합니다.
우수한 벤치마크 성능: 문서에 따르면 MPDocBench, MarathonDocBench 등의 장문 문서 벤치마크에서 SOTA를 달성했습니다.
06Unlimited OCR 2 프로젝트 주소
GitHub 저장소: https://github.com/baidu/Unlimited-OCR
HuggingFace 모델 저장소: https://huggingface.co/spaces/baidu/Unlimited-OCR-2
07Unlimited OCR 2의 활용 시나리오
장편 서적 및 문헌 분석: 소설, 교재, 고전 문헌 전체를 빠르게 디지털화하면서 페이지 간 문맥을 보존합니다.
연구 보고서 및 재무 보고서 분석: 수백 페이지의 연구 보고서와 연차 보고서를 한 번에 입력해 관점, 지표 및 위험 요소를 추출합니다.
법률 및 규정 준수 검토: 법령집, 계약 기록 및 사건 자료를 처리하고 페이지를 넘나드는 조항 연계를 지원합니다.
기록물 및 증빙 서류 디지털화: 스캔 기록물, 의료 기록 및 역사 자료를 일괄적으로 구조화된 텍스트로 변환해 저장합니다.
RAG 및 지식 베이스 구축: 초장문 PDF를 검색 가능한 콘텐츠로 분석해 질의응답, 검색 및 에이전트 호출에 활용합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0