
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-11-02
01Xiaomi-OCR-0이란
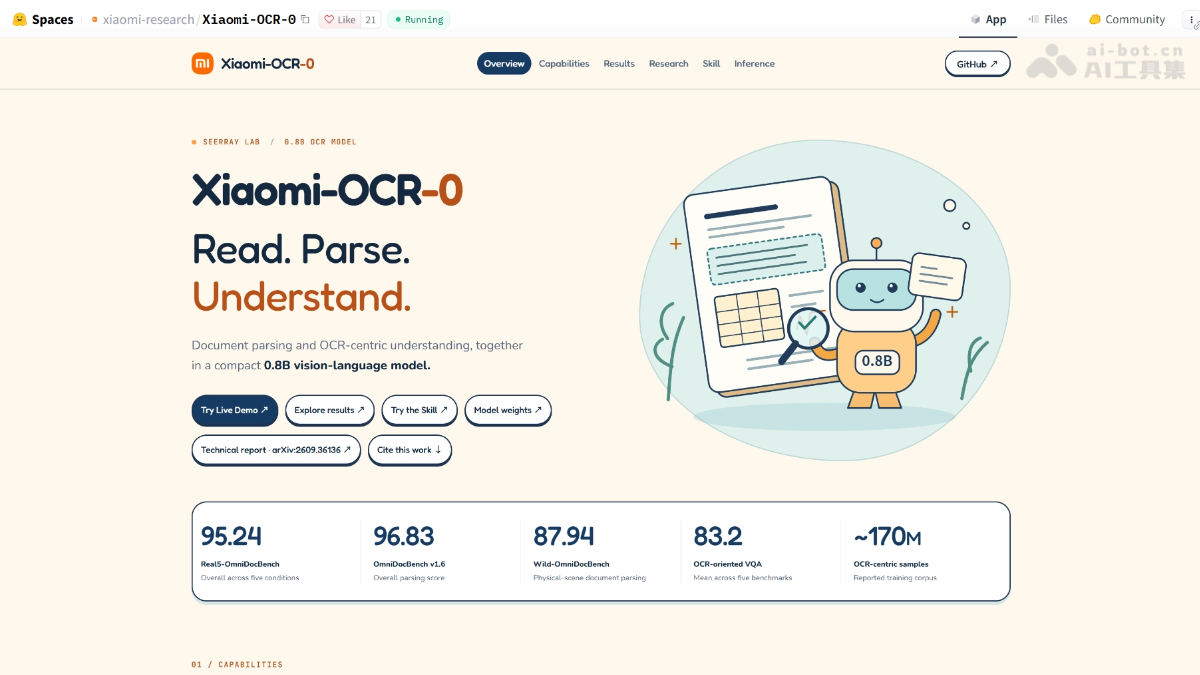
Xiaomi-OCR-0은 샤오미가 오픈 소스로 공개한 0.8B 경량 멀티모달 문서 이해 모델로, Qwen3.5-0.8B를 기반으로 학습되었으며 문서 파싱, 핵심 정보 추출, OCR 시각 질의응답을 하나로 통합합니다. Real5-OmniDocBench에서 95.24점으로 1위, OmniDocBench v1.6에서 96.83점으로 2위를 차지했으며, 5개 OCR-VQA 평균 83.2점으로 동급 모델을 능가합니다. Xiaomi-OCR-0의 데이터 엔진은 전문가 합의 라벨링과 렌더링 검증을 사용하고, MCP 및 Agent Skill 도구 체인을 지원하며, 샤오미 스마트폰의 ‘슈퍼 샤오아이’에 이미 적용되었습니다.
02Xiaomi-OCR-0의 주요 기능
문서 파싱: 문서의 본문, 복잡한 표와 수학 공식을 인식하고 복원하여 자연스러운 읽기 순서에 따라 Markdown/LaTeX 구조화 결과를 출력합니다.
핵심 정보 추출(KIE): 청구서, 카드 및 증서 등 반구조화 문서에서 지정된 필드를 정확히 찾아 JSON 구조화 데이터로 출력합니다.
OCR 시각 질의응답: 단순한 텍스트 변환을 넘어 문서와 차트의 요소 간 검색, 수치 계산, 의미 추론 질의응답을 지원합니다.
03Xiaomi-OCR-0의 기술 원리
위챗에서 ‘开源’라고 답장하여 AI 오픈 소스 프로젝트 교류 그룹에 참여
이기종 전문가 합의 라벨링(ETC): 아키텍처, 데이터, 전략이 서로 다른 8개의 OCR 전문가 모델이 문서 영역을 독립적으로 예측합니다. 텍스트(NED), 표(TEDS), 수식(CDM)에 대해 쌍별 일치도를 각각 계산한 뒤 합의도가 가장 높은 삼중항을 선택하고 그 중앙 최빈값을 의사 라벨로 사용합니다. 합의도가 ≥0.9인 고신뢰 샘플만 학습 세트에 직접 포함하여 단일 모델의 편향을 원천적으로 걸러냅니다.
렌더링 유도 검증(Render-Guided Refine-and-Judge): 전문가 의견이 불일치하는 영역에 대해 Qwen3.5-122B-A10B로 후보 파싱 결과를 이미지로 다시 렌더링하고, 원본 영역과 픽셀 및 구조 수준에서 비교하여 행·열 위치 오류와 기호 누락 등 숨겨진 결함을 찾습니다. 최대 3회 반복 수정하며, 여전히 수렴하지 않는 결과는 전체 검증 이력을 포함한 2단계 ‘진단-수정-검증’ 과정으로 넘깁니다. 최종적으로 전문가 풀에서 다시 합의를 이루어야 채택됩니다.
샘플 마이닝 및 맞춤형 합성: 학습 구성 비율은 전문가 합의도, 모델 자기 일관성, K-Means 의미 클러스터링이라는 세 가지 신호로 결정됩니다. 이를 바탕으로 CPT용 광범위 혼합 세트와 RL용 고난도 사례 세트를 각각 구성합니다. 합성 데이터는 ‘커버리지 기반’과 ‘실패 기반’의 두 경로로 생성되며, 레시피의 효과는 동결 검증 세트에서 검증된 후에만 채택됩니다.
점진적 3단계 학습: 먼저 Q-Mask 텍스트 앵커 사전 학습으로 텍스트 내용과 공간 위치의 세밀한 정렬을 구축합니다. 다음으로 다중 작업 OCR 지속 사전 학습을 수행하여 동일한 자기회귀 형식에서 전체 페이지 파싱, 영역 인식, VQA 등의 작업 범위를 확장합니다. 마지막으로 마이닝된 난제에 DAPO 방식의 Mix-RL 강화 학습을 적용해 마무리하며, 작업 유형별로 보상을 라우팅하고 검증 가능한 보상으로 복잡한 레이아웃과 다단계 추론의 한계를 돌파합니다.
04Xiaomi-OCR-0 사용 방법
코드 받기: GitHub 저장소 SeerRay-Lab/Xiaomi-OCR-0을 복제하고 requirements에 명시된 의존성 환경을 설치합니다.
가중치 다운로드: Hugging Face의 SeerRay-Lab/Xiaomi-OCR-0에서 0.8B 모델 가중치 파일을 받습니다.
빠른 체험: 프로젝트에 포함된 스크립트를 실행하여 브라우저 기반 대화형 Demo를 시작하고, 문서 이미지를 업로드해 파싱·추출·질의응답을 온라인으로 테스트합니다.
Agent 호출 구성: 저장소의 MCP 서비스 또는 Agent Skill을 에이전트에 연결하여 ‘화면/문서 인식-필드 추출-다음 단계 실행’ 자동화 흐름을 구현합니다.
로컬 서비스 배포: SGLang 또는 vLLM으로 모델을 로컬 추론 서비스로 배포하여 업무 시스템에서 API로 호출합니다.
레이아웃 감지 연동: 2단계 파이프라인을 사용할 때 먼저 PP-DocLayoutV3로 텍스트·표·수식 영역을 감지한 뒤, 각 영역을 Xiaomi-OCR-0에 보내 인식하고 페이지 단위 결과로 조합합니다.
지시문 작성: 통일된 image–instruction–response 형식으로 프롬프트를 구성하고, 파싱·KIE·VQA 작업 유형을 각각 지정합니다.
05Xiaomi-OCR-0의 핵심 장점
탁월한 파라미터 효율: 불과 0.8B 파라미터로 OmniDocBench v1.6에서 96.83점을 기록했으며, 0.8B–1.2B 전용 모델이 GPT-5.2, Qwen3-VL-235B 등 범용 대규모 모델을 전면적으로 능가합니다.
실제 수집 환경의 강건성 1위: Real5-OmniDocBench에서 95.24점으로 1위를 차지했으며, 스캔, 종이 휘어짐, 화면 재촬영, 불균일한 조명, 기울어진 촬영의 5가지 방해 환경에서 모두 앞섰습니다.
세 가지 기능의 통합: 문서 파싱, 핵심 정보 추출, OCR 시각 질의응답을 하나의 모델에 통합하고, 공통 지시 인터페이스로 작업을 전환하므로 여러 전용 모델을 조합할 필요가 없습니다.
파라미터 확장 대신 데이터 엔진: 1.7억 개 샘플을 전문가 합의 투표, 렌더링 유도 검증, 실패 기반 합성으로 자동 생성하여 모델 규모 대신 데이터 품질을 높였습니다.
커리큘럼 학습의 긍정적 전이: 파싱이 성숙한 뒤 이해 감독 신호가 파싱 성능을 최대 +0.64점 향상시켜 경량 모델에서 두 능력을 동시에 끌어올립니다.
06Xiaomi-OCR-0 프로젝트 주소
프로젝트 공식 사이트: https://huggingface.co/spaces/xiaomi-research/Xiaomi-OCR-0
GitHub 저장소: https://github.com/xiaomi-research/Xiaomi-OCR-0
Hugging Face 모델 저장소: https://huggingface.co/xiaomi-research/Xiaomi-OCR-0
arXiv 기술 논문: https://arxiv.org/pdf/2609.36136
07Xiaomi-OCR-0의 활용 시나리오
실시간 생활 증빙 관리: 배달 음식 수령 코드, 택배 수령 코드, 대기 번호 등 시간 민감 정보를 인식해 ‘섬’에 저장하고 필요할 때 한 번의 터치로 확인합니다.
스마트 가계부 및 청구서 정리: 위챗/알리페이 결제 내역에서 금액, 가맹점, 시간, 카테고리를 한 번에 추출하여 가계부 기록을 자동으로 생성합니다.
카드·증빙 문서 구조화 입력: 사진 촬영이나 화면 인식으로 신분증, 은행 카드, 청구서, 여권 등의 필드를 JSON으로 추출하여 수동 입력과 대조를 대체합니다.
일정 자동 생성: 단체 채팅 알림과 행사 포스터에서 시간과 장소를 추출하여 일정 카드를 자동 생성하고 캘린더에 추가합니다.
이동 정보 연동: 채팅에서 항공편 번호 등 여행 정보를 추출하고, 실시간 출발·도착 현황을 자동으로 조회하여 알림을 전송합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0