
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-09
01Ling-3.0-flash-VL이란
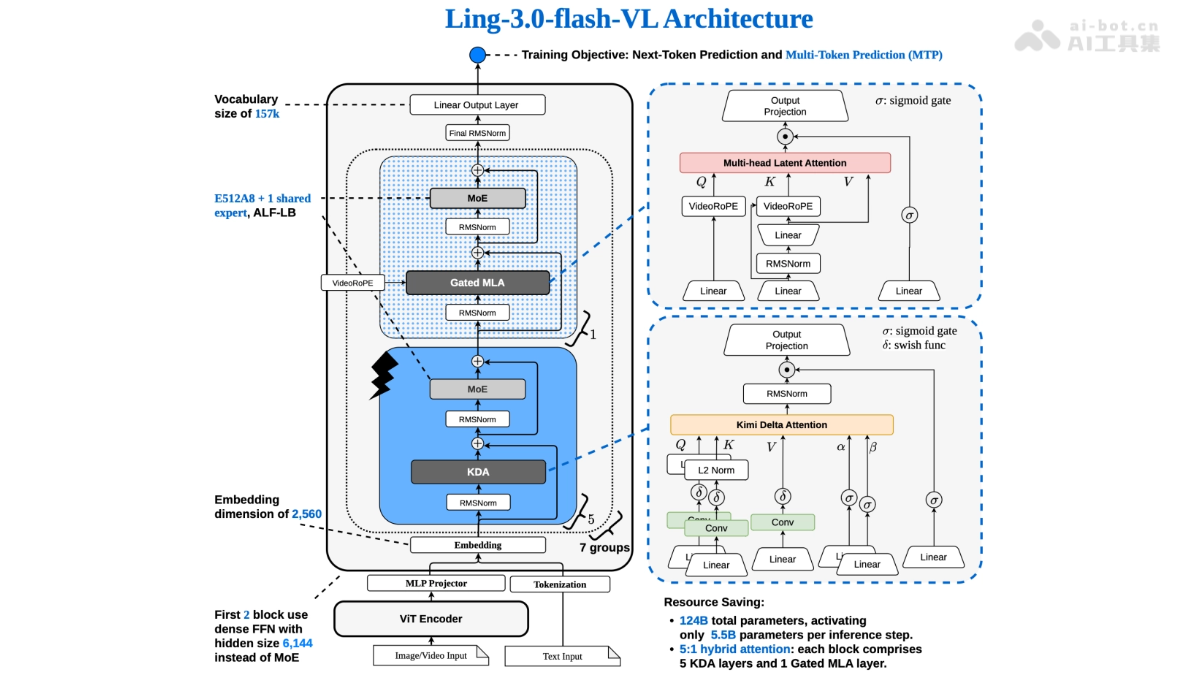
Ling-3.0-flash-VL은 Ant Group InclusionAI 백령 시리즈의 첫 번째 오픈 소스 네이티브 멀티모달 대규모 모델로, Ling-3.0-flash의 MoE 아키텍처를 확장했습니다. 총 매개변수는 124B이며 한 번의 추론에서 5.5B만 활성화되고, 이미지·텍스트 및 동영상 입력을 네이티브로 지원하며 컨텍스트 윈도우는 256K Token에 달합니다. Ling-3.0-flash-VL은 모델이 사람처럼 관찰하고, 행동하고, 검증하며 수정하도록 하여 작업을 일회성 생성에서 신뢰할 수 있는 지속적 결과물 제공으로 전환합니다.
02Ling-3.0-flash-VL의 주요 기능
실시간 시각적 상호작용: 카메라를 켜고 보면서 대화할 수 있으며, 동식물·랜드마크·차종을 식별하고 외국어 표지판을 실시간으로 번역합니다.
시각 피드백 프로그래밍: 웹페이지 스크린샷을 바탕으로 프런트엔드 코드를 생성하고 렌더링 결과와 대조해 스스로 수정하여 웹페이지를 재현합니다.
GUI Agent: 인터페이스 구조와 조작 상태를 인식하고 웹 데이터 조회, Excel 정리, 차트 생성 등 여러 도구를 넘나들며 작업을 수행합니다.
의료 보고서 해석: 혈액검사, 생화학검사, 영상검사 등의 여러 페이지와 기간에 걸친 지표를 추출하고 건강 위험을 빨강·노랑·초록 신호등으로 표시합니다.
실시간 학습 파트너: 강의 동영상에서 화면 속 공식과 판서를 인식하고 즉시 질문에 답하며 연습문제를 생성합니다.
장시간 동영상 하이라이트 편집: 시간 단위의 경기 동영상에 대해 ”탐색→추출→검증→수정”을 수행하고 하이라이트 모음을 자동으로 합성합니다.
03Ling-3.0-flash-VL의 기술 원리
WeChat에서 “开源”에 답장하고 AI 오픈 소스 프로젝트交流群에 참여하세요
MoE 고효율 희소 아키텍처: Ling-3.0-flash를 확장한 모델로 총 매개변수는 124B이며, 추론마다 5.5B의 매개변수만 활성화됩니다. 성능을 유지하면서 연산 비용을 크게 줄여 Agent 워크플로의 빈번한 실행 노드로 적합합니다.
네이티브 멀티모달 공동 학습: 이미지, 텍스트, 동영상을 하나의 학습 과정에서 함께 최적화하며, 텍스트를 먼저 학습한 뒤 시각 모듈을 추가하는 방식이 아닙니다. 실제 적용 결과 시각 정보의 도입은 텍스트 능력을 저하시키지 않았을 뿐 아니라 Artificial Analysis Intelligence Index에서 4점 향상을 가져왔습니다.
임의 해상도 시각 인코딩과 VideoRoPE: 다양한 크기의 이미지·텍스트 입력을 처리하기 위해 임의 해상도 시각 인코더를 도입하고, VideoRoPE 위치 인코딩과 결합해 네이티브 동영상을 이해합니다. 동영상을 프레임으로 분할해 이미지 시퀀스로 저하할 필요가 없습니다.
KDA와 Gated MLA 혼합 언어 백본: 언어 부분은 42개 층의 혼합 아키텍처를 유지하며, 선형 어텐션 메커니즘 KDA와 게이트형 MLA를 5:1 비율로 교차 배치합니다. 긴 컨텍스트 처리 효율과 모델링 정확도를 모두 확보해 256K Token 컨텍스트 윈도우를 지원합니다.
시각 피드백 폐쇄 루프 메커니즘: 모델은 ”관찰→행동→검증→수정”의 순환 실행 방식을 도입해 작업을 일회성 생성에서 여러 차례 반복으로 전환합니다. 먼저 시각 정보를 이해하고 행동한 뒤 실행 결과를 관찰해 목표와 대조하고, 편차가 발견되면 전략을 수정하여 결과물의 신뢰성과 검증 가능성을 보장합니다.
04Ling-3.0-flash-VL 사용 방법
온라인 체험: 공식 웹사이트 열기: Ling Studio 공식 웹사이트 https://chat.ant-ling.com/chat에 접속합니다.
무료 사용: 현재 무료 체험 기간으로, 로그인 후 바로 대화할 수 있습니다.
자료 업로드: 텍스트 프롬프트를 입력하고 이미지나 동영상을 업로드해 멀티모달 상호작용을 진행할 수 있습니다.
사용 시나리오: 웹페이지 스크린샷 재현, 동영상 질문, 사진 인식 등 대표 기능을 테스트할 수 있습니다.
로컬 배포: 모델 다운로드: Hugging Face 또는 ModelScope에서 오픈 소스 가중치를 받을 수 있으며, BF16 및 FP8 버전을 사용할 수 있고 FP4/INT4 버전은 곧 출시될 예정입니다.
환경 준비: 해당 매개변수 규모를 지원하는 추론 환경을 구성합니다.
추론 실행: 주요 추론 프레임워크로 모델을 로드합니다. 이미지·텍스트 및 동영상 입력을 네이티브로 지원하며 컨텍스트를 256K Token까지 확장할 수 있습니다.
워크플로 연결: API를 통해 시각 Agent의 실행 노드로 사용하고 ”관찰→행동→검증→수정”의 다단계 작업 흐름에 통합합니다.
05Ling-3.0-flash-VL의 핵심 장점
멀티모달의 텍스트 능력 향상: 네이티브 멀티모달 공동 학습은 텍스트 능력을 약화시키지 않았을 뿐 아니라 Artificial Analysis Intelligence Index에서 순수 텍스트 버전보다 4점 향상되었습니다.
시각 피드백 폐쇄 루프: ”관찰→행동→검증→수정”의 반복 메커니즘을 통해 작업을 일회성 생성에서 신뢰할 수 있고 검증 가능한 지속적 결과물 제공으로 업그레이드합니다.
탁월한 추론 효율: 총 매개변수 124B에서 한 번의 추론에 5.5B만 활성화되어 연산 및 Token 비용을 크게 낮추며, 빈번한 다단계 호출에 적합합니다.
초장문 컨텍스트: 256K Token을 네이티브로 지원해 긴 문서 분석, 장시간 동영상 분석, 다단계 Agent의 기록 기억을 쉽게 처리합니다.
전 모달리티 네이티브 입력: 임의 해상도 시각 인코더와 VideoRoPE를 도입해 이미지, 텍스트, 동영상을 네이티브로 처리하며 프레임 분할로 성능을 낮출 필요가 없습니다.
뛰어난 실측 성능: Image-to-WebDev Arena 평가에서 5.5B 활성 매개변수 규모로 GPT-5.4를 넘어서는 점수를 기록했습니다.
06Ling-3.0-flash-VL 프로젝트 주소
HuggingFace 모델 저장소: https://huggingface.co/inclusionAI/Ling-3.0-flash-VL
https://huggingface.co/inclusionAI/Ling-3.0-flash-VL-fp8
07Ling-3.0-flash-VL의 활용 시나리오
프런트엔드 개발 및 웹페이지 재현: 디자인 시안 스크린샷을 바탕으로 실행 가능한 웹페이지 코드를 생성하고 렌더링 비교를 통해 지속적으로 스스로 수정합니다.
GUI 사무 자동화: 웹 데이터 수집, Excel 정리, 차트 자동 생성 등 여러 소프트웨어를 넘나들며 작업을 수행합니다.
의료 보고서 보조 해석: 혈액검사, 생화학검사, 영상검사 등 여러 보고서를 통합하고 이상 지표를 추출해 건강 위험을 빨강·노랑·초록 신호등으로 등급별 표시합니다.
온라인 교육 학습 파트너: 강의 동영상을 보며 화면 속 공식과 판서를 설명하고 즉시 질문에 답하며 학습 내용을 바탕으로 연습문제를 생성합니다.
스포츠 경기 하이라이트 편집: 시간 단위의 경기 장시간 동영상에 대해 ”탐색→추출→검증→수정”을 수행하고 매끄러운 하이라이트 영상을 자동으로 합성합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0