
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-15
01DMAD란
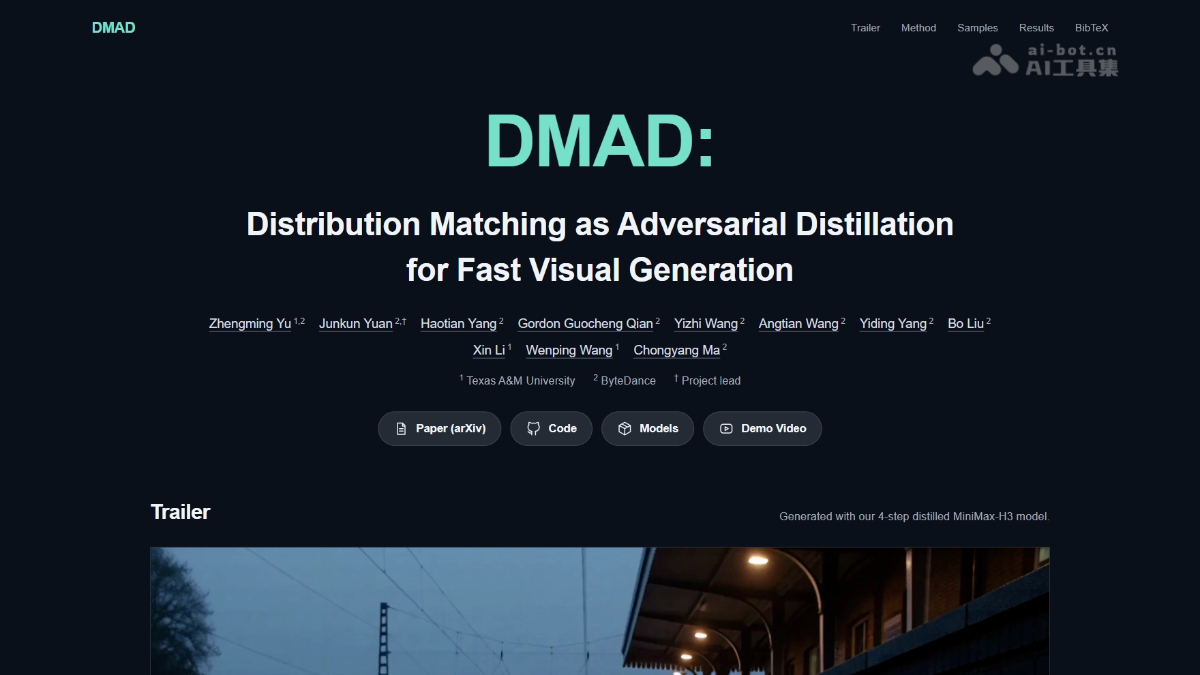
DMAD(Distribution Matching as Adversarial Distillation)는 바이트댄스와 텍사스 A&M 대학교가 공동으로 오픈 소스화한 소스텝 증류 프레임워크로, 확산 모델 생성을 가속합니다. DMAD는 이진 분류 판별기를 학습하여 목표 분포와 학생 분포의 차이를 직접 학습하고, 보조 확산 모델을 생략하여 50스텝 교사 모델을 4스텝 학생 모델로 증류합니다. 현재 ImageNet, SDXL, Wan2.1 및 MiniMax-H3-33B를 지원하며, 8GB VRAM으로 약 5초 분량의 1344×768 오디오 포함 동영상을 생성할 수 있습니다.
02DMAD의 주요 기능
소스텝 이미지 생성: ImageNet-64의 EDM 모델을 1스텝 샘플링으로 증류하여 FID를 1.04까지 낮추며, SDXL은 4스텝만으로 텍스트를 이미지로 변환합니다.
소스텝 텍스트-비디오 생성: Wan2.1-T2V-14B를 4스텝 학생 모델로 증류하여 VBench 85.15를 달성합니다.
통합 오디오·비디오 생성: MiniMax-H3-33B의 50스텝 교사 모델을 4스텝으로 증류하여 1344×768 동영상과 32kHz 네이티브 스테레오 오디오를 출력합니다.
소비자용 하드웨어 지원: 8GB VRAM ComfyUI 워크플로와 저VRAM 명령줄 추론을 제공하며, 8GB 그래픽 카드로 약 5초, 12GB로 약 15초 분량의 오디오 포함 동영상을 생성할 수 있습니다.
학습 및 추론 완전 오픈 소스: 증류 방법, 학습 코드, 추론 스크립트 및 여러 모델의 LoRA 가중치를 공개하며, 명령줄과 ComfyUI 두 가지 사용 방식을 지원합니다.
03DMAD의 기술 원리
WeChat에서 팔로우 후 “开源”에 답장하여 AI 오픈 소스 프로젝트 교류 그룹에 가입하세요.
분포 매칭 기반 적대적 증류: DMAD는 이진 분류 판별기를 학습하여 목표 샘플과 학생 샘플을 구분합니다. 최적 판별기의 logit은 두 분포의 로그 밀도비와 같으며, 입력에 대한 gradient를 구하면 score 차이를 얻을 수 있습니다. 이를 통해 학생 모델의 수정 방향을 직접 계산하고 보조 score 피팅 모델을 생략합니다.
공유 백본과 이중 헤드 판별기: 판별기는 하나의 공유 특징 백본과 두 개의 판별 헤드로 구성됩니다. 교사 헤드는 교사 샘플과 학생 샘플을 구분하고, 실제 데이터 헤드는 실제 샘플과 학생 샘플을 구분하며, 모두 이진 교차 엔트로피로 학습합니다. 학생 모델은 두 logit의 가중 선형 손실로 업데이트되며, 업데이트 중에는 판별기 파라미터를 고정하되 gradient 역전파는 유지합니다.
노이즈 구간 동적 가중: 교사 샘플과 실제 데이터의 분포 차이는 노이즈 수준에 따라 달라집니다. DMAD는 실제 데이터 헤드가 두 종류의 샘플에서 보이는 평균 logit 차이를 경험적 신호로 사용하고, 0.99 감쇠율의 지수 이동 평균으로 각 노이즈 구간을 추적합니다. 차이가 작은 구간에는 더 높은 교사 가중치를 부여하고, 정규화한 뒤 학생 손실에 반영합니다.
오프라인 교사 샘플로 학습 가속: 교사는 미리 생성하여 캐시한 샘플만 제공하므로 학습 중 교사를 온라인으로 호출할 필요가 없습니다. 4장의 H200과 MiniMax-H3 rank-128 LoRA 설정에서 학생 업데이트 및 연관 판별기 업데이트 시간은 818.1초에서 233.3초로 단축되어 약 3.51배의 학습 가속을 달성했습니다.
04DMAD 사용 방법
저장소 복제: git clone https://github.com/Yzmblog/DMAD.git을 실행하고 프로젝트 디렉터리로 이동합니다.
환경 생성: conda로 Python 3.12 환경을 생성하고 활성화합니다.
종속성 설치: 공식 고정 버전에 따라 PyTorch 2.11.0(cu126), torchvision, torchaudio를 설치한 뒤 pip install -r requirements.txt 및 pip install -U modelscope-hub를 실행합니다.
하드웨어 준비: CUDA를 지원하는 NVIDIA 그래픽 카드가 있는지 확인하고, 약 64GB의 시스템 메모리와 170GB의 디스크 공간을 확보합니다.
기본 모델 다운로드: modelscope download MiniMax/MiniMax-H3를 통해 MiniMax-H3 기본 모델을 다운로드합니다.
증류 가중치 다운로드: ModelScope에서 DMAD의 4스텝 LoRA를 다운로드합니다.
명령줄 추론: inference.py를 실행하고 모델 경로, LoRA, 프롬프트 파일, --steps 4, --height 768 --width 1344를 지정합니다. VRAM에 따라 --low-vram 8 또는 --low-vram 12를 선택합니다.
출력 확인: 출력 디렉터리에는 0000.mp4, 프롬프트 txt 파일 및 settings.json이 포함됩니다. 실행이 확인되면 자체 프롬프트 파일로 교체할 수 있습니다.
05DMAD의 핵심 장점
대폭 향상된 추론 속도: 50스텝 교사 모델을 4스텝 학생 모델로 증류하여 디노이징 반복 횟수를 92% 이상 줄이면서도 교사 모델에 가까운 생성 품질을 유지합니다.
높은 학습 효율: 판별기가 분포 차이를 직접 학습하여 보조 확산 모델을 생략하며, 4장의 H200에서 학습 업데이트를 약 3.51배 가속합니다.
뛰어난 생성 품질: ImageNet-64 1스텝 생성에서 FID 1.04를 달성하여 DMD2, SiDA 등의 방법보다 우수합니다. 인간 평가에서 DMD2 대비 종합 선호율은 79.1%, rCM 대비 선호율은 84.6%입니다.
다중 모달 전 영역 지원: 하나의 프레임워크로 이미지, 텍스트-비디오 및 통합 오디오·비디오 생성을 지원합니다.
06DMAD 프로젝트 주소
프로젝트 공식 웹사이트:https://yzmblog.github.io/projects/DMAD/
GitHub 저장소:https://github.com/Yzmblog/DMAD
HuggingFace 모델 저장소:https://huggingface.co/ZhengmingYu/DMAD
arXiv 기술 논문:https://arxiv.org/pdf/2610.02188
07DMAD의 활용 분야
숏폼 동영상 콘텐츠 제작: 네이티브 오디오가 포함된 5–15초 동영상을 4스텝으로 생성할 수 있어, 제작자는 8GB 소비자용 그래픽 카드에서도 소셜 미디어 콘텐츠를 빠르게 제작하고 제작 비용을 크게 줄일 수 있습니다.
광고 및 마케팅 소재 생성: 브랜드는 프롬프트를 기반으로 제품 소개 및 상황별 동영상을 대량 생성하고 고품질 오디오 출력을 결합하여, 광고 소재를 구상부터 완성품으로 만드는 데 걸리는 시간을 단축할 수 있습니다.
영화·영상 프리비즈 및 콘셉트 디자인(Previs): 감독과 미술팀은 소스텝 증류를 활용해 촬영 프리비즈, 분위기 참고 자료 및 스토리보드 초안을 빠르게 생성하여 초기 아이디어 반복을 가속할 수 있습니다.
게임 및 애니메이션 에셋 제작: 캐릭터 애니메이션, 장면 콘셉트 이미지 및 동적 배경 에셋을 생성하여 인디 게임 스튜디오와 소규모 애니메이션 팀의 에셋 제작 비용을 줄일 수 있습니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0