
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-11-10
01Sophon-Realtime v1이란
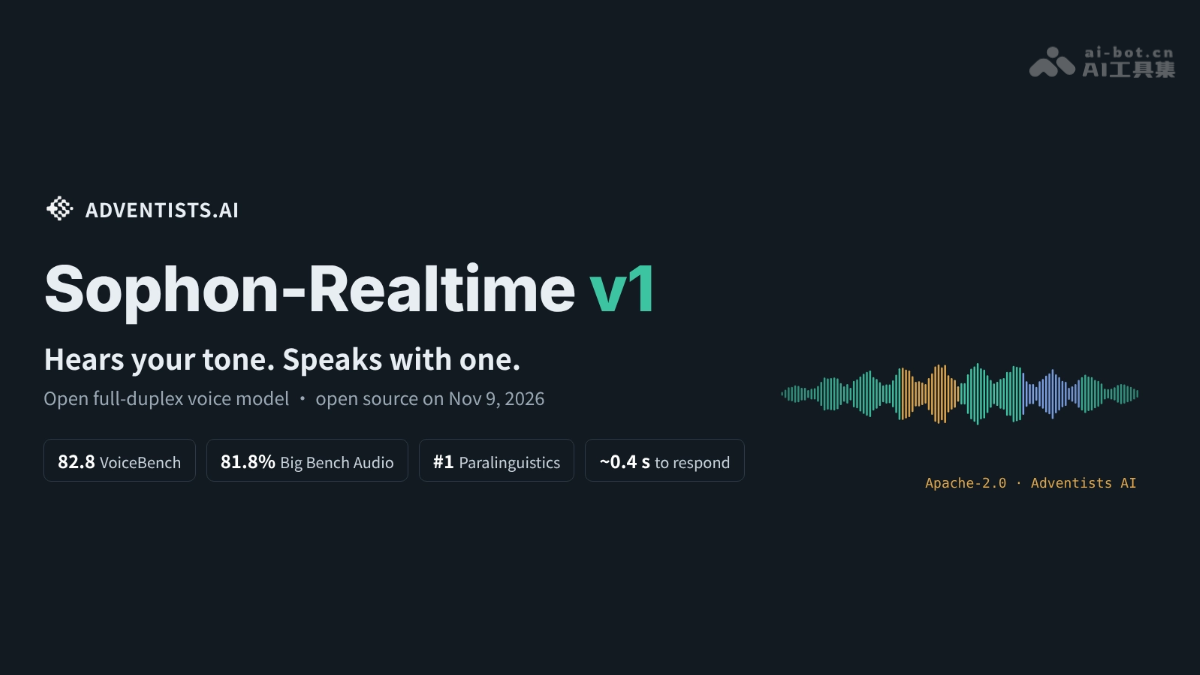
Sophon-Realtime v1은 AI降临派(Adventists AI)가 오픈 소스로 공개한 전이중 음성 모델로, 들으면서 발화 순서를 판단하고 언제든 끼어들 수 있으며, 말투·웃음·한숨을 이해하고 감정을 담은 목소리로 응답합니다. Sophon-Realtime v1은 32B 파라미터를 기반으로 하며, 음성 평가 VoiceBench에서 82.8점을 기록해 오픈 소스 전이중 모델 중 1위를 차지했습니다. Sophon-Realtime v1은 표현력이 뛰어난 Tag, 응답이 빠른 Flash, 연구 프리뷰인 E2E의 세 가지 버전을 제공하며, 80GB GPU 한 장으로 배포할 수 있고 Apache-2.0 라이선스를 적용해 상업적으로 사용할 수 있습니다.
02Sophon-Realtime v1의 주요 기능
전이중 대화: 말하는 동안에도 계속 듣고 있다가 말이 멈추면 바로 이어서 응답하며, 언제든 끼어들면 즉시 멈추고 새 질문에 답합니다.
말투 이해: 망설임, 강세, 웃음, 한숨, 반어법 등 부언어 정보를 인식하며, 단순히 문자 그대로의 내용만 듣지 않습니다.
말투 표현: 응답할 때 목소리로 자연스럽게 웃고, 한숨 쉬고, 헛기침하고, 호흡하며 텍스트를 그대로 읽지 않습니다.
멀티모달 이해: 차트와 스크린샷을 보여 주면 내용을 이해하고 음성으로 해설할 수 있습니다.
도구 호출: 다단계 도구 호출을 지원하며(Full-Duplex-Bench v3 Pass@1 48%), 실제 작업을 수행할 수 있습니다.
Live 모드: OpenAI GPT-Live 프로토콜과 호환되며 대형 모델 백엔드와 함께 작동할 수 있습니다.
빠른 배포: 명령어 한 줄과 80GB GPU 한 장만으로 서비스에 올릴 수 있으며, Flash 버전의 첫 응답 패킷은 0.31초에 불과합니다.
미세 조정 가능: ms-swift를 기반으로 LoRA 미세 조정을 수행해 페르소나, 말투, 도메인 지식 및 도구 호출 습관을 설정할 수 있습니다.
03Sophon-Realtime v1의 기술 원리
04Sophon-Realtime v1 사용 방법
환경 설치: 시스템이 Linux + CUDA + Python 3.12인지 확인한 뒤 pip install sophon-realtime을 실행합니다.
서비스 시작: sophon-realtime serve를 실행하면 처음 시작할 때 약 42GB의 Tag 가중치를 자동으로 다운로드하고, 이후 서비스는 8000 포트에서 수신 대기합니다.
인터페이스 호출: ws://HOST:8000/v1/realtime(전이중) 또는 POST /v1/chat/completions(음성 입력, 텍스트+음성 출력)를 통해 모델과 상호 작용합니다.
대화 테스트: python client_example.py --wav 내_질문.wav --lang zh --voice vivian_zh를 실행해 음성을 보내고 응답을 들을 수 있습니다.
Live 모드 연동(선택 사항): 엔진 옆에서 cd sophon-realtime/live && BUILD=tag PORT=8000 LIVE_PORT=8780 bash start_live.sh를 실행하면 OpenAI GPT-Live 프로토콜로 백엔드 대형 모델을 연동할 수 있습니다.
미세 조정 및 맞춤 설정(선택 사항): ms-swift를 사용해 80GB GPU에서 LoRA 방식으로 학습하고, JSONL 형식의 대화 데이터를 준비합니다(오디오는 형식으로 작성하고 응답에는 [laughter] 등의 태그 추가). 그런 다음 swift sft 명령을 실행하면 페르소나와 도메인 지식을 변경할 수 있습니다.
05Sophon-Realtime v1의 핵심 장점
오픈 소스 전이중 모델 1위: VoiceBench에서 82.8점을 기록해 GPT-4o-mini-Audio와 동률을 이루었으며, MiniCPM-o 4.5(76.1) 등 다른 오픈 소스 전이중 모델을 앞섭니다.
최고 수준의 음성 추론: 1,000개의 음성 추론 문제로 구성된 Big Bench Audio에서 81.8%를 맞혀, 기존 오픈 소스 최고 모델인 Raon SpeechChat(58%)을 크게 앞섭니다.
말투 이해: 청각 모델 DuplexJev가 LISTEN, StressTest, MSPB 부언어 벤치마크 종합 순위에서 1위(48.6)를 기록했으며, Gemini 3.8 Flash와 Qwen3-Omni보다 높습니다.
말투 표현: NVV-SuperBench에서 Tag 버전은 중국어 0.86, 영어 0.80을 기록했으며, 웃음·한숨·헛기침 등의 표현이 가장 자연스럽습니다.
실제 작업 수행: Full-Duplex-Bench v3 도구 호출 Pass@1이 48%로 Grok(43%)보다 높고, 응답할 차례가 되면 100% 이어받습니다.
빠르고 높은 동시성: Flash 버전은 첫 응답 패킷이 0.31초이고 GPU 한 장에서 40개 세션을 지원하며, Tag 버전은 약 0.6초에 16개 세션을 지원합니다.
06Sophon-Realtime v1 프로젝트 주소
GitHub 저장소: https://github.com/adventists-ai/sophon-realtime
07Sophon-Realtime v1의 활용 분야
지능형 고객 서비스: Flash 버전은 첫 응답 패킷이 0.31초이고 GPU 한 장에서 40개 세션을 지원하며, 고객의 감정을 이해하고 다단계 도구 호출로 업무를 처리할 수 있어 대규모 콜센터에 적합합니다.
AI 동반자 및 가상 캐릭터: Tag 버전은 말투 표현력이 가장 뛰어나 웃고 한숨 쉬며, 정서적 동반자, 가상 연인 및 게임 NPC 제작에 적합합니다.
차량용 음성 비서: 전이중 방식으로 언제든 끼어들 수 있고 지연 시간이 짧으며 호출어가 필요 없습니다. 말투를 이해해 운전자 상태 판단도 보조할 수 있습니다.
AI 하드웨어 단말: 팀의 기술은 이미 300여 종의 하드웨어 제품에 적용되었으며, Apache-2.0 라이선스로 상업적 사용이 가능해 스피커, 장난감, 로봇 등의 기기에 통합하기 적합합니다.
기업용 음성 에이전트: Live 모드는 GPT-Live 프로토콜과 호환됩니다. Sophon이 “듣고 말하는” 역할을 맡고 조회와 업무 처리는 백엔드 대형 모델에 위임해 은행, 공공 행정, 항공 등 업종별 맞춤 서비스에 적합합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0