
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-17
01Spark-Audio-1.0-Preview란 무엇인가
Spark-Audio-1.0-Preview는 중국과학기술대학교가비(科大讯飞)가 출시한 완전한 중국산 음성 기반 대규모 모델로, 0.65B 오디오 인코더와 30B-A3B MoE 언어 모델 아키텍처를 사용하며, 1,300만 시간의 오디오와 대량의 텍스트 데이터를 순수 중국산 컴퓨팅 자원으로 학습했습니다. 이 모델은 음성에 담긴 의미, 감정, 상황을 직접 이해하고 99개 언어와 202개 방언의 인식은 물론 음성 전사, 번역, 화자 식별, 감정 분석, 오디오 질의응답 등의 작업을 지원합니다. 또한 고소음, 저음량 등 복잡한 환경에서 뛰어난 성능을 보여 고객 서비스, 차량용, 의료 등 다양한 분야에 폭넓게 활용할 수 있습니다.
02Spark-Audio-1.0-Preview의 주요 기능
음성 전사: 음성을 텍스트로 직접 변환하며, 99개 언어와 202개 방언의 인식을 지원합니다.
다국어 번역: 음성에서 음성 또는 텍스트로의 다국어 번역을 수행하며, 말투와 억양 등 운율 정보를 보존합니다.
다방언 인식: 202개 방언을 지원하며, 광둥어와 원저우어 등도 이해할 수 있습니다.
환경음 인식: 사람의 음성과 주변 환경음을 동시에 이해하고, 소리가 발생한 상황을 파악합니다.
화자 식별: 누가 말하고 있는지 자동으로 구분하며, 회의 전사와 회의록 생성 등에 적합합니다.
감정 분석: 음성에 담긴 말투와 감정을 포착해 상호작용에 더욱 따뜻함을 더합니다.
오디오 질의응답: 복잡한 오디오 콘텐츠를 기반으로 이해와 질의응답을 수행해 ‘듣기’에서 ‘이해하기’로 나아갑니다.
03Spark-Audio-1.0-Preview의 기술 원리
엔드투엔드 음성 이해 아키텍처: 기존의 ‘먼저 텍스트로 변환한 뒤 대규모 모델에 전달하는’ 캐스케이드 방식과 달리, 0.65B 오디오 인코더와 30B-A3B 대규모 언어 모델을 결합합니다. 텍스트와 음성의 두 모달리티를 동일한 모델에 직접 입력해 사람의 음성, 환경음, 음악 및 그 의미·감정·상황을 한 번에 이해하며, 캐스케이드 과정에서 발생하는 정보 손실과 오류 누적 문제를 줄입니다.
오디오 인코더 사전 학습: 오디오 인코더의 사전 학습을 통해 표현 능력을 단계적으로 확장한 뒤, 사전 학습과 후속 학습으로 모델의 기본 역량, 복잡한 환경에 대한 일반화 능력, 다중 작업 성능을 향상합니다. 최종적으로 고소음, 저음량 등 실제의 복잡한 환경에서 우수한 결과를 달성했습니다.
순수 중국산 컴퓨팅 자원으로 학습: 순수 중국산 컴퓨팅 자원 클러스터를 기반으로 1,300만 시간의 오디오와 대량의 텍스트 데이터를 사용해 학습했습니다. 업계 최초로 완전한 중국산 컴퓨팅 자원으로 학습한 음성 기반 대규모 모델로서, 중국산 컴퓨팅 자원으로도 업계 최고 수준의 음성 모델을 학습할 수 있음을 입증했습니다.
미세 조정 가능한 기반 체계: iFLYTEK Spark 대규모 모델의 1+N 체계와 유사하게, Spark-Audio를 음성 기반 모델로 활용해 추가 미세 조정할 수 있습니다. 이를 통해 음성 인식, 음성 동시통역, 음성 상호작용 등의 전용 모델이나 시스템을 개발할 수 있어 다양한 음성 업무에 쉽게 적용할 수 있습니다.
04Spark-Audio-1.0-Preview 사용 방법
공식 체험 페이지 열기: 모델 체험 주소 https://iflytekresearch.iflytek.com/experience/spark-audio 에 접속합니다.
온라인으로 모델 기능 체험하기: 페이지에 텍스트나 음성을 입력해 음성 전사, 번역, 방언 인식, 오디오 질의응답 등의 기능을 체험합니다.
05Spark-Audio-1.0-Preview의 핵심 장점
순수 중국산 컴퓨팅 자원으로 학습: 업계 최초로 순수 중국산 컴퓨팅 자원 클러스터를 기반으로 학습한 음성 기반 대규모 모델로, 중국산 컴퓨팅 자원으로도 업계 최고 수준의 모델을 학습할 수 있음을 입증했습니다.
음성을 엔드투엔드로 직접 이해: ‘먼저 텍스트로 변환한 뒤 이해하는’ 캐스케이드 방식을 탈피해 말투, 감정, 환경음 등 핵심 정보를 손실하지 않고 처리하며, 단계 분리로 인한 지연과 끊김을 줄입니다.
폭넓은 다국어·다방언 지원: 99개 언어와 202개 방언의 인식을 지원하며, 동일한 규모의 모델과 비교해 다국어·다방언 인식 성능이 우수합니다.
복잡한 환경에서 뛰어난 성능: 고소음, 저음량 등 실제 응용 작업에서 뚜렷한 우위를 보이며, 소음 제거 성능이 뛰어납니다.
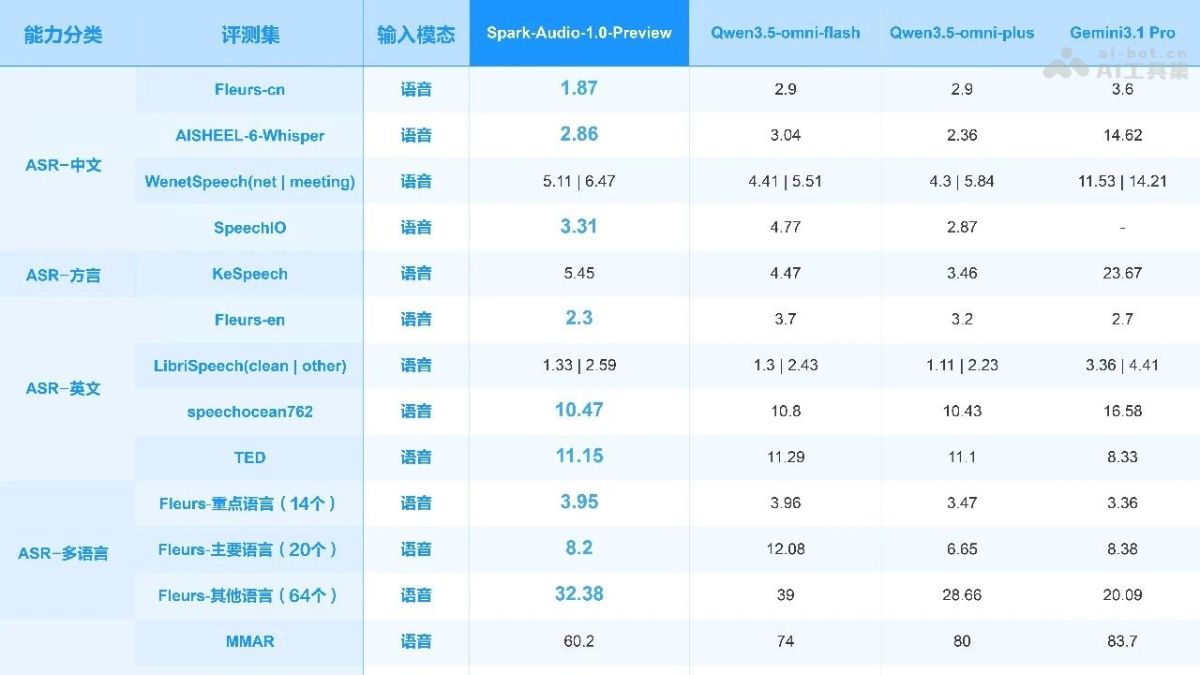
더 큰 모델과 비교해도 뒤처지지 않는 성능: 한 단계 더 큰 규모의 Qwen3.5-omni-plus와 유사한 성능을 보이며, Fleurs 중국어 테스트 세트에서 SOTA를 달성했고 여러 평가에서 Gemini-3.1 Pro를 넘어섰습니다.
텍스트 능력 저하 없음: 일반 지식, 수학, 코드 등 텍스트 작업에서 뚜렷한 성능 저하가 나타나지 않아 음성 기반 모델의 일반적인 난점을 극복했습니다.
효율적인 아키텍처: 0.65B 오디오 인코더+30B-A3B MoE 아키텍처를 사용해 작은 규모로도 더 큰 폐쇄형 모델에 가까운 성능을 구현합니다.
06Spark-Audio-1.0-Preview의 활용 분야
지능형 고객 서비스: 사용자의 감정과 표현 방식을 인식해 더욱 자연스럽고 따뜻한 대화를 구현하고, 서비스 경험을 향상합니다.
차량용 콕핏: 소음이 많은 차량 환경에서도 운전자의 명령을 정확히 인식하고 방언 상호작용을 지원해 더욱 자연스러운 차량 내 음성 상호작용 경험을 제공합니다.
실시간 번역 및 다국어 회의: 음성 동시통역과 다국어 번역을 수행하면서 말투와 억양 등 운율 정보를 보존해 더욱 자연스러운 다국어 소통 경험을 제공합니다.
회의 전사 및 회의록 생성: 화자를 자동으로 구분하고 핵심 의사결정 사항을 추출해 구조화된 회의록을 생성함으로써 담당자의 반복적인 정리 업무를 줄입니다.
의료 전자 의무기록 및 콘텐츠 심사: 음성으로 의무기록 작성과 콘텐츠 심사를 수행해 의료 등 전문 분야에서 수작업 입력 부담을 낮추고 효율을 높입니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0