
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-24
01Qwen-Audio-3.1이란
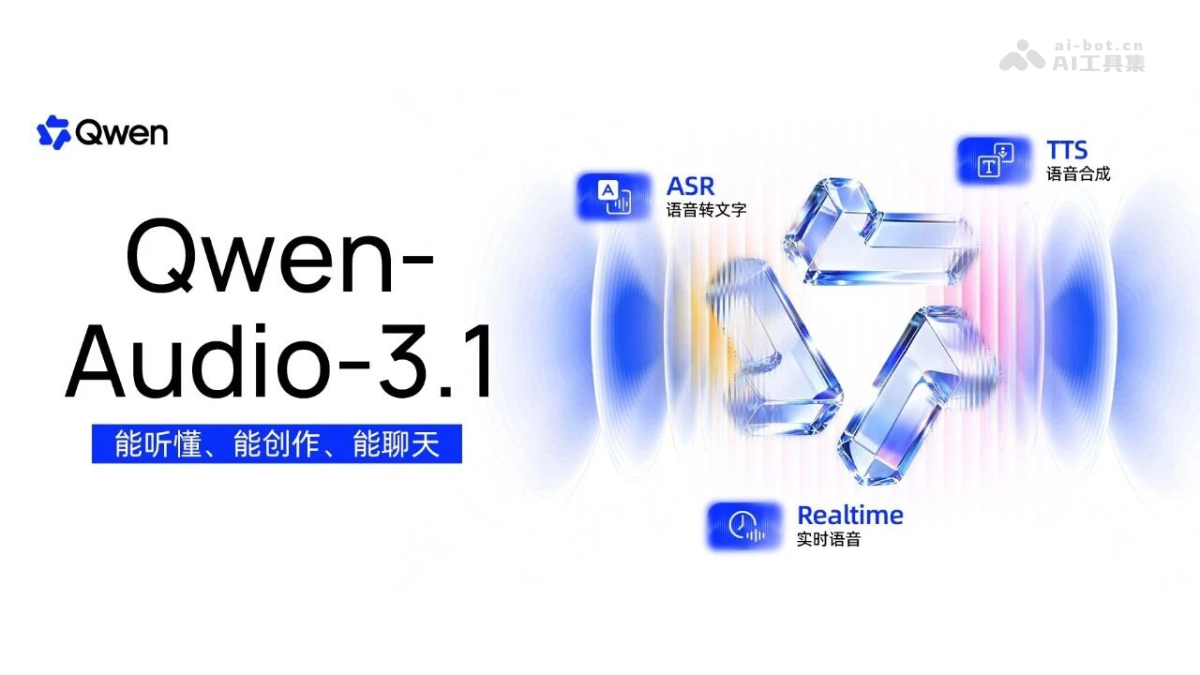
Qwen-Audio-3.1은 통이첸원에서 출시한 음성 대규모 모델 시리즈로, ASR 음성 인식, ASR-Next 오디오 이해, TTS 음성 합성, TTS-Next 오디오 창작, Realtime 실시간 상호작용의 5가지 모델로 구성되어 이해-생성-상호작용-창작 전 과정을 지원합니다. Qwen-Audio-3.1은 30개 언어와 16개 방언을 지원하며, 화자별 전사, 감정 인식, 전이중 실시간 대화가 가능하고 도구를 호출해 작업을 수행할 수 있습니다.
02Qwen-Audio-3.1의 주요 기능
ASR 음성 인식: 30개 언어와 16개 중국어 방언의 화자별 전사를 지원하며, 화자 태그와 타임스탬프를 제공하고 텍스트를 기본적으로 다듬을 수 있습니다.
ASR-Next 오디오 이해: 전사된 텍스트를 넘어 인물의 감정, 환경음과 기계음을 이해하며, 소리 설명, 이벤트 위치 확인, 오디오 질의응답을 지원합니다.
TTS 음성 합성: 다국어 및 다방언 합성을 지원하고, 동일한 음색을 언어 간 자연스럽게 전이하며, 명령으로 감정과 말하기 속도를 제어할 수 있습니다.
TTS-Next 오디오 창작: 사람 목소리, 효과음, 환경음으로 구성된 완전한 오디오를 한 번에 생성하며, 팟캐스트, 오디오북, 영화·드라마, 게임, 광고에 활용할 수 있습니다.
Realtime 실시간 상호작용: 전이중 방식으로 동시에 듣고 말하며, 감정과 의도를 이해하고 다국어 전환이 가능하며, 대화 중 도구를 호출해 작업을 수행할 수 있습니다.
03Qwen-Audio-3.1의 기술 원리
엔드투엔드 공동 모델링(ASR): Qwen-Audio-3.1-ASR은 엔드투엔드 방식을 채택해 화자 태그, 타임스탬프, 전사 텍스트를 함께 출력합니다. 기존 연결형 시스템의 단계별 처리와 달리 짧은 끼어들기와 겹치는 음성을 보존할 수 있습니다. 또한 모델에 불필요한 추임새 제거, 반복 제거, 자기 수정, 의미 재구성 기능이 내장되어 전사 결과를 회의록과 대화 분석에 바로 활용할 수 있습니다.
차세대 오디오 이해 아키텍처(ASR-Next): ASR-Next는 차세대 아키텍처를 기반으로 처리 대상을 ‘음성 속 텍스트’에서 전체 오디오 신호로 확장합니다. 음향 수준의 감정, 환경음, 기계음을 이해해 소리 이벤트의 위치 확인, 설명, 추론을 수행하며, ASR이 전사 도구에서 범용 오디오 이해 모델로 발전했음을 보여줍니다.
음색 전이 및 표현 제어(TTS): TTS 모델은 발음의 정확성만 추구하던 기존 합성 방식을 넘어, 동일한 음색으로 언어와 방언 간 자연스러운 전이를 실현합니다. 또한 명령을 통해 감정, 말하기 속도, 표현 방식을 모델링하여 합성 음성이 콘텐츠와 상황에 맞도록 합니다.
통합 오디오 생성(TTS-Next): TTS-Next는 텍스트, 타임스탬프, 참조 오디오의 세 가지 입력을 바탕으로 사람 목소리, 효과음, 환경음을 통합 생성합니다. 여러 차례의 대화에서도 각 역할의 음색과 감정을 일관되게 유지하며, 자연어로 생성 과정을 제어할 수 있습니다. 세밀한 타임스탬프 제어, 음성 복제, 48kHz 고음질 출력을 지원합니다.
다중 교사 증류 전이중 아키텍처(Realtime): Realtime은 다중 교사 증류 아키텍처를 사용해 낮은 지연 시간을 유지하면서 이해, 추론, 표현, 안전성을 향상합니다. 전이중 상호작용을 구현하여 말하기와 듣기가 동시에 이루어지고 언제든 끼어들어 중단할 수 있습니다. 모델은 도구 호출 기능을 통합해 지속적인 대화에서 변화하는 요구를 이해하고 외부 API, 지식 베이스, 비즈니스 시스템에 연결해 작업을 수행할 수 있습니다.
04Qwen-Audio-3.1 사용 방법
Qwen AI 플랫폼 열기: https://www.qianwenai.com/에 접속해 계정으로 로그인한 후 모델 광장으로 이동합니다.
필요한 모델 선택: 요구 사항에 따라 해당 모델인 ASR(전사), TTS(합성), TTS-Next(창작), Realtime(실시간 상호작용)을 선택하고 상세 페이지로 이동합니다.
API Key 발급: 콘솔에서 모델 서비스를 활성화하고 API Key를 생성해 인터페이스 인증에 사용합니다.
인터페이스 호출: 각 모델 상세 페이지의 API 문서를 참고하여 HTTP 요청으로 오디오 또는 텍스트 매개변수를 전달합니다(ASR-Next API는 아직 출시되지 않았으며 공개될 때까지 기다려야 합니다).
애플리케이션에 통합: 인터페이스를 자체 애플리케이션, Agent 또는 스마트 하드웨어에 연결하면 음성 작업을 온라인으로 수행할 수 있습니다.
05Qwen-Audio-3.1의 핵심 강점
뛰어난 다국어·방언 처리 능력: 하나의 모델로 30개 언어와 16개 중국어 방언을 지원하며, 원저우 방언과 같은 난해한 방언의 인식 성능이 특히 크게 향상되었습니다.
지능형 전사 다듬기: ASR이 추임새 제거, 반복 제거, 의미 재구성을 기본적으로 수행하여 더욱 매끄럽고 논리적인 구조화 텍스트를 출력합니다.
높은 정확도의 화자별 전사: 엔드투엔드 방식으로 화자 태그, 타임스탬프, 텍스트를 출력하며, Fun-ASR 연결형 시스템보다 전반적으로 우수합니다.
향상된 오디오 이해: ASR-Next는 감정, 환경음, 기계음을 이해하여 ‘텍스트 전사’에서 ‘전체 오디오 이해’로 도약합니다.
통합 창작 능력: TTS-Next는 사람 목소리, 효과음, 환경음을 한 번에 생성하고 여러 역할의 음색과 감정을 일관되게 유지하여 여러 담당자가 나누어 진행하던 후반 제작 과정을 대체합니다.
사람과 같은 실시간 상호작용: 전이중 듣기·말하기 병렬 처리와 끼어들기 중단을 지원하며, 감정을 감지하고 도구를 호출해 작업을 수행할 수 있습니다.
낮은 지연 시간과 높은 성능: 스트리밍 인식의 첫 글자 응답 시간은 약 160밀리초이며, Realtime은 다중 교사 증류를 기반으로 낮은 지연 시간과 추론 능력을 모두 확보했습니다.
06Qwen-Audio-3.1 프로젝트 주소
온라인 체험 데모: Qwen-Audio-3.1-ASR:https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS:https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next:https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime:https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07Qwen-Audio-3.1의 활용 시나리오
회의록 및 인터뷰 기록: ASR의 화자별 전사와 타임스탬프 기능을 사용해 ‘누가 언제 무엇을 말했는지’ 구조화된 기록을 자동으로 출력하고, 구어체 표현을 기본적으로 다듬어 제거하여 회의 효율을 크게 높입니다.
팟캐스트 및 오디오북 제작: TTS-Next를 통해 여러 사람의 대화, 효과음, 환경음으로 구성된 완전한 오디오를 한 번에 생성하며, 여러 역할의 음색과 감정을 일관되게 유지해 진행자, 음향 효과 담당자, 믹싱 담당자 간의 분업과 협업을 줄일 수 있습니다.
실시간 음성 고객센터·스마트 비서: Realtime의 전이중 상호작용과 감정 인식 기능을 기반으로 중단할 수 있고 공감 능력을 갖춘 음성 고객센터를 구축할 수 있으며, 대화 중 비즈니스 시스템을 호출해 조회, 주문 등의 작업도 수행할 수 있습니다.
해외여행 및 다국어 소통: 30개 언어의 실시간 전환과 동일한 음색의 언어 간 합성 기능을 활용해 여행 계획, 해외 전자상거래, 국제회의에 자연스럽고 원활한 음성 번역 및 소통 경험을 제공합니다.
AI 스마트 하드웨어: QwenNote, 통이첸원 AI 안경 등의 하드웨어와 결합하면 사용자가 컴퓨터나 휴대폰을 열지 않고도 음성으로 직접 작업을 시작하고 조건을 추가하며 실행 상황을 추적할 수 있어, 음성이 AI 하드웨어의 자연스러운 진입점이 됩니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0