
모든 AI 도구
AI 오디오 도구
AI 오디오 도구 분야의 인기 AI 스마트 제품을 살펴보고 있습니다. 매칭 최적화를 통해 맞춤 설계되어 업계에 뛰어난 솔루션을 제공합니다.
 R2T2AI 음성 인식R2T2는 넷이즈 유다오가 오픈 소스로 공개한 저지연 진정한 스트리밍 음성 인식 모델로, 정식 명칭은 Real Real-Time Transcription이며 Qwen3-ASR을 기반으로 구축되었습니다.00
 Spark-ASR-2.0AI 음성 인식Spark-ASR-2.0은 아이플라이텍이 음성 기반 대규모 모델 Spark-Audio를 기반으로 개발한 최신 세대 음성 인식 대규모 모델입니다. 모델은 '비자기회귀 + LLM 강화 자기회귀' 협력 아키텍처를 적용해 중국어·영어 혼합, 방언, 전문...00
 MusicBuddyAI 음악 제작MusicBuddy는 텐센트 뮤직이 출시한 AI 음악 창작 플랫폼으로, 음악인을 위한 전 과정 서비스를 제공합니다. MusicBuddy는 기존 DAW의 트랙별 편집 방식을 유지하고 왼쪽에 AI 대화 패널을 배치해 자연어로 편곡을 조정할 수 있습니다...00
 YuE2AI 음악 제작YuE2는 홍콩과학기술대학교와 M-A-P 팀이 오픈 소스로 공개한 음악 생성 모델입니다. 가사와 스타일을 바탕으로 편집 가능한 ABC 악보(멜로디+코드)를 생성한 후 48kHz 완성곡으로 렌더링하여, 창작 과정을 투명하고 제어 가능하게 만듭니다.00
 Xiaomi-CocktailASR-1AI 음성 인식Xiaomi-CocktailASR-1은 샤오미가 오픈 소스로 공개한 타깃 화자 음성 인식 대형 모델로, LLM 엔드투엔드 아키텍처를 기반으로 합니다. 참조 음성을 화자 음성 특징 프롬프트로 사용하며, 음성 분리 없이 여러 사람이 섞인 음성에서 타깃 화자의 발화를 정확하게 전사...00
 MAI-Transcribe-2AI 음성 인식MAI-Transcribe-2는 Microsoft가 출시한 최고 성능의 AI 음성-텍스트 변환 모델로, 정확도·속도·비용 모든 측면에서 앞서갑니다. 60개 언어를 지원하며 FLEURS 테스트 세트에서 평균 단어 오류율은 5.2%에 불과합니다.00
 音剪AI 오디오 도구音剪은 시마라야가 제공하는 올인원 AI 오디오 창작 플랫폼입니다. 팟캐스트 진행자, 오디오북 제작자 및 기타 오디오 콘텐츠 창작자를 대상으로 녹음, 편집, 문서 음성 변환, 오디오 콘텐츠 제작, 라이브 방송 지원 등의 기능을 제공하며, 노이즈 제거, 배경 음악, 자막 생성 등의 도구를 통해 오디오 콘텐츠 제작을 지원합니다.018.2
 Transync AIAI 오디오 도구Transync AI는 회의와 현장 소통을 위한 AI 오디오 도구로, 실시간 음성 인식과 번역을 통해 대화 내용을 양언어 병렬 자막으로 제공합니다. 사용 시 제품이 회의 발언을 직접 듣고 서로 다른 화자와 언어를 식별한 뒤 번역 결과를 동시에 출력하며, 음성 안내로 의사소통을 지원할 수도 있습니다. 회의 후에는 회의록과 요약도 생성할 수 있습니다. 해외 영업, 다국적 팀, 국경을 넘나드는 프리랜서, 유학 및 출장 중 의사소통이 필요한 사용자에게 적합합니다. 60개 언어를 지원하며 Zoom, Microsoft Teams, Google Meet 등의 회의 환경에서 사용할 수 있습니다. Premium 요금제는 월 10시간의 양방향 실시간 번역을 제공하므로, 구체적인 사용량과 결제 조건은 사용 전에 확인해야 합니다.077.6
 爱声音坊 AiSoundsAI 오디오 도구爱声音坊 AiSounds는 콘텐츠 크리에이터를 위한 인공지능 오디오 도구로, 숏폼 동영상, 게임, 팟캐스트, 1인 미디어 및 콘텐츠 팀 등 다양한场景을 지원합니다. 사용자는 동영상을 업로드해 화면에 어울리는 배경 음악을 생성할 수 있으며, 중국어 설명을 입력해 음향 효과와 음악을 생성하거나 원고를 내레이션, 음성 콘텐츠 및 캐릭터 음성으로 변환할 수도 있습니다. 또한 자막 출력, 온라인 오디오 편집 및 편집 소프트웨어 연동을 제공해 후반 제작 과정에 음원 소재를 편리하게 연결할 수 있습니다. 지속적으로 동영상, 강의, 팟캐스트 및 소셜 미디어 콘텐츠를 제작하는 사용자에게 적합하며, 소재 검색과 오디오 처리 사이의 도구 전환을 줄여줍니다. 생성된 콘텐츠는 화면, 원고 및 완성본의 효과를 바탕으로 직접 검토하고 조정해야 합니다.098
 쉰페이즈오쭤AI 오디오 도구쉰페이즈오쭤는 아이플라이텍이 출시한 AI 오디오 및 동영상 제작 플랫폼으로, 숏폼 동영상 크리에이터, 기업 홍보 담당자, 교육 종사자 및 미디어 업계 종사자를 대상으로 합니다. 사용자는 텍스트나 녹음을 입력하고 가상 앵커 이미지를 선택해 구술 동영상을 제작할 수 있으며, 텍스트 음성 변환, PPT 동영상 변환 및 기타 AIGC 창작 도구도 사용할 수 있습니다. 플랫폼은 중국어와 영어 더빙을 지원하며, 말하기 속도와 억양 등의 설정을 제공합니다. 제품은 무료와 유료 서비스를 병행하는 방식으로 운영됩니다. 생성 결과는 문안, 음성 및 이미지 선택에 따라 달라질 수 있으므로, 정식 공개 전에 발음, 화면 및 콘텐츠의 정확성을 확인해야 합니다.038.6
 NoizAI 오디오 도구Noiz는 음성 복제, 음성 생성 및 다국어 더빙에 주로 사용되는 AI 오디오 도구입니다. 사용자는 오디오 샘플을 업로드해 해당 음성 모델을 생성한 다음 텍스트를 음성으로 변환할 수 있으며, 노래 음성 합성, 감정 표현 및 동영상 립싱크에도 활용할 수 있습니다. 동영상 크리에이터, 해외 진출 콘텐츠 팀, 오디오북 제작자 및 인디 게임 개발자가 내레이션, 다국어 버전, 캐릭터 대사 등의 콘텐츠를 제작하는 데 적합합니다. 플랫폼은 무료 및 유료 방식을 제공하며, 구체적인 이용 범위는 다를 수 있습니다. 생성 결과는 오디오 샘플의 품질, 텍스트 맥락 및 감정 설정에 따라 달라지므로 정식 공개 전 음성, 번역 및 음향과 영상의 일치 여부를 직접 확인해야 합니다.087.7
 TTS-텍스트 음성 변환AI 오디오 도구TTS-텍스트 음성 변환은 입력한 텍스트를 내보낼 수 있는 음성 파일로 변환하는 온라인 AI 오디오 도구입니다. Microsoft Azure 음성 합성 기술을 기반으로 중국어 표준어, 일부 방언 및 다양한 외국어를 지원하며, 음성 캐릭터, 감정 모드, 쉼 및 다중 발음 한자 등의 설정을 제공합니다. 사용자는 웹페이지에서 텍스트를 입력하거나 정리한 뒤 필요에 따라 음성 매개변수를 조정하여 MP3 또는 WAV 오디오를 생성할 수 있습니다. 영화·영상 해설, 숏폼 동영상 더빙, 외국어 학습 및 긴 텍스트 낭독 등의 용도에 적합합니다. 방언, 고유명사 또는 복잡한 감정 표현이 포함된 경우 생성 결과를 직접 들어 보고 수동으로 교정해야 합니다.087.3
 SpeechifyAI 오디오 도구Speechify는 음성을 중심으로 한 읽기 및 생산성 도구로, PDF, 문서, 웹페이지 등의 텍스트를 음성으로 변환하고 음성 입력, 콘텐츠 질의응답, 요약 및 팟캐스트 생성도 지원합니다. 웹 버전, 브라우저 확장 프로그램과 Windows, macOS, iOS, Android 앱을 제공하여 사용자가 듣고 말하는 방식으로 읽기, 쓰기 및 정보 이해 작업을 처리할 수 있도록 돕습니다.017.9
 PersonaTalkAI 오디오 도구PersonaTalk는 영상 립싱크를 위한 AI 시각 더빙 프레임워크입니다. 사용자는 인물이 등장하는 영상과 대상 오디오를 제공하고, 시스템은 새 오디오에 맞는 립싱크 영상을 생성하면서 원래 인물의 얼굴 스타일과 말하는 특징을 최대한 유지합니다. 이중 어텐션 얼굴 렌더링 메커니즘은 입술과 기타 얼굴 영역을 각각 처리하여 피부 질감과 화장 등의 화면 세부 정보를 보존하고 치아 깜빡임 현상을 줄일 수 있습니다. 이 도구는 영상 번역·더빙, 광고 현지화, 온라인 교육 및 디지털 휴먼 개발에 적합합니다. 자료에는 구체적인 배포 방식, 하드웨어 요구 사항 및 출력 제한이 명시되어 있지 않으므로, 실제 사용 전 프로젝트 문서를 바탕으로 소재와 실행 조건을 평가해야 합니다.038.2
 DupDubAI 오디오 도구DupDub은 콘텐츠 크리에이터를 위한 AI 오디오 도구로, 주로 텍스트를 음성으로 변환하고 음성 복제, 가상 인물 나레이션, 동영상 번역 및 자막 편집을 지원합니다. 사용자는 플랫폼에서 원고를 입력하거나 정리하고, 음성과 캐릭터를 선택한 다음 말하기 속도, 음높이, 멈춤 및 감정을 조정하여 오디오를 내보내거나 관련 동영상 콘텐츠를 제작할 수 있습니다. 동영상 크리에이터, 팟캐스트 및 오디오북 제작자, 마케팅 담당자, 교육 강사와 기업의 해외 진출 팀에 적합합니다. 플랫폼은 다중 캐릭터 더빙, 다국어 지원 및 오디오 편집 기능을 제공하지만, 음성의 감정 표현, 번역 내용 및 가상 인물의 입 모양과 같은 결과는 게시 전에 직접 확인해야 합니다.017.8
 Supertone PlayAI 오디오 도구Supertone Play는 음성 창작을 위한 AI 오디오 도구로, 음성 복제, 텍스트 음성 변환 및 캐릭터 음성 라이브러리를 제공합니다. 콘텐츠 크리에이터, 게임 및 애니메이션 제작자, 광고·마케팅 담당자, 음악가에게 적합합니다. 사용자는 약 10초 동안 자신의 목소리를 녹음해 음성 모델을 생성한 뒤, 텍스트를 입력해 음성으로 변환하고 음높이, 말하기 속도, 감정 등의 매개변수를 조절할 수 있습니다. 플랫폼은 영어, 한국어, 일본어를 지원하며 무료 및 유료 요금제를 제공합니다. 실제 사용 시 음성 품질은 녹음 상태, 텍스트 내용 및 매개변수 설정의 영향을 받을 수 있으며, 다국어 출력도 항목별로 직접 들어 보고 교정해야 합니다.038.2
 Fish AudioAI 오디오 도구Fish Audio는 텍스트 음성 변환과 음성 복제를 주로 지원하는 AI 오디오 도구입니다. 사용자는 짧은 오디오 샘플을 제출해 디지털 음성 모델을 만든 다음 텍스트를 음성으로 변환할 수 있습니다. 플랫폼은 실시간 음성 합성 API, 커뮤니티 음성 라이브러리, 감정·말하기 속도·음높이·볼륨 조절 기능도 제공합니다. 콘텐츠 크리에이터가 내레이션, 오디오 콘텐츠, 동영상 더빙을 제작하는 데 적합하며, 기업·개발자·교육자는 음성 애플리케이션이나 강의 오디오를 제작할 수 있습니다. 플랫폼은 무료 및 유료 요금제를 함께 제공합니다. 실제 생성 결과는 샘플의 선명도, 텍스트 표현, 사용 환경에 따라 달라질 수 있으며, 타인의 목소리를 사용하기 전에는 해당 사용 권한의 범위를 확인해야 합니다.038.6
 Mubert AIAI 오디오 도구Mubert AI는 텍스트 프롬프트, 감정, 스타일, 상황 또는 길이를 바탕으로 배경 음악을 생성하는 데 주로 사용되는 AI 오디오 도구입니다. 콘텐츠 크리에이터는 동영상과 팟캐스트 등의 작품에 활용할 수 있으며, 개발자와 브랜드는 API를 통해 동적인 배경 음악을 구현할 수 있습니다. 음악가는 Mubert Studio에 음악 소재를 업로드할 수 있습니다. 또한 Adobe Premiere Pro, Adobe After Effects 등의 소프트웨어에 사용할 수 있는 플러그인을 제공해 일부 창작 작업 흐름을 지원합니다. 사용 시 프로젝트 요구 사항에 맞게 프롬프트와 길이를 조정해야 하며, 구체적인 라이선스 범위는 선택한 요금제와 게시 상황을 함께 확인해야 합니다.038.1
 Copilot LabsAI 오디오 도구Copilot Labs는 Microsoft AI의 실험 플랫폼입니다. Audio Expression 프로젝트는 음성 콘텐츠를 제작하는 크리에이터와 전문가를 대상으로 하며, MAI-Voice-1과 같은 모델을 사용해 텍스트를 자연스러운 음성으로 변환합니다. 텍스트를 입력한 후 감정, 스토리, 스크립트 모드 중 하나를 선택하고 다양한 음성 스타일로 오디오를 생성할 수 있습니다. 감정 모드와 스토리 모드에서는 AI가 콘텐츠를 다듬거나 재구성하거나 창의적으로 표현할 수 있으며, 스크립트 모드는 원문에 따라 읽는 데 더 중점을 둡니다. 생성된 결과는 MP3로 다운로드할 수 있으며, 현재 자료에 따르면 로그인 없이도 다운로드할 수 있습니다. 단, 창의적 모드에서는 원문의 표현이 달라질 수 있으므로 정식 공개 전에 내용과 어조가 스크립트 요구 사항에 부합하는지 확인해야 합니다.028.2
 ElevenLabsAI 오디오 도구ElevenLabs는 주로 텍스트를 음성으로 변환하고, 음성 복제, 동영상 또는 오디오 더빙 번역, 음성 디자인 및 AI 음성 에이전트 등의 기능을 제공하는 AI 오디오 도구입니다. 사용자는 플랫폼에 텍스트를 입력하거나 오디오 샘플을 업로드하고 기존 미디어를 처리한 뒤 음성 콘텐츠를 내보낼 수 있으며, API를 통해 음성 기능을 자체 애플리케이션에 연동할 수도 있습니다. 동영상 제작자, 팟캐스트 및 오디오북 제작자, 게임 및 애니메이션 팀, 교육·훈련 담당자, 음성 인터랙션 기능이 필요한 개발자와 기업에 적합합니다. 플랫폼은 무료 및 유료 요금제를 함께 제공합니다. 음성 복제나 더빙 기능을 사용할 때는 오디오 샘플, 인물의 목소리 및 관련 콘텐츠에 대한 사용 권한을 먼저 확인하고, 생성 결과를 사람이 검수해야 합니다.048.2
 SongSens.aiAI 오디오 도구SongSens.ai는 외국어 노래 학습을 위해 설계된 AI 오디오 도구로, 주로 외국어 학습자를 대상으로 하며 음악 평론가, 문화 연구자, 커버곡 제작자에게도 적합합니다. 사용자는 노래나 가사를 바탕으로 맥락 분석, 단어별 풀이, 발음 가이드, 기억력 테스트를 확인하고, 플레이어로 가사를 들으며 이해할 수 있습니다. 노래를 언어 입력 자료로 활용해 사용자가 구체적인 맥락 속에서 어휘, 표현, 문화 정보를 접하도록 돕습니다. 기존 자료에는 Apple Music 등의 플레이어와 연결할 수 있다고 언급되어 있지만, 전체 지원 범위, 지원 언어 수 또는 구체적인 요금 규정은 설명되어 있지 않습니다. 가사에 담긴 은유, 방언, 문화적 배경은 사용자가 원문과 다른 자료를 함께 확인해야 할 수 있습니다.047.8
 음술AIAI 오디오 도구음술AI는 중국어 사용자를 위한 AI 음악 창작 및 공유 플랫폼으로, 텍스트 영감과 가사 생성부터 노래 출력 및 커뮤니티 게시까지의 과정을 지원합니다. 사용자는 텍스트 설명으로 주제와 스타일을 설정한 다음 보컬 톤을 선택해 멜로디, 편곡, 보컬이 포함된 완성곡을 생성할 수 있으며, 추가 작업이 필요할 때는 Stem 분리 트랙을 내보내 믹싱할 수 있습니다. 음악 창작자, 숏폼 동영상 및 팟캐스트 음악 제작자, 브랜드와 사운드 애호가를 대상으로 하며, 음악 이론 지식은 부족하지만 감정을 표현하고 싶은 사람에게도 적합합니다. 플랫폼은 무료 및 유료 이용 방식을 함께 제공합니다. 다만 생성 결과, 이용 허가 범위 및 저작권 증빙의 실제 효력은 플랫폼 규정과 구체적인 이용 상황을 기준으로 판단해야 합니다.068.4
 WhisperAI 오디오 도구Whisper는 OpenAI가 출시한 자동 음성 인식 시스템으로, 오디오를 텍스트로 변환하고 음성을 번역하며 콘텐츠를 정리하는 데 사용됩니다. 사용자는 오디오를 시스템에 입력해 해당 텍스트 기록을 얻고, 단어나 문장 단위로 타임스탬프를 확인할 수 있습니다. 일부 비영어 음성은 영어 텍스트로 바로 번역할 수도 있습니다. 다양한 언어와 작업을 포함한 68만 시간의 지도 데이터로 학습되었으며, 모델과 코드가 공개되어 개발자 통합, 연구자 테스트는 물론 인터뷰, 팟캐스트, 회의, 강의 및 동영상 콘텐츠 정리에도 적합합니다. 인식 결과는 녹음 품질, 억양 및 전문 용어를 고려해 사람이 다시 검토해야 합니다.028.4
 FineVoiceAI 오디오 도구FineVoice는 텍스트 음성 변환, 음성 복제, 실시간 음성 변조, 음성 텍스트 변환, AI 음향 효과 생성 등의 기능을 한곳에 모은 AI 오디오 제작 플랫폼입니다. 사용자는 텍스트나 오디오 소재에서 시작해 음성을 선택하거나 설계하고, 말하기 속도와 감정 등의 매개변수를 조정한 다음 결과물을 동영상, 팟캐스트, 강의, 게임 및 마케팅 콘텐츠에 활용할 수 있습니다. 플랫폼 자료에 따르면 여러 언어와 억양을 지원하며 무료 및 유료 요금제를 제공합니다. 더빙, 전사 또는 음향 효과 소재가 필요한 개인 크리에이터, 교육팀, 게임 및 애니메이션 개발자, 기업에 적합합니다. 실제 결과는 텍스트 표현, 언어 지원 여부 및 입력 오디오 품질의 영향을 받으며, 음성 복제는 먼저 관련 사용 권한을 확인해야 합니다.098.4
 음충AI 오디오 도구음충은 중국 내 사용자를 위한 중국어 AI 오디오 도구로, 음악 제작과 편곡의 진입 장벽을 낮추는 데 초점을 둡니다. 사용자는 소프트웨어에 내장된 가상 악기와 이펙터를 사용하고, 멜로디를 입력한 뒤 AI로 반주를 생성할 수 있으며, VST 및 VST3 플러그인으로 제작 기능을 확장할 수도 있습니다. 전체 중국어 인터페이스는 음악 초보자, 취미 사용자, 학교 교사와 학생, 가정 녹음 사용자에게 적합하며 수업 연습, 음악 과제, 커버곡 녹음 또는 간단한 데모 제작에 활용할 수 있습니다. 고급 사용자를 위한 플러그인 확장성도 제공하지만, AI가 생성한 반주는 수동 조정이 필요할 수 있고 실제 결과는 입력한 멜로디와 이후 편곡에 따라 달라집니다.067.7
 BeepThatOutAI 오디오 도구BeepThatOut은 콘텐츠 제작자를 위한 AI 오디오 도구로, 오디오·비디오에서 욕설이나 기타 차단이 필요한 단어를 스캔하고 사용자 설정에 따라 음소거 효과를 추가합니다. 파일을 업로드한 후 대화형 텍스트 기록에서 단어를 찾고, 차단 범위와 음향 효과를 선택한 다음 처리 결과를 내보낼 수 있습니다. SRT 자막 생성과 Adobe Premiere Pro, Final Cut Pro 및 DaVinci Resolve 프로젝트 파일로의 내보내기도 지원합니다. YouTube 제작자, 팟캐스터, 편집자, 마케팅 팀 및 교육자에게 적합합니다. 자동 식별 결과는 특히 고유명사, 문맥 및 경계선상의 표현에 대해 반드시 사람이 검토해야 합니다.038.1
 Sounder AIAI 오디오 도구Sounder AI는 팟캐스트와 같은 장시간 오디오 콘텐츠를 위한 지능형 분석 플랫폼입니다. 머신러닝과 자연어 처리를 결합해 오디오를 구조화된 텍스트로 변환하고, 그 안의 주제와 맥락을 식별합니다. 사용자는 먼저 오디오를 가져오거나 처리한 후 전사, 콘텐츠 분석, 브랜드 안전성 검증 및 오디언스 데이터를 활용해 콘텐츠를 관리하거나 광고를 타기팅할 수 있습니다. 팟캐스트 제작자, 광고 대행사, 오디오 퍼블리셔 및 브랜드가 주요 대상이며, 프로그램 콘텐츠 정리, 광고 게재 환경 평가 및 수익화 기회 탐색에 활용할 수 있습니다. 플랫폼은 무료 및 유료 요금제를 제공합니다. 오디오 전사와 민감한 콘텐츠 식별 결과는 여전히 사람의 검토와 함께 활용해야 하며, 완전한 콘텐츠 검수 절차를 대신할 수 없습니다.067.8
 PlaudAI 오디오 도구Plaud는 녹음 하드웨어와 인공지능 처리 기능을 결합한 오디오 도구로, 회의, 인터뷰, 통화 및 음성 메모를 정리하는 데 주로 사용됩니다. 사용자는 카드형 또는 클립형 하드웨어로 오디오를 녹음하고, 앱에서 텍스트와 이미지를 추가할 수도 있습니다. 녹음 파일을 업로드하면 시스템이 텍스트 기록, 요약, 핵심 요점과 마인드맵을 생성하며, 녹음 내용에 대해 질문할 수도 있습니다. 음성 정보를 지속적으로 처리해야 하는 직장인, 영업 담당자, 교육 종사자, 기자와 콘텐츠 제작자에게 적합합니다. 제품은 무료 요금제와 유료 요금제를 제공합니다. 다만 전사와 요약 결과는 녹음 품질, 주변 소음, 여러 사람의 동시 발화에 영향을 받을 수 있으므로 중요한 내용은 사용 전에 원문과 대조해야 합니다.038.1
 WellSaidAI 오디오 도구WellSaid는 기업 팀을 위한 AI 오디오 도구로, 주로 텍스트 스크립트를 보이스오버로 변환하는 데 사용됩니다. 120가지가 넘는 AI 음성을 제공하며, 전문 성우의 라이선스 녹음으로 제작된 음성 모델을 기반으로 합니다. 교육, 마케팅, 광고, 제품 개발 등 콘텐츠 제작 과정에 적합합니다. 사용자는 음성을 선택하고 발음을 조정할 수 있으며, 발음 사전을 통해 브랜드명, 전문 용어, 약어를 관리할 수 있습니다. 팀은 공유 공간에서 프로젝트와 음성 리소스를 관리할 수도 있습니다. WellSaid는 API를 제공하며 Adobe Premiere Pro와 같은 소프트웨어에서도 사용할 수 있습니다. 실제 사용 시 복잡한 용어, 말투, 문맥은 여전히 직접 들어 보고 교정해야 합니다.038.1
 SpotScribeAI 오디오 도구SpotScribe는 팟캐스트 전사를 중심으로 하는 음성 텍스트 변환 도구로, Spotify, Apple Podcasts, YouTube, TikTok 링크와 로컬 오디오·비디오 파일 업로드를 지원합니다. 사용자는 링크를 붙여 넣거나 자료를 업로드한 후 전체 전사본과 AI 요약을 확인하고, 에피소드 내용을 바탕으로 질문할 수 있습니다. 결과는 복사할 수 있으며 PDF, DOCX, SRT, TXT로 내보낼 수 있어 노트 작성, 자막 제작, 편집, 글 작성 및 자료 보관에 편리합니다. 콘텐츠 제작자, 팟캐스트 운영자, 연구자와 학습자가 인터뷰, 강의, 프로그램 및 숏폼 영상 자료를 처리하는 데 적합합니다. AI 요약, 질의응답 및 전사 결과는 공식 게시나 연구 인용에 사용하기 전에 원본 오디오와 함께 직접 확인하는 것이 좋습니다.077.8
 CleanvoiceAI 오디오 도구Cleanvoice는 팟캐스트와 오디오 크리에이터를 위한 AI 오디오 정리 도구로, 녹음에 포함된 필러 단어, 배경 소음, 지나치게 긴 멈춤, 입안 소리와 호흡음을 처리하는 데 주로 사용됩니다. 녹음 파일을 업로드하면 자동화된 과정을 통해 1차 정리를 수행할 수 있으며, 여러 게스트의 개별 트랙도 처리할 수 있습니다. 또한 팟캐스트 요약, 챕터 노트와 소셜 미디어 홍보 문구 생성을 지원합니다. 팟캐스트, 오디오북, 동영상, 강의 및 회의 녹음 등 다양한 상황에 적합하며, 오디오 엔지니어의 1차 러프 컷 도구로도 활용할 수 있습니다. 자동 인식 및 삭제 과정에서 말투, 멈춤 또는 내용 전달 방식이 달라질 수 있으므로 정식 공개 전에는 수동 검토가 필요합니다.038.6
 Amadeus CodeAI 오디오 도구Amadeus Code는 음악 창작자를 위한 AI 작곡 도구로, 주로 멜로디 영감과 곡 초안을 생성하는 데 사용됩니다. 사용자는 스타일, 리듬, 분위기 또는 코드에 따라 조건을 선택하고, 시스템이 새로운 톱라인 멜로디를 생성하도록 한 뒤 다양한 결과를 반복해서 선별할 수 있습니다. 생성된 콘텐츠는 MIDI 파일로 내보낼 수 있어 디지털 오디오 워크스테이션(DAW)에서 편곡과 수정 작업을 이어갈 수 있습니다. 작사가·작곡가, 인디 음악가, 동영상 콘텐츠 제작자, AI 작곡을 시도해 보고 싶은 음악 애호가에게 적합하며, 창작의 막힘을 해소하고 곡의 뼈대를 구성하거나 초기 아이디어를 기록하는 데 활용할 수 있습니다. 다만 이 도구는 멜로디 보조와 초안 생성에 더 중점을 두며, 한 번에 곡 전체를 완성하는 도구는 아니므로 이후에 수동 편집과 제작이 필요합니다.038.5
 Musicfy AIAI 오디오 도구Musicfy AI는 음악 창작과 오디오 콘텐츠 제작을 위한 AI 오디오 도구입니다. 사용자는 음성 샘플을 업로드해 개인 AI 음성 모델을 만들고, 이를 음성 변환과 노래 커버에 활용할 수 있습니다. 또한 텍스트나 감정 설명을 통해 멜로디와 반주가 포함된 음악을 생성하고, 보컬 허밍을 악기 소리로 변환할 수도 있습니다. 플랫폼은 AI 가수 라이브러리와 소재 라이브러리도 제공하므로 음악 프로듀서, 콘텐츠 크리에이터, 소셜 미디어 사용자, 음악 창작을 시도하려는 일반 사용자에게 적합합니다. 영감에서 오디오 초안까지의 과정을 간소화할 수 있지만, 타인의 목소리를 사용하거나 생성 콘텐츠를 게시하기 전에는 관련 권한과 플랫폼 규정을 직접 확인해야 합니다.018.4
 JoyCastAI 오디오 도구JoyCast는 MacBook용 AI 오디오 향상 도구로, 주로 내장 마이크의 음성 수음을 개선하는 데 사용됩니다. 사용 시 시스템 오디오 입력으로 작동하며, 먼저 마이크 음성을 노이즈 제거한 후 화상 회의, 라이브 스트리밍 또는 녹음 소프트웨어에서 사용할 수 있도록 제공합니다. 자료에는 Zoom, Google Meet, Slack, OBS 등의 사용 사례가 제시되어 있으며, 원격으로 자주 소통하는 창업자, 콘텐츠 제작자 및 온라인 교육 종사자에게 적합합니다. 제품 설명에 따르면 오디오 처리는 로컬에서 수행되며 Apple Silicon 칩을 지원합니다. 다만 현재 자료는 주로 MacBook 내장 마이크를 중심으로 설명하고 있어 Windows, 외장 마이크 또는 기타 기기의 호환 범위는 명시되어 있지 않습니다. 구체적인 노이즈 제거 효과 역시 주변 환경과 수음 조건에 따라 달라질 수 있습니다.017.3
 MurfAI 오디오 도구Murf는 텍스트 스크립트를 음성으로 변환하고 동영상, 프레젠테이션 등의 콘텐츠에 더빙을 추가할 수 있는 AI 오디오 제작 플랫폼입니다. 플랫폼에서 음성을 선택하고 말하기 속도와 일시 정지를 조정한 뒤, 오디오와 영상의 동기화 및 배경 음악을 결합해 콘텐츠를 완성할 수 있습니다. 또한 음성 복제, 음성 변환, 번역 더빙 및 API 기능도 제공합니다. 기업의 마케팅·교육 팀, 콘텐츠 크리에이터, 교육자, 음성 인터랙션 기능이 필요한 개발자에게 적합합니다. Murf는 무료 및 유료 이용 방식을 제공하지만, 구체적인 사용량, 음성 품질 및 기능 이용 권한은 현재 요금제에 따라 달라질 수 있으며 생성된 콘텐츠는 여전히 사람의 검토를 권장합니다.038.5
 AI-songAI 오디오 도구AI-song은 짧은 설명, 가사 또는 기악곡 창작 의도를 노래로 변환하는 데 주로 사용되는 AI 오디오 도구입니다. 사용자는 텍스트나 가사를 입력한 후 팝, 록, 클래식, 일렉트로닉 등의 스타일을 선택하여 최대 약 3분 길이의 완성된 오디오를 생성하고 MP3 형식으로 내보낼 수 있습니다. 음악 이론이나 편곡 경험이 없는 숏폼 동영상 제작자, 인디 게임 개발자, 팟캐스트 제작자 및 음악 애호가가 배경 음악, 오프닝과 엔딩 음악 또는 개인 작품을 제작하는 데 적합합니다. 생성 속도와 결과물의 품질은 입력 내용과 스타일 설정에 따라 달라질 수 있으므로, 정식 프로젝트에 사용하기 전에는 반드시 미리 듣고 조정하며 현재 이용 허가 조건을 확인해야 합니다.047.4MusicLMAI 오디오 도구MusicLM은 음악 생성을 위한 인공지능 모델로, 주로 텍스트 설명을 바탕으로 장면, 분위기와 스타일에 맞는 음악을 생성하며 허밍, 휘파람 또는 연주한 멜로디를 바탕으로 스타일을 바꿔 재편곡할 수도 있습니다. 사용자는 먼저 음악의 주제, 편곡 방식 또는 시간에 따른 변화 요구 사항을 입력한 뒤 해당 오디오 초안을 받아 창작 구상, 배경음악 시안 제작 및 연구 테스트에 활용할 수 있습니다. 공개 자료에서는 스토리 모드, 장시간 생성 및 MusicCaps 데이터셋도 소개합니다. 실제 사용 시 생성 결과의 세부 표현, 구조와 활용 가능성은 여전히 사람이 선별해야 하며, 소재의 라이선스와 상업적 사용 범위도 별도로 확인해야 합니다.028
 SpotiguessAI 오디오 도구Spotiguess는 Spotify를 기반으로 한 개인 맞춤형 노래 맞히기 퀴즈 플랫폼으로, 음악 기억력을 확인하거나 음악 활동을 구성하거나 특정 아티스트를 중심으로 도전하고 싶은 사용자를 위한 서비스입니다. 사용자는 아티스트, 플레이리스트 또는 저장한 곡을 문제 출처로 선택할 수 있으며, AI 모드에서 주제에 따라 콘텐츠를 생성할 수도 있습니다. 이후 자동 또는 수동 답변 방식을 선택할 수 있고, 여러 명이 대결하는 방식도 제공합니다. Spotify 사용자의 개인 플레이뿐 아니라 친구 모임과 음악 학습 중 복습 활동에도 적합합니다. 실제 이용 경험은 이용 가능한 Spotify 데이터와 개인 청취 기록에 따라 달라지며, 문제가 취향에 얼마나 잘 맞는지는 계정 콘텐츠에 따라 달라질 수 있습니다.087.6
 Exemplary AIAI 오디오 도구Exemplary AI는 콘텐츠 크리에이터를 위한 AI 오디오 도구이며, 비디오 콘텐츠 처리도 지원합니다. 사용자가 오디오나 비디오를 업로드하면 먼저 전사 텍스트와 자막을 생성한 뒤, 텍스트를 바탕으로 요약, 블로그 게시물, 챕터 콘텐츠 및 소셜 미디어 게시물을 만들고 긴 영상에서 짧은 영상 클립을 정리할 수 있습니다. 또한 120개 이상의 언어로 자막을 번역하고, 텍스트 기반 비디오 편집과 전사 내용에 대한 AI 대화를 지원합니다. 팟캐스트 및 비디오 크리에이터, 기자, 마케팅 담당자와 교육·훈련 기관이 녹음·촬영 자료를 게시용 콘텐츠로 전환하는 과정에서 반복적인 정리 작업을 줄이는 데 적합합니다. 전사, 번역 및 자동 생성 결과는 여전히 사람의 검수가 필요하며, 특히 전문 용어, 고유명사와 문맥에 따른 표현을 반드시 확인해야 합니다.038.9
 행자AIAI 오디오 도구행자AI는 게임 및 엔터테인먼트 업계를 위한 AI 오디오 도구로, 콘텐츠 제작과 관련된 종합 기능도 제공합니다. 사용자는 작사, 작곡, 보컬 합성, 배경 음악 제작을 중심으로 창작할 수 있으며, 플랫폼의 이미지 생성, AI 에이전트 및 콘텐츠 보안 기능을 함께 활용해 일부 게임 및 엔터테인먼트 콘텐츠 제작 과정을 완성할 수 있습니다. 이 제품은 게임 개발팀, 음악 교육 종사자, 독립 창작자 및 엔터테인먼트 운영 담당자에게 적합하며, 음악 제작, 교육 보조 및 홍보 자료 준비 등의 분야를 지원합니다. 플랫폼은 무료 및 유료 모델을 함께 제공하며, 실제 이용 가능한 기능은 버전이나 서비스 범위에 따라 달라질 수 있습니다. AI 생성 콘텐츠는 여전히 사람이 검토해야 하며, 실제 공개 요건에 따라 규정 준수 및 저작권 확인을 완료해야 합니다.087.8
 boomyAI 오디오 도구boomy는 무료 및 유료 요금제를 제공하는 AI 음악 생성 도구로, 음악 이론 지식이 없는 일반 사용자, 콘텐츠 크리에이터, 인디 음악가 및 게임 개발자를 대상으로 합니다. 사용자는 먼저 음악 스타일을 선택하고 시스템이 생성한 곡을 드럼 비트, 베이스, 멜로디, 리듬 및 구조에 맞게 조정할 수 있으며, 직접 녹음하거나 업로드한 보컬을 추가할 수도 있습니다. 완성된 작품은 플랫폼을 통해 Spotify, Apple Music 등의 스트리밍 플랫폼으로 배포할 수 있습니다. 빠른 배경 음악 제작, 아이디어 초안 또는 개인 싱글 제작에 적합하지만, 생성 결과는 여전히 직접 들어 보고 편집해야 하며, 구체적인 배포 자격, 라이선스 범위 및 수익 규정은 관련 플랫폼과 서비스 약관을 기준으로 확인해야 합니다.027.4
 VideoSDKAI 오디오 도구VideoSDK는 개발자를 위한 실시간 오디오·비디오 및 AI 음성 통신 인프라로, 크로스 플랫폼 SDK와 REST API를 제공합니다. 이를 통해 팀은 웹사이트, 모바일 애플리케이션 또는 기타 소프트웨어 제품에 영상 통화, 음성 통화, 인터랙티브 라이브 스트리밍, 실시간 전사, 녹화 및 AI 음성 에이전트를 통합할 수 있습니다. JavaScript, React, React Native, Android, iOS, Flutter, Unity, Python 등 다양한 개발 환경을 지원하며 SIP 전화 시스템에도 연결할 수 있습니다. 온라인 교육, 원격 의료, 영상 본인 인증, 라이브 커머스, 가상 이벤트 및 음성 고객 상담 등의 시나리오에 적합합니다. 사용자는 개발 역량을 갖춰야 하며, 실제 기능 구현을 위해서는 비즈니스 프로세스, 권한 및 최종 사용자 경험을 직접 설계하고 처리해야 합니다.047.9
 Mix AudioAI 오디오 도구Mix Audio는 음악 창작자, 팟캐스터, 오디오 초보자 및 교육자를 위한 AI 오디오 도구로, 자동 믹싱, 오디오 편집 및 음악 생성 기능을 제공합니다. 사용자는 텍스트, 이미지, 오디오 등의 자료를 가져오거나 입력하고, AI를 사용해 볼륨, 이퀄라이저, 다이내믹 컴프레서 및 효과를 조정할 수 있습니다. 또한 배경 음악이나 리믹스 작품을 생성한 뒤 프리셋으로 추가 처리할 수도 있습니다. 이 도구는 여러 사용자의 온라인 협업도 지원하여 개인 창작, 콘텐츠 제작 및 오디오 교육에 적합합니다. 무료 및 유료 요금제가 모두 제공되지만, 자동 처리 결과는 사용한 자료에 따라 직접 들어 보고 조정해야 합니다.038.5
 DeepBeatAI 오디오 도구DeepBeat는 랩 창작을 위한 AI 오디오 도구로, 핀란드 연구자들의 학술 프로젝트에서 시작되었으며 주로 머신러닝을 통해 가사를 생성하고 운율을 제안합니다. 사용자는 키워드를 입력해 한 번에 전체 구절을 생성할 수 있고, 한 줄씩 다음 문장이나 운율이 맞는 문장 제안을 받을 수도 있습니다. 사용 가능한 경우 딥러닝 모드를 활성화해 가사의 논리성과 스토리텔링을 개선할 수 있습니다. 랩 애호가, 창작자, 음악 프로듀서, 운문 영감이 필요한 작가에게 적합합니다. 이 도구는 현재 무료로 제공되지만, 생성된 내용은 주제, 리듬, 개인적인 표현에 맞춰 직접 수정해야 하며 최종 가사로 그대로 사용해서는 안 됩니다.028.5
 ecrett musicAI 오디오 도구ecrett music은 콘텐츠 크리에이터를 위한 AI 오디오 도구로, 동영상, 게임, 팟캐스트, 광고 및 독립 영상 프로젝트에 사용할 수 있는 배경 음악을 생성하는 것이 핵심 기능입니다. 사용자는 먼저 장면, 감정, 음악 장르를 선택하고 시스템이 멜로디를 생성하도록 합니다. 이후 악기와 음악 구조를 조정하고, 동영상을 업로드해 음악과 화면의 조화를 미리 확인한 다음 WAV 오디오를 다운로드할 수 있습니다. 작곡 기술이 없지만 비교적 빠르게 배경 음악 초안을 완성해야 하는 개인 크리에이터와 소규모 팀에 적합하며, 자료 정리를 돕는 즐겨찾기와 작업 기록도 제공합니다. 제품은 무료 및 유료 요금제를 운영합니다. 페이지 자료에서는 생성된 음악을 로열티 프리로 설명하지만, 실제 상업적 이용 범위와 라이선스 조건 및 다운로드 제한은 현재 서비스 규정을 기준으로 확인해야 합니다.018.2
 Cartesia AIAI 오디오 도구Cartesia AI는 실시간 음성 상호작용을 위한 AI 오디오 도구로, 텍스트를 감정 변화, 호흡감, 웃음 등의 표현이 담긴 음성으로 변환하는 기능을 핵심으로 합니다. 사용자는 Playground에서 생성 결과를 테스트할 수 있으며, API 또는 SDK를 통해 음성 기능을 에이전트, 고객 서비스, 게임 및 기타 애플리케이션에 통합할 수도 있습니다. 플랫폼은 42개 이상의 언어를 지원하고, 즉시 복제부터 전문가 수준의 미세 조정까지 다양한 음성 복제 옵션을 제공합니다. 낮은 지연 시간의 음성 피드백이 필요한 개발자, 기업 및 콘텐츠 제작 팀에 적합합니다. 실제 결과는 텍스트, 언어, 감정 설정 및 오디오 샘플의 품질에 따라 달라질 수 있으므로, 도입 전에 목표 환경에서 테스트해야 합니다.088
 Audo StudioAI 오디오 도구Audo Studio는 녹음의 배경 소음, 에코 및 음량 변동을 개선하는 데 주로 사용되는 브라우저 기반 AI 오디오 처리 도구입니다. 소프트웨어를 설치하거나 복잡한 설정을 조정할 필요 없이 오디오를 업로드하면 자동 처리를 통해 소음 제거, 에코 제거 및 음량 균형 조정을 완료할 수 있으며, 결과물을 팟캐스트, 동영상 또는 온라인 강의 등의 콘텐츠 제작에 활용할 수 있습니다. 팟캐스트 제작자, 동영상 크리에이터, 온라인 강의 강사뿐 아니라 회의 녹음과 음성 메모를 가끔 정리해야 하는 개인 사용자에게도 적합합니다. 제품은 무료 및 유료 요금제를 제공하며, 구체적인 사용량이나 가격은 공식 페이지를 기준으로 확인해야 합니다. 처리 과정이 자동화에 중점을 두고 있어, 처리 매개변수를 세밀하게 제어해야 하는 경우에는 활용 범위가 제한될 수 있습니다.048.2
 DevoiceAI 오디오 도구Devoice는 음성 및 영상 처리를 위한 AI 도구로, 오디오 전사, 배경 소음 제거, 가사 생성 등의 기능을 제공합니다. 사용자는 회원가입 없이 MP3, WAV, M4A 또는 동영상 파일을 업로드하여 TXT, DOCX, SRT 등의 형식으로 변환할 수 있으며, 녹음에 포함된 배경 소음을 처리하거나 주제와 감정에 맞는 힙합 가사를 생성할 수도 있습니다. 학생의 강의 녹음 정리, 직장인의 회의 및 인터뷰 자료 처리, 1인 미디어 크리에이터·스트리머·음악인의 콘텐츠 제작에 적합합니다. 여러 언어 인식을 지원하며 파일 처리가 완료되면 파일이 자동으로 삭제되므로, 원본 파일을 장기간 온라인에 보관하거나 반복적으로 다시 가져와야 하는 작업 흐름에는 적합하지 않습니다.017.4
 CurseCutAI 오디오 도구CurseCut은 오디오 및 비디오 콘텐츠 검토를 위한 AI 도구로, 자료에 포함된 부적절한 발언을 자동으로 식별하고 사용자가 설정한 방식에 따라 음소거하거나 비프음을 삽입하거나 사용자 지정 음향 효과로 대체할 수 있습니다. 사용자는 필터 단어 목록을 만들고 처리 방식을 선택한 후 하나 이상의 파일을 가져와 처리할 수 있으며, 타임스탬프가 포함된 텍스트 기록으로 결과를 확인할 수 있습니다. 이 도구는 30개 이상의 언어를 지원하며 콘텐츠 제작자, 부모와 교육자, 기업 및 미디어 팀이 비디오, 팟캐스트, 라이브 방송 녹화본과 교육 자료를 정리하는 데 적합합니다. 처리 과정은 로컬 기기에서 완료되며 파일은 클라우드에 업로드되지 않습니다. 다만 필터 기준은 사용자가 직접 설정해야 하며, 자동 처리 결과는 게시하거나 사용하기 전에 다시 확인해야 합니다.038.5
 Azure AI SpeechAI 오디오 도구Azure AI Speech는 Microsoft Azure에서 제공하는 클라우드 AI 음성 서비스로, 애플리케이션이나 비즈니스 프로세스에 음성 기능을 통합하려는 개발 팀과 기업 사용자를 대상으로 합니다. 사용자는 API 또는 SDK를 통해 오디오를 처리하고, 음성을 텍스트로 변환하거나 콘텐츠를 번역하고, 텍스트를 음성으로 합성할 수 있습니다. 또한 화자 인식, 발음 평가 및 사용자 지정 모델을 결합해 보다 구체적인 작업을 수행할 수 있습니다. 이 서비스는 실시간 및 일괄 전사를 지원하며, 콜센터, 미디어 콘텐츠 처리, 언어 학습, 금융 및 의료 등 다양한 분야에 활용할 수 있습니다. 제공 범위는 넓지만 실제 도입을 위해서는 API 연동, 모델 구성 및 성능 테스트가 필요하며, 사용 가능한 할당량과 요금은 현재 Azure 서비스 정책을 기준으로 확인해야 합니다.018.5
 MelodyStudioAI 오디오 도구MelodyStudio는 멜로디 창작에 초점을 둔 AI 오디오 도구로, 사용자가 가사에서 출발해 부를 수 있는 멜로디를 탐색하도록 돕습니다. 가사를 입력하거나 붙여넣으면 가사 각 행의 음절 수를 분석하고, 행마다 여러 가지 멜로디 프레이즈를 생성합니다. 이후 코드 진행 제안과 함께 미리 듣고 선별할 수 있으며, 시각적 편집 화면에서 음표와 리듬을 조정한 다음 멜로디와 코드의 MIDI 파일을 내보낼 수 있습니다. 작사가·작곡가, 프로듀서, 가수 및 음악 초보자가 멜로디 구상을 발전시키거나 창작 자료를 정리하는 데 적합합니다. 생성 결과는 여전히 사용자의 판단과 수정이 필요하며, 후속 편곡은 일반적으로 음악 제작 소프트웨어를 활용해야 합니다.038.5
 ResembleAI 오디오 도구Resemble은 기업과 개발팀을 위한 AI 오디오 도구로, 음성 생성, 음성 복제, 음성 변환 및 딥페이크 탐지 기능을 제공합니다. 사용자는 오디오 샘플을 제공해 음성 모델을 만든 다음 텍스트 음성 변환 또는 음성 대 음성 변환으로 콘텐츠를 생성할 수 있으며, 실시간 음성 변환과 AI 오디오 편집으로 녹음 파일을 처리할 수도 있습니다. 또한 다국어 현지화와 AI 워터마크 등의 기능을 제공해 게임 및 엔터테인먼트, 지능형 고객 서비스, 애플리케이션 개발, 광고 및 마케팅 등 다양한 분야에 적합합니다. 실제 결과는 오디오 샘플의 품질, 대상 언어 및 구체적인 사용 방식에 따라 달라질 수 있으며, 다른 사람의 목소리를 사용할 때는 사용 허가와 관련 규정을 확인해야 합니다.037.3
 SoundfulAI 오디오 도구Soundful은 음악 생성과 음원 라이브러리 기능을 결합한 인공지능 오디오 도구로, 사용자에게 배경 음악 소재를 제공합니다. 사용자는 먼저 장르, 리듬, 분위기 또는 테마를 선택한 다음 트랙을 생성하고, 필요에 따라 다운로드하거나 계속 편집할 수 있습니다. 플랫폼에는 음악 크리에이터가 공유한 인공지능 음악도 포함되어 있습니다. EDM, Deep House, Hip Hop 등 다양한 스타일을 제공하며, 콘텐츠 크리에이터, 음악 제작자, 브랜드 및 기업, 개인 음악 애호가가 동영상, 팟캐스트, 라이브 방송, 광고, 게임 또는 개인 창작에 활용할 수 있습니다. 일부 요금제는 MP3, WAV 등의 오디오 다운로드와 STEM 스템 분리 파일 및 MIDI 파일 등 추가 제작 기능을 지원합니다. 플랫폼은 무료 및 유료 방식을 제공하며, 구체적인 다운로드 권한과 사용 가능한 기능은 요금제에 따라 다를 수 있으므로 정식 상업적 이용 전 해당 라이선스 약관을 확인해야 합니다.058
 DubbingX 지성 클라우드 더빙AI 오디오 도구DubbingX 지성 클라우드 더빙은 텍스트 더빙, 음색 복제, 음성 또는 노래 변환에 주로 사용되는 인공지능 오디오 도구입니다. 사용자는 웹 버전, 데스크톱 클라이언트, Mac 버전 또는 WeChat 미니 프로그램에서 텍스트를 입력하고 음색과 감정을 선택한 뒤, 말하기 속도, 억양, 다중 발음 문자 및 멈춤 등의 매개변수를 추가로 조정할 수 있습니다. 기업은 API를 통해 관련 기능을 연동할 수도 있습니다. 이 제품은 게임, 애니메이션, 영화 및 영상, 숏폼 드라마, 오디오북, 팟캐스트, 가상 인간, 스마트 하드웨어 및 광고 콘텐츠 제작 등의 분야에 활용됩니다. 플랫폼은 무료 및 유료 방식을 제공하며, 공식 음색은 상업적 사용 허가를 취득한 것으로 안내되어 있습니다. 직접 업로드한 오디오를 사용해 복제할 경우에는 샘플의 출처와 관련 허가를 반드시 확인해야 합니다.048.5
 MuseNetAI 오디오 도구MuseNet은 OpenAI가 출시한 AI 음악 생성 모델로, Transformer 아키처를 기반으로 대량의 MIDI 음악 파일을 학습해 화성, 리듬, 스타일 변화가 포함된 음악을 생성합니다. 사용자는 간단한 모드에서 미리 생성된 조합을 감상하거나, 고급 모드에서 하나의 음표로 시작해 모델이 음악 구간을 완성하도록 단계적으로 유도할 수 있습니다. 이 도구는 다양한 클래식, 팝 및 일반적인 음악 장르의 모방과 융합을 지원하며, 최대 10가지 악기의 합주를 지정할 수 있습니다. 음악 창작자, 음악 감독, 교육자, 연구자 및 음악 애호가가 영감 탐색, 편곡 보조, 교육 시연, 배경 음악 초안 제작 등에 활용하기에 적합합니다. 생성된 콘텐츠는 여전히 사람이 선별하고 조정해야 하며, 완전한 작곡, 편곡 및 제작 과정을 대체할 수 없습니다.048.1
 NeverCapAI 오디오 도구NeverCap은 오디오 또는 비디오를 텍스트로 변환하고 전사 내용을 여러 언어로 번역하는 데 주로 사용하는 AI 오디오 도구입니다. 사용자는 MP3, MP4 등의 파일을 업로드할 수 있으며, 한 번에 최대 50개 파일을 처리할 수 있습니다. 파일 하나의 길이는 최대 10시간 또는 5GB 이하이며, 처리 후 PDF, Word 또는 SRT 형식으로 내보낼 수 있습니다. 100개 이상의 언어를 인식하고 콘텐츠를 249개 언어로 번역할 수 있으며, 화자 식별, 문장 부호 및 문단 정리 기능도 제공합니다. 팟캐스트 제작, 동영상 자막, 인터뷰 정리, 학술 연구 및 강의 기록에 적합합니다. 실제 결과는 억양, 소음, 여러 사람의 동시 발화 및 전문 용어의 영향을 받을 수 있으므로 중요한 내용은 내보내기 전에 교정해야 합니다.087.5
 DiffRhythmAI 오디오 도구DiffRhythm은 중국 시베이공업대학교 ASLP 연구실에서 개발한 AI 노래 생성 모델로, 잠재 확산 모델을 사용하며 음악 데모, 배경 음악을 빠르게 제작하거나 모델 연구를 진행하려는 창작자와 개발자를 대상으로 합니다. 사용자가 가사와 스타일 프롬프트를 입력하면 보컬과 반주가 포함된 완성된 노래를 생성할 수 있으며, 한 번에 최대 약 4분 45초 길이의 결과를 생성하고 중국어와 영어 노래를 지원합니다. 이 프로젝트는 오픈 소스 모델과 추론 코드를 제공하므로 체험, 연구 및 2차 개발에 적합합니다. 생성 결과는 여전히 사람이 선별하고 수정하거나 후반 작업을 진행해야 할 수 있으며, 실제 결과는 가사와 스타일 프롬프트의 영향을 받습니다.018.5
 SAM AudioAI 오디오 도구SAM Audio는 Meta가 선보인 AI 오디오 분할 도구로, 혼합 녹음이나 동영상 음성에서 지정한 음원을 추출합니다. 사용자는 자연어로 원하는 소리를 설명하거나, 동영상 화면에서 관련 물체를 클릭하거나, 처리할 시간 구간을 표시한 후 해당 분리 결과를 얻을 수 있습니다. 동영상 제작자, 음악 프로듀서, 팟캐스트 및 오디오 콘텐츠 제작자, 오디오 이해 연구를 수행하는 연구자에게 적합하며, 보컬, 악기, 환경음 및 기타 특정 소리를 추출하는 데 사용할 수 있습니다. 현재 무료이며 운영 중인 제품으로 표시되어 있습니다. 실제 결과는 녹음 환경, 음원 간 중첩 정도, 프롬프트 설명의 정확성에 영향을 받으며, 복잡한素材는 여전히 수동 검토와 후반 작업이 필요합니다.038.4
 만상유성AI 오디오 도구만상유성은 오디오 콘텐츠 크리에이터를 위한 인공지능 오디오 도구로, 대본 편집, 더빙 녹음, 오디오 편집, 대사 싱크 조정, 완성본 검수 등의 작업을 지원합니다. 사용자는 긴 텍스트를 장별로 정리하고, 등장인물을 추출해 캐릭터 프로필을 생성한 뒤 녹음 및 편집 워크스테이션에서 오디오를 제작할 수 있습니다. 마지막으로 검수 기능을 사용해 오디오와 원고의 일치 여부를 확인할 수 있습니다. 오디오 제작 스튜디오, 팟캐스트 및 1인 미디어 크리에이터, MCN 기관, 오디오 드라마 애호가에게 적합하며, 자동 생성과 수작업이 결합된 제작 방식도 지원합니다. 일부 내용은 여전히 수동 검수가 필요하며, 특히 캐릭터 표현, 감정 처리, 난해한 한자의 발음, 최종 완성도에 대한 확인이 필요합니다.058.1
 TopMediaiAI 오디오 도구TopMediai는 텍스트를 음성으로 변환하고, 음악을 생성하며, 음성을 복제하고 AI 노래 커버를 제작하는 데 주로 사용되는 AI 오디오 도구입니다. 동영상 생성 관련 기능도 제공합니다. 사용자는 텍스트, 가사 또는 창작 설명을 바탕으로 음성이나 음악 효과를 선택해 더빙, 노래 및 기타 멀티미디어 소재를 생성할 수 있습니다. 이 플랫폼은 동영상 크리에이터, 게임 개발자, 마케팅 담당자, 팟캐스트 제작자 및 교육 종사자 등을 대상으로 합니다. 자료에 따르면 무료 및 유료 사용을 지원하며 현재 운영 중입니다. 실제 결과물은 발음, 감정 표현 및 콘텐츠 적합성을 사람이 확인해야 하며, 음성 복제, 노래 커버 또는 공개 시에는 관련 권한을 확인해야 합니다.028
 Online AudioAI 오디오 도구Online Audio는 브라우저에서 사용할 수 있는 온라인 오디오 변환 도구로, 오디오 및 동영상 파일을 처리해야 하는 개인 사용자, 콘텐츠 제작자와 사무직 사용자를 대상으로 합니다. 파일을 업로드한 후 출력 형식을 선택하고 비트레이트, 샘플레이트, 채널 등의 매개변수를 조정한 다음 변환 결과를 다운로드할 수 있습니다. 여러 파일을 한 번에 처리하고 ZIP으로 압축할 수도 있습니다. 이 도구는 300가지가 넘는 파일 형식을 지원하며, 동영상에서 오디오 트랙을 추출할 수 있고 태그 편집 및 일부 오디오 효과도 제공합니다. 형식 호환성 문제, 자료 정리 및 간단한 오디오 편집 등의 작업에 적합합니다. 파일을 웹페이지에 업로드하여 처리하므로 사용 시 네트워크 상태와 파일 크기를 고려해 작업을 계획해야 합니다.027.3
 Lyria2AI 오디오 도구Lyria2는 Google DeepMind가 출시한 AI 음악 생성 모델로, 음악 프로듀서, 작곡가, 개발자, 콘텐츠 제작자 및 음악 애호가를 대상으로 합니다. 사용자는 가사나 텍스트 프롬프트를 입력하고 템포, 조성, 악기, 분위기, Intro와 Outro 등의 구조 매개변수를 설정하여 기악과 보컬이 포함된 곡을 생성할 수 있습니다. 개발자는 Lyria RealTime API를 통해 연속적인 음악 스트림을 생성할 수도 있습니다. 생성 오디오는 48kHz 스테레오이며 SynthID 워터마크가 내장됩니다. 영감 탐색, 곡 데모, 영상 배경음악 및 애플리케이션 프로토타입 제작에 적합하지만, 생성 결과는 특히 가사 표현, 편곡 세부 사항 및 보컬 효과에 대해 사람이 확인하고 후작업해야 합니다.047.7
 NarakeetAI 오디오 도구Narakeet은 텍스트, 문서 또는 슬라이드 콘텐츠를 음성 해설이 포함된 동영상과 오디오로 변환할 수 있는 온라인 인공지능 오디오 도구입니다. 사용자는 대본을 직접 입력하거나 PowerPoint, Google Slides 등의 파일을 업로드할 수 있으며, 시스템이 콘텐츠를 추출해 음성 해설 영상을 생성하므로 녹음과 수동 동기화 작업을 줄일 수 있습니다. 100개 언어와 900개 이상의 인공지능 음성을 지원하며, 교육자, 교육 담당자, 마케팅 담당자, 1인 미디어 제작자 및 개발팀을 대상으로 합니다. API를 통해 자동화된 워크플로에도 연동할 수 있습니다. 자료에 따르면 무료 및 유료 요금제를 제공하지만, 실제 사용 시에는 발음, 말투, 타임라인 및 완성된 결과물을 확인해야 합니다.057.8
 더거 더빙AI 오디오 도구더거 더빙은 숏폼 동영상 크리에이터를 위한 AI 오디오 도구로, 주로 텍스트 원고를 더빙 음성으로 변환하고 다중 캐릭터 대화, 음성 분리, 원고 추출 등의 작업을 지원합니다. 사용자는 대본 원고를 입력하거나 추출한 뒤 음색을 선택하고, 말하기 속도, 억양, 감정을 조정한 다음 생성된 오디오를 미리 듣고 수정할 수 있습니다. 이 도구는 스토리 해설, 감성 문구, 광고 내레이션, 온라인 교육, 오디오 콘텐츠 등의 장면을 지원하며, 사투리, 어린이 목소리 또는 다양한 캐릭터 음성이 필요한 개인 크리에이터와 소규모 팀에도 적합합니다. 플랫폼은 무료 및 유료 방식을 함께 제공합니다. 실제 사용 시 복잡한 문맥, 동음이의어 발음, 감정 표현은 사람이 직접 들어 보고 교정하는 것이 좋습니다.067.6
 ListenHubAI 오디오 도구ListenHub는 웹페이지 링크, PDF, Word, TXT 등의 문서 자료나 사용자가 입력한 텍스트 아이디어를 구조화된 팟캐스트 스크립트로 정리하고, 1인 낭독 또는 2인 대화 형식의 오디오 콘텐츠를 생성하는 AI 오디오 도구입니다. 지식 콘텐츠 제작자, 1인 미디어 운영자, 직장인, 학생, 청각 학습자, 기업 교육 및 마케팅 팀을 위해 영상 동화 제작 기능도 제공합니다. 사용자는 일반적으로 자료를 입력한 후 콘텐츠 분석, 스크립트 생성, 음성 연출 과정을 거쳐 청취하거나 공유할 수 있는 콘텐츠를 제작합니다. 무료 및 유료 요금제를 지원하지만, 생성 결과는 원문 정확성, 표현 방식 및 사용 목적에 따라 직접 검토하고 조정해야 합니다.038.6
 MusicFXAI 오디오 도구MusicFX는 Google AI 실험실에서 선보인 실험적인 AI 오디오 도구로, MusicLM을 기반으로 사용자가 스타일, 분위기 또는 장면을 텍스트로 설명하면 음악 클립으로 변환합니다. 사용자는 프롬프트를 입력해 결과를 생성할 수 있으며, DJ 모드에서는 여러 프롬프트를 동시에 추가하고 각 설명의 혼합 비중을 실시간으로 조정할 수도 있습니다. 최대 70초의 재생 시간 설정과 반복 재생을 지원해 콘텐츠 제작자, 음악 애호가, DJ 및 개발자가 영감 탐색, 배경 음악 초안 제작, 개념 검증 등에 활용하기 좋습니다. 다만 주로 클립 생성에 초점을 둔 도구이며, 짧은 출력 시간과 실험적인 성격 때문에 완전한 편곡, 제작 및 후반 작업 과정을 직접 대체할 수는 없습니다. 생성 콘텐츠를 실제로 사용하려면 구체적인 사용 상황에 따른 검토가 필요합니다.038.5
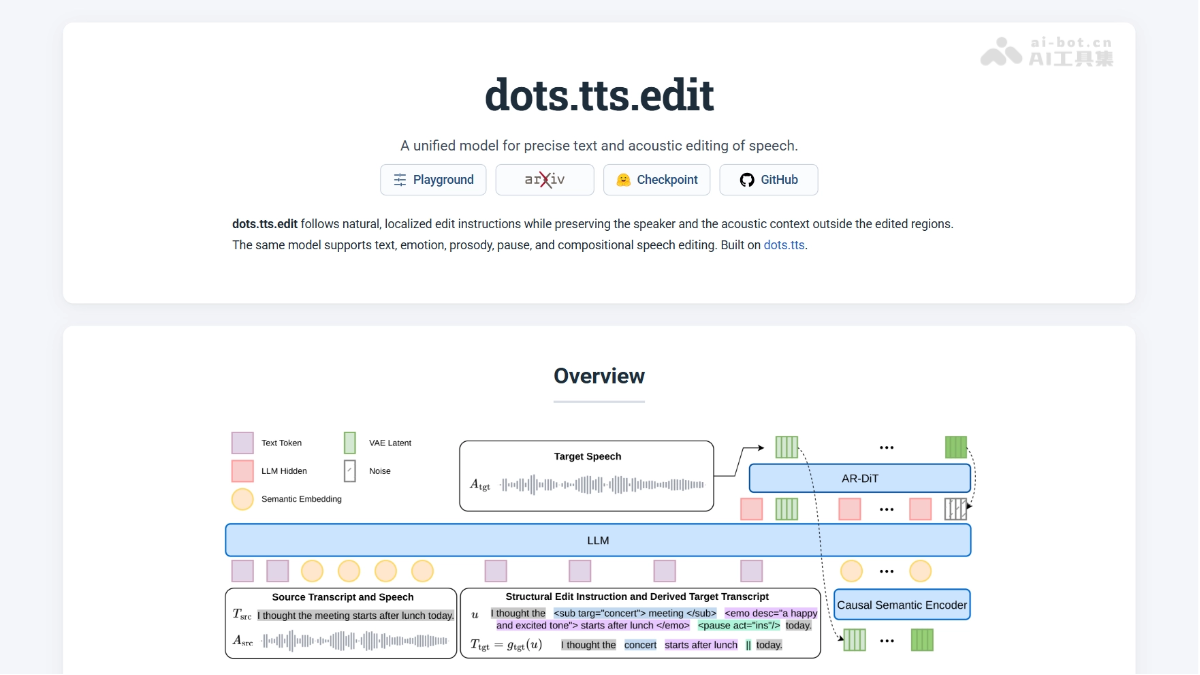 dots.ttsAI 음성 합성dots.tts는 샤오홍슈 dots 팀과 상하이교통대학교 X-LANCE 연구실이 공동 오픈소스한 20억 파라미터 규모의 완전 연속 자기회귀 음성 합성 기반 모델입니다. 모델은 연속 잠재 공간에서 48kHz 오디오를 블록 단위로 직접 생성하며, ...00
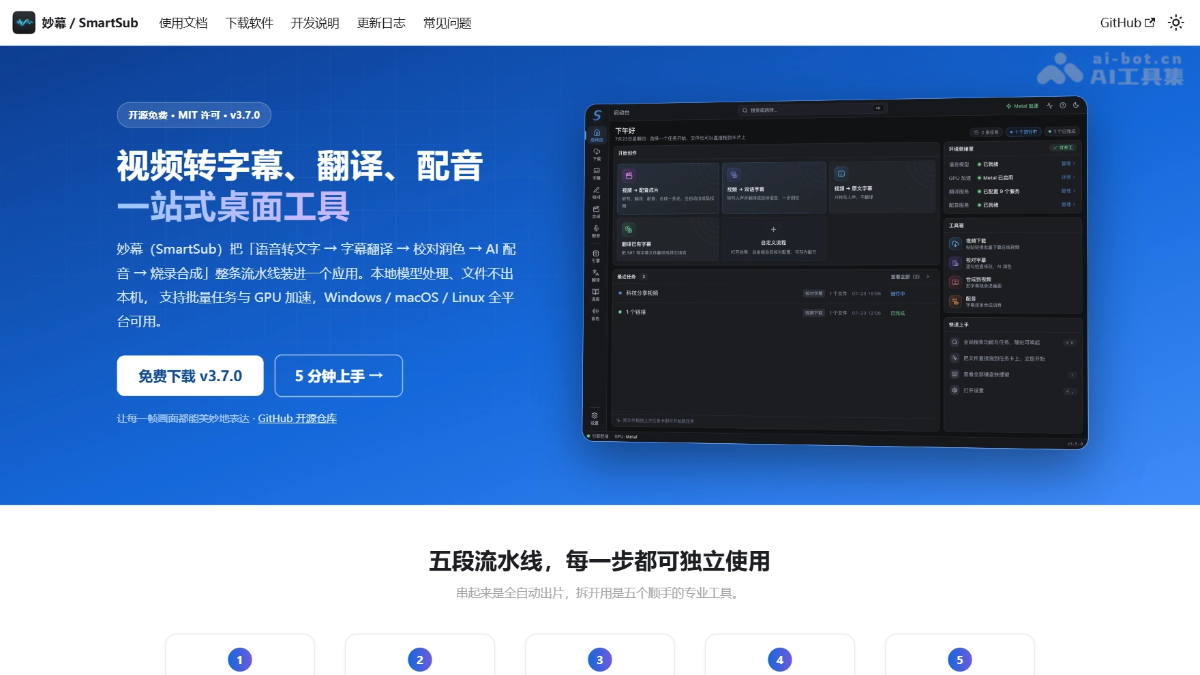 SmartSub – 오픈 소스 올인원 오디오·비디오 자막 처리 데스크톱 도구AI 음성 인식SmartSub(妙幕)는 오픈 소스 올인원 오디오·비디오 자막 처리 데스크톱 도구입니다. 전체 작업 과정을 하나의 애플리케이션으로 통합했으며, Whisper, FunASR, Qwen3-ASR 등의 로컬 모델을 기반으로 오프라인 음성 인식을 지원합니다. 20가지 이상의 번역 서비스와 다중 화자 AI 더빙을 제공하며, Bilibili, YouTube 등 플랫폼과 호환되는 온라인 동영상 다운로더를 내장하고 있습니다. NVIDIA CUDA, Apple Core ML 등의 하드웨어 가속을 지원하며 Windows, macOS, Linux 세 플랫폼에서 로컬로 실행됩니다.00
 Hy ASR 3.0 preview – 텐센트 혼위안이 출시한 차세대 음성 인식 모델AI 음성 인식Hy ASR 3.0 preview – 텐센트 혼위안이 출시한 차세대 음성 인식 모델은 Hy3 대규모 언어 모델을 기반으로 한 차세대 음성 인식 시스템으로, 고정밀 음성 인식과 심층 의미 이해를 결합합니다. 중국어, 영어, 광둥어 및 10개 주요 방언 지역을 지원하며, 문맥 기반 지능형 교정, 핫워드 주입, 고소음·속삭임 등 복잡한 환경에서의 강건성을 갖추고 있습니다. 오픈 소스 평가 세트의 WER은 약 3%로 유지되며, 자체 평가 세트에서는 경쟁 제품을 전반적으로 앞섭니다. 이 모델은 지능형 고객 서비스, 콘텐츠 제작, 음성 검색, 업무 협업 및 스마트 단말기 등의 시나리오에 적합하며, 텐센트 클라우드 API를 통해 연동하거나 텐센트 위안바오에서 무료로 체험할 수 있습니다.00
 IndexTTS-2.5AI 음성 합성IndexTTS-2.5는 Bilibili가 오픈 소스로 공개한 산업级 제로샷 음성 복제 모델로, 매개변수规模는仅 0.8B이며 중국어, 영어, 일본어, 스페인어, 아랍어 5개 언어 간 음성 전이를 지원합니다.00
이 카테고리의 모든 도구가 표시됩니다.